


Python Pandas核心指南:Series与DataFrame创建、索引切片及缺失值处理

本文详解Python中Pandas库的核心用法,涵盖Series与DataFrame的创建及属性。重点讲解通过loc和iloc进行数据索引切片,结合布尔索引筛选特定数据,并深入剖析NaN与0值等缺失数据的删除与填充策略,助力高效数据分析。
Pandas简介与核心优势
引入
虽然NumPy已能处理数据并结合Matplotlib解决部分分析需求,但Pandas的学习目标更为明确。NumPy主要擅长处理数值型数据,而在实际场景中,数据往往包含字符串、时间序列等非数值类型。例如,通过爬虫从数据库获取的数据,或如YouTube案例中除了数值外还涉及国家、视频分类标签及标题等信息。因此,Pandas在NumPy处理数值的基础上,进一步扩展了对其他类型数据的支持能力。
什么是pandas?
Pandas是一个Python软件包,提供快速、灵活且富有表现力的数据结构,旨在使使用“关系”或“标记”数据变得简单直观。它被设计为Python中进行实际、真实世界数据分析的高级基础构建块。此外,其更广泛的目标是成为任何语言中可用最强大、最灵活的开源数据分析/操作工具,目前正朝着这一目标稳步迈进。
pandas的常用数据类型
1、Series 一维,带标签数组
2、DataFrame 二维,Series容器
Series数据结构详解
(1)Series创建
pandas.Series(data=None, index=None, dtype=None, name=None, copy=False, fastpath=False)data参数:类数组、可迭代对象、字典或标量值,用于存储Series中的数据。注意:在0.23.0版本中进行了更改,如果data是字典,则对于Python 3.6及更高版本,将维护参数顺序。
index参数:类数组或索引(1d)值,必须是可散列的,且长度与data相同。允许使用非唯一索引值。若未提供,默认使用RangeIndex(0, 1, 2, …, n)。如果同时使用了字典和索引序列,索引将覆盖字典中找到的键。
dtype参数:STR,numpy.dtype,或ExtensionDtype,可选。
输出Series的数据类型。若未指定,将从data中推断得出。
copy参数:bool,默认为False,用于控制是否复制输入数据。
import pandas as pd
import numpy as np
t = pd.Series(np.arange(12),index= list("asdfghjklpoi"))
print(t)
print(type(t))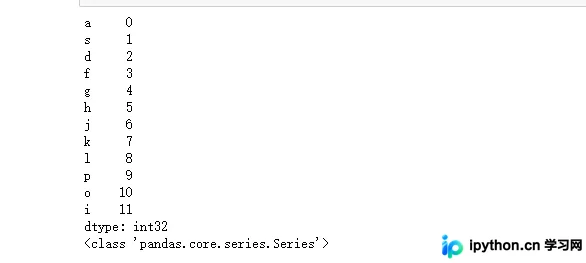
需关注几个关键点:pd.Series的功能及其能接受的数据类型转换;index的定义、位置及其在常见数据库数据或ndarray中的含义;以及如何为数据指定index。
c = {"name":"lishuntao","age":18,"gender":"boy"}
t1 = pd.Series(c)
print(t1)
print(type(t1))
print(t1["name"])
print(t1["gender"])
由上可知,通过字典创建Series时,字典的键即作为索引。
重新绑定其他索引后,若能对应则取值,若不能对应则显示为NaN。如图所示:
import numpy as np
import pandas as pd

a = {"a":12,"name":"lishuntao","c":"xiaoc","age":18,"gender":"man"}

t1 = pd.Series(a)
print(t1)
print(type(t1))
t2 = pd.Series(a,index=list("abcdf"))
print(t2)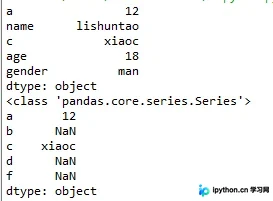
NumPy中的nan为float类型,Pandas会根据数据类型自动更改Series的dtype类型。
Series切片和索引
import numpy as np
import pandas as pd

a = {"a":12,"name":"lishuntao","c":"xiaoc","age":18,"gender":"man"}

t1 = pd.Series(a)
print(t1)
print(t1[:2])
print(t1[1])
print(t1[["a","c","gender"]])
print(t1[0:5:2])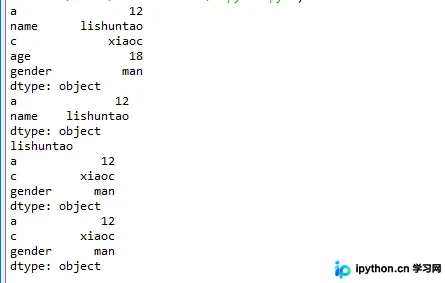
import numpy as np
import pandas as pd

a = np.arange(12)
t1 = pd.Series(a)
print(t1)
print(t1[t1>9])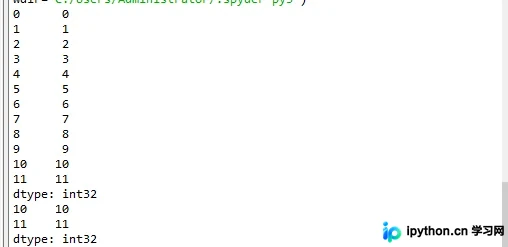
Series的索引和值
import numpy as np
import pandas as pd

a = np.arange(12)
t1 = pd.Series(a)
#print(t1)
print(t1.index)
print(t1.values)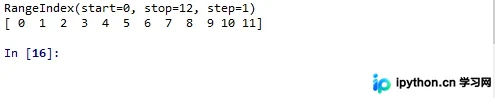
import numpy as np
import pandas as pd

a = np.arange(12)
t1 = pd.Series(a)
print(t1)
print(type(t1.index))
print(type(t1.values))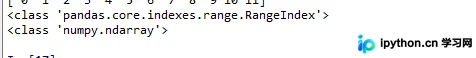
Series对象本质上由两个数组构成:一个构成对象的键(index,索引),另一个构成对象的值(values),形成键到值的映射。
ndarray的许多方法也可应用于series类型,例如argmax、clip等。
series具有where方法,但其结果与预期可能不同(见下方官方文档说明)。
Series.where(self,cond[,other,inplace,…])Replace values where the condition is False.
a = np.arange(12)
t1 = pd.Series(a)
print(t1)
#替换条件是False的情况 下面两个结果一样
print(t1.where((t1>8),1))
print(pd.Series.where(t1,(t1>4),1))
外部数据读取与DataFrame创建
pandas之读取外部数据
假设我们有一组关于狗名字的统计数据,为了观察这组数据的情况,我们应该怎么做呢?
数据来源:https://www.kaggle.com/new-york-city/nyc-dog-names/data
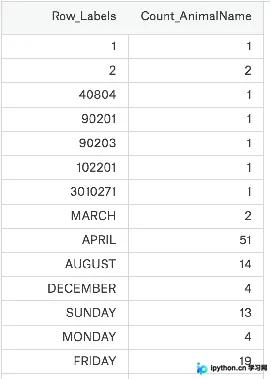
这组数据存储在csv文件中,我们可以直接使用pd.read_csv进行读取。
import numpy as np
import pandas as pd
t2 = pd.read_csv("F:\BaiduNetdiskDownload\youtube_video_data\dogNames2.csv")
print(t2)
print(type(t2))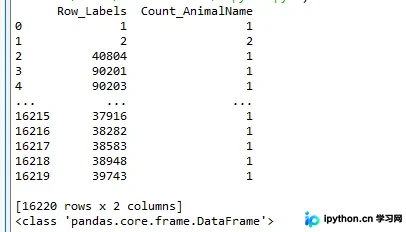
与预期略有不同,返回结果是一个DataFrame,接下来我们将详细了解这种数据类型。
但是,还有一个问题:
对于MySQL或MongoDB等数据库中的数据,我们该如何使用呢?
pd.read_sql(sql_sentence,connection)
那么,MongoDB如何处理呢?(先使用MongoDB自身工具读取数据,然后将其传入DataFrame中,即可实现读取)。
(2)DataFrame的创建
pd.DataFrame(data,index,columns,dtype,copy)
参数比Series多了columns,从中可以看出这是列索引(Index or array-like Column labels to use for resulting frame. Will default to RangeIndex (0, 1, 2, ..., n) if no column labels are provided)。
import numpy as np
import pandas as pd
t2 = pd.DataFrame(np.arange(12).reshape(3,4))
print(t2)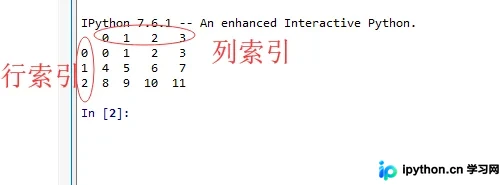
由上可知,DataFrame对象既包含行索引,又包含列索引。
行索引:表明不同行,横向索引,称为index,对应0轴,axis=0。
列索引:表明不同列,纵向索引,称为columns,对应1轴,axis=1。
自定义索引标签:
t2 = pd.DataFrame(np.arange(12).reshape(3,4),index=list("abc"),columns=list("WXYZ"))
print(t2)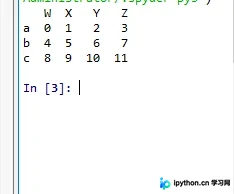
DataFrame的基础属性
t2 = pd.DataFrame(np.arange(12).reshape(3,4),index=list("abc"),columns=list("WXYZ"))
print(t2)
print(t2.shape)#显示行数,列数
print(t2.dtypes)#显示的是列数据类型
print(t2.ndim)#数据维度2(0,1)
print(t2.index)#行索引
print(t2.columns)#列索引 Index(['W', 'X', 'Y', 'Z'], dtype='object')
print(t2.values)#对象值,二维ndarray的数组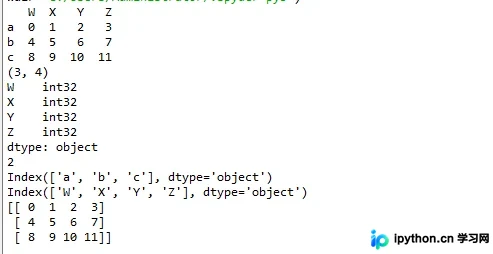
DataFrame整体情况查询
t2 = pd.DataFrame(np.arange(12).reshape(3,4),index=list("abc"),columns=list("WXYZ"))
print(t2)
#print(t2.head())
print(t2.head(1))#显示头几行,默认5行
print(t2.tail(2))#显示末尾几行,默认5行
print(t2.info())#相关信息浏览:行数,列数,列索引,列非空值个数,列类型,列类型,内存占用
print(t2.describe())#快速综合统计结果:计数,均值,标准差,最大值,四分位数,最小值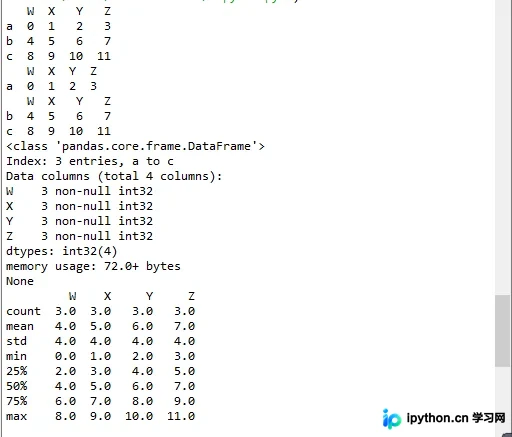
动手:回到之前我们读取的狗名字统计数据,我们尝试应用刚才介绍的方法。
那么问题来了:
肯定想知道使用次数最高的前几个名字是什么呢?
pd.DataFrame.sort_values(by="Count_AnimalName",ascending=False)#ascending=True升序排序 by是对那一列排序 输入列索引键
t2 = pd.read_csv("F:\BaiduNetdiskDownload\youtube_video_data\dogNames2.csv")
print(t2)

t3 = t2.sort_values(by="Count_AnimalName",ascending=False)
print(t3)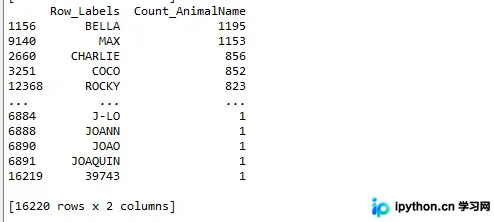
那么问题又来了:
如果数据有10列,我想按照其中的第1、第3、第8列进行排序,该怎么办?
数据索引、切片与布尔筛选
pandas之取行或者列
刚才我们知道了如何按某一行或某一列排序,现在想单独研究使用次数前100的数据,应该如何操作?
t2 = pd.read_csv("F:\BaiduNetdiskDownload\youtube_video_data\dogNames2.csv")
print(t2)

t3 = t2.sort_values(by="Count_AnimalName",ascending=False)
print(t3[:100])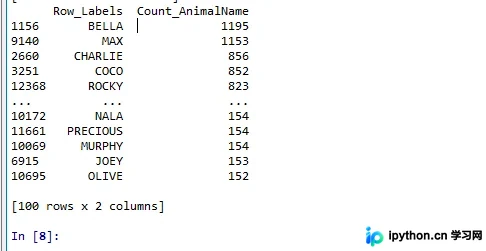
我们具体要选择某一列该怎么选择呢?t2[" Count_AnimalName "]
我们要同时选择行和不同列该怎么办?(方法与NumPy类似)。
pandas之loc取行数据
1、t2.loc 通过标签索引行数据(标签)。
print(t2.loc["a","W"])
print(t2.loc["a",["W","Y"]])
print(type(t2.loc["a",["W","Y"]]))
print(t2.loc[["a","b"],["Z","Y"]])
print(t2.loc[:"c",:"Y"])
print(t2.loc["a":"b",["W","Z"]])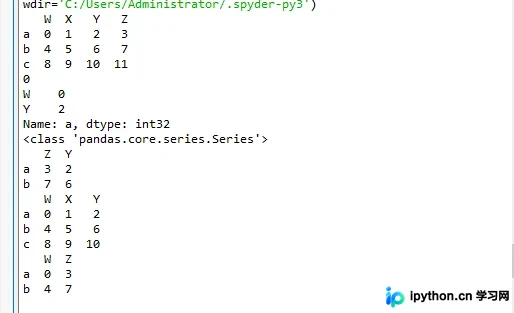
2、t2.iloc 通过位置获取行数据(位置)。
import numpy as np
import pandas as pd

t2 = pd.DataFrame(np.arange(12).reshape(3,4),index=list("abc"),columns=list("WXYZ"))
print(t2)
print(t2.iloc[0:2,0:4])
print(t2.iloc[[0,2],[1,3]])
t2.loc["a","Y"] = 100 #复制操作
print(t2)
t2.iloc[1:2,[1]] = 1000 #复制操作
print(t2)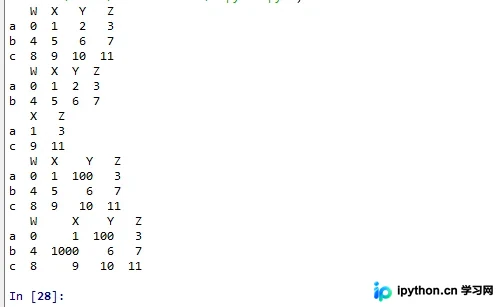
pandas之布尔索引(且,或,&,|,)
回到之前狗的名字的问题上,假如我们想找到所有使用次数超过800的狗的名字,应该怎么选择?
print(t2[t2["Count_AnimalName"]>800])回到之前狗的名字的问题上,假如我们想找到所有使用次数超过700并且名字字符串长度大于4的狗的名字,应该怎么选择?
print(t2[(t2["Row_Labels"].str.len()>4)&(t2["Count_AnimalName"]>700)])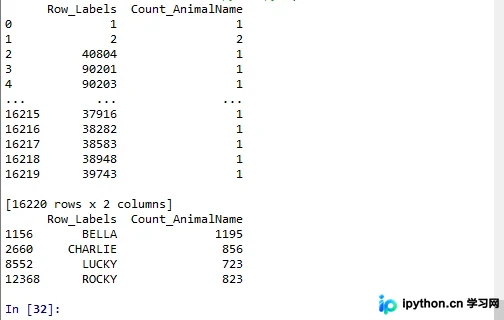
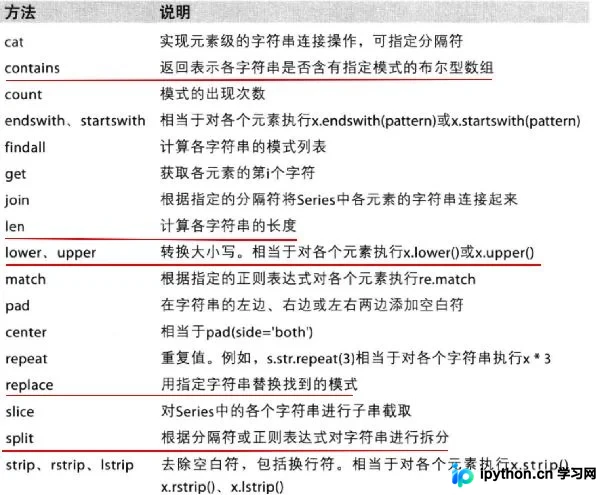
pandas之字符串方法
缺失数据处理策略
缺失数据的处理:
观察这组数据
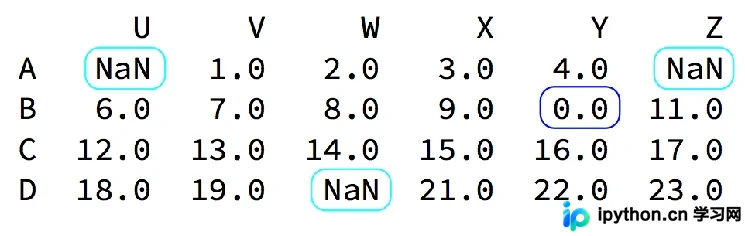
我们的数据缺失通常有两种情况:一种是空值,如None等,在Pandas中表现为NaN(与np.nan相同);另一种是我们将其设为0(蓝色框中所示)。
对于NaN的数据,在NumPy中我们是如何处理的?
在Pandas中处理起来非常容易。判断数据是否为NaN:pd.isnull(df), pd.notnull(df)。
处理方式1:删除NaN所在的行列。
dropna (axis=0, how='any', inplace=False)
处理方式2:填充数据。
t.fillna(t.mean()),t.fiallna(t.median()),t.fillna(0)
处理为0的数据:t[t==0]=np.nan。当然,并非每次为0的数据都需要处理。在计算平均值等情况时,NaN不参与计算,但0会参与。
import numpy as np
import pandas as pd

t2 = pd.DataFrame(np.arange(12).reshape(3,4),index=list("abc"),columns=list("WXYZ"))
#print(t2)
t2.loc[:"b",["W","Y"]] = np.nan
print(t2)
print(pd.isnull(t2))
print(pd.notnull(t2))
#print(t2.dropna(axis=0,how="all",inplace=False))
#any只要含NaN就删除前面规定的行列,all需要的是行列全部为NAN才能删除
#填充数据
#print(t2.fillna(t2.mean()))
print(t2)
print(t2.fillna(t2.median()))
print(t2.fillna(0))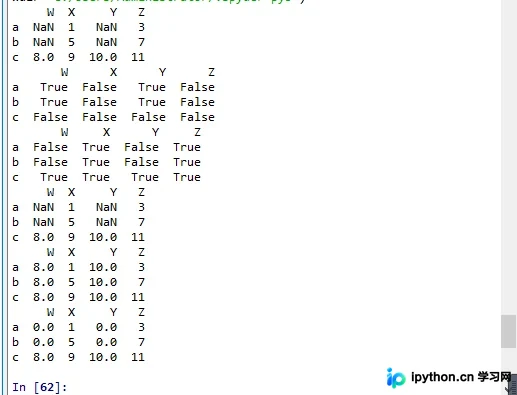
总结
以上所述是小编给大家介绍的Python 中pandas索引切片读取数据缺失数据处理问题,希望对大家有所帮助,如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对本站网站的支持! 如果你觉得本文对你有帮助,欢迎转载,烦请注明出处,谢谢!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















