


Python爬虫爬取Bilibili弹幕过程解析

本文解析使用Python抓取B站弹幕的技术流程。针对B站数据异步加载特性,通过浏览器开发者工具定位包含oid的XML请求接口。利用正则表达式从视频页面解析cid和aid,构造API请求获取弹幕文件。文章提供完整代码示例,展示如何从视频链接到最终获取弹幕数据的完整步骤。
B站弹幕加载机制分析
首先探讨一个常见问题:单个B站视频最多可能包含多少条弹幕?
热门视频可能拥有约2000条甚至更多的弹幕。鉴于数据量较大,B站通常不会将弹幕数据直接绑定在视频页面中。
例如,访问视频地址https://www.bilibili.com/video/av67946325,直接使用requests.get请求该URL,返回内容中并不包含弹幕数据。参考此前关于携程异步加载数据的分析,B站的弹幕加载机制同样采用先加载视频界面,再通过异步方式填充弹幕数据的策略。
定位弹幕API接口
接下来,我们可以利用火狐浏览器(建议同时熟悉Firefox和Chrome控制台,因为某些被Chrome插件拦截的请求在Firefox中仍可捕获,反之亦然)的开发者工具来监控网络请求。
经过详细排查,发现一个请求XML文件的接口,其URL后跟随一个oid参数。检查该接口的响应内容,确认其即为弹幕文件。
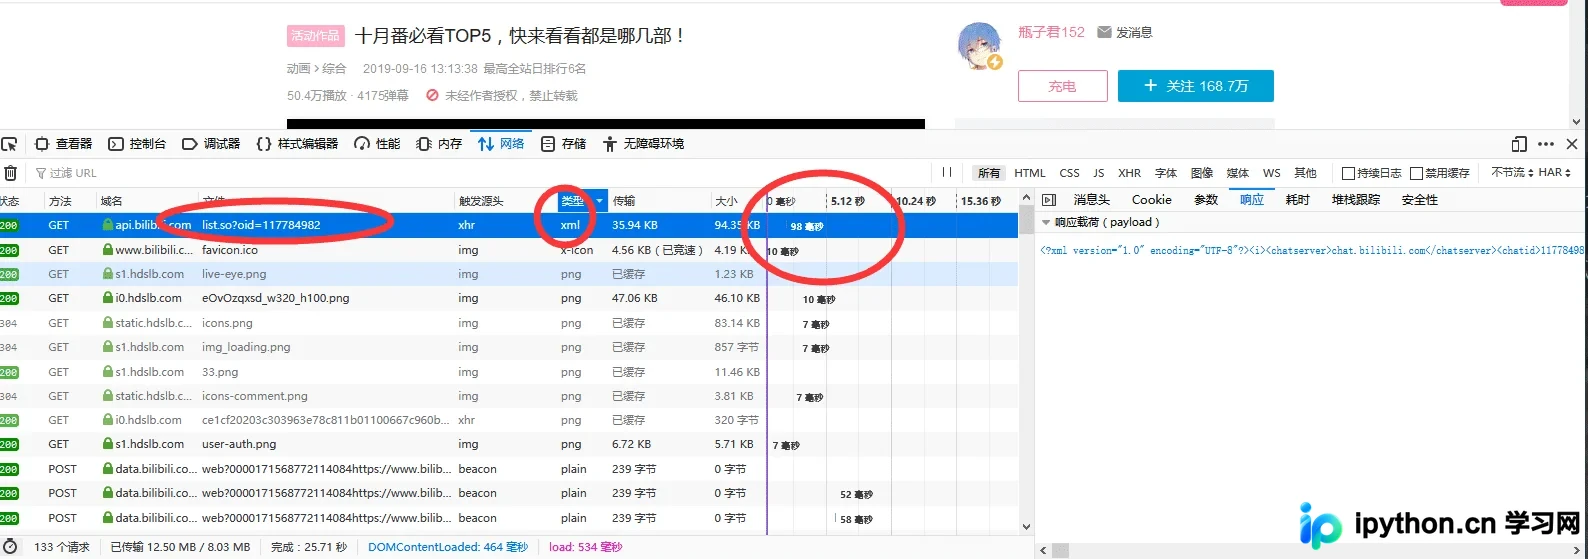
该请求的响应时间仅为98毫秒,远快于其他几个响应。由此推断,若将弹幕数据直接嵌入视频页面,将会严重影响用户体验。
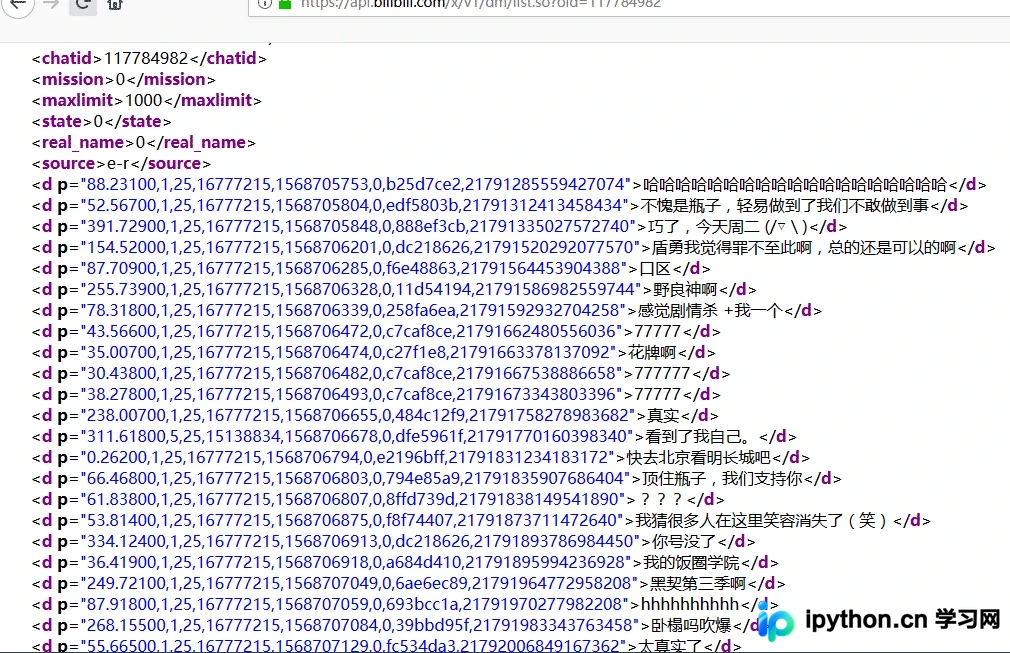
既然已定位到弹幕接口,爬取过程看似简单。但我们的目标是爬取特定av号视频的弹幕,而非随意使用某个oid爬取,否则无法确认获取的弹幕属于哪个具体视频。
我们可以复制oid值117784982,在视频页面进行搜索验证。通过视频链接获取其对应的oid,再利用该oid请求xml弹幕文件,这一流程更为便捷。
此次使用谷歌浏览器,通过搜索oid值,确实成功找到了相关数据。
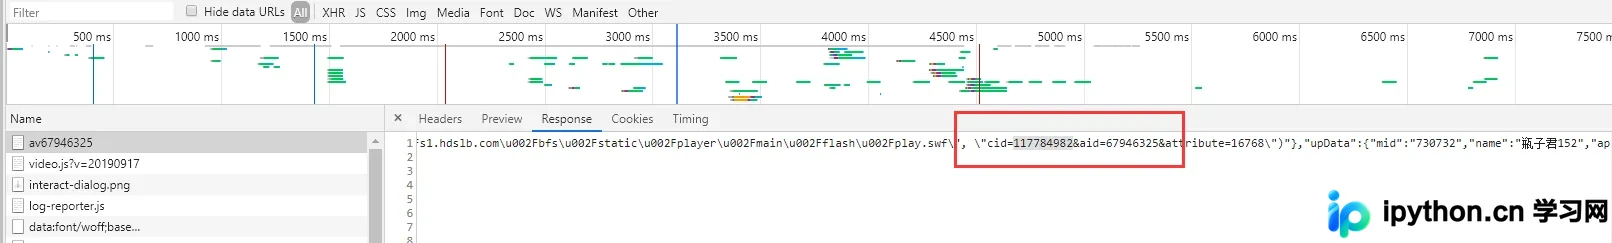
其中,cid代表弹幕对应的ID,aid对应视频的av号。
Python爬虫实现步骤
首先,我们需要爬取该视频页面。
# encoding: utf-8

import requests

headers = {
  'User-Agent':'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/69.0.3497.100 Safari/537.36',
  'Accept': 'text/html',
  'Cookie': "_uuid=1DBA4F96-2E63-8488-DC25-B8623EFF40E773841infoc; buvid3=FE0D3174-E871-4A3E-877C-A4ED86E20523155831infoc; LIVE_BUVID=AUTO8515670521735348; sid=l765gx48; DedeUserID=33717177; DedeUserID__ckMd5=be4de02fd64f0e56; SESSDATA=cf65a5e0%2C1569644183%2Cc4de7381; bili_jct=1e8cdbb5755b4ecd0346761a121650f5; CURRENT_FNVAL=16; stardustvideo=1; rpdid=|(umY))|ukl~0J'ulY~uJm)kJ; UM_distinctid=16ce0e51cf0abc-02da63c2df0b4b-5373e62-1fa400-16ce0e51cf18d8; stardustpgcv=0606; im_notify_type_33717177=0; finger=b3372c5f; CURRENT_QUALITY=112; bp_t_offset_33717177=300203628285382610"

}
resp = requests.get('https://www.bilibili.com/video/av67946325',headers=headers)
print(resp.text)
获取页面内容后,需从中解析出弹幕ID。面对这种结构较为混乱的网页,上一篇中使用的Bs4解析方法不再适用,因此转而使用正则表达式。
正则表达式最基础的使用方式是通过match函数进行匹配。
re.search(匹配规则,文本).group()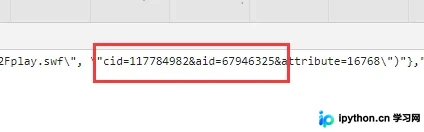
观察页面源码内容,我们可以大致确定匹配规则。
匹配模式大致为:cid={目标值}&aid=av号
在此例中,117784982即为我们需要提取的目标值。
av_id = '67946325'
resp = requests.get('https://www.bilibili.com/video/av'+av_id,headers=headers)
match_rule = r'cid=(.*?)&aid'
oid = re.search(match_rule,resp.text).group().replace('cid=','').replace('&aid','')
print('oid='+oid)
整体流程为:先根据av号获取视频页面,解析该页面以提取oid,最后使用oid请求xml格式的弹幕文件。
xml_url = 'https://api.bilibili.com/x/v1/dm/list.so?oid='+oid
resp = requests.get(xml_url,headers=headers)
print(resp)
至此,我们完成了B站弹幕爬虫的基本实现。
以上内容为本文的全部讲解,希望对各位的学习有所帮助,也欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















