


深入理解python数据结构:列表与字典的底层实现

先理解Python列表的底层存储与动态扩容机制
Python的列表在CPython底层并非直接存储数据本身,而是一个保存PyObject指针的动态数组。这意味着列表的每个元素实际上是对内存中某个Python对象的引用。这种设计使得列表可以容纳任意类型的对象,但也带来了间接访问的开销。索引访问lst[i]的时间复杂度为O(1),因为底层直接通过基地址加偏移量计算指针位置。尾部追加append通常也是O(1),但涉及动态扩容:当当前分配的容量不足以容纳新元素时,CPython会按照特定策略重新分配一块更大的连续内存,并将旧指针拷贝过去。可以通过sys.getsizeof观察容量变化,例如连续append时,内存大小会呈阶梯式跳跃。插入或删除非末尾元素如insert(0, x)或pop(0)则需要移动后续所有指针,时间复杂度为O(n)。理解这一机制后,开发者应避免在循环头部频繁插入,而应优先使用append或预分配容量。
深入理解Python字典的哈希表与键值查找
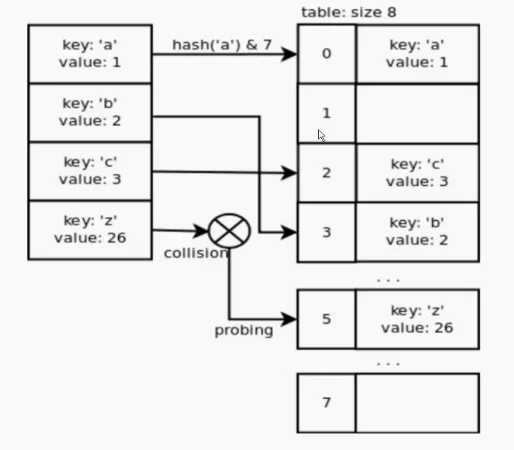
Python字典的底层实现基于哈希表。当执行d[key] = value时,解释器首先调用hash(key)计算键的哈希值,再通过掩码运算将其映射到哈希表的特定索引槽位。由于不同键可能产生相同哈希值,CPython采用开放寻址法结合伪随机探测序列来解决冲突,而非链地址法。这也是为什么字典的键必须是不可变对象:如果键在存入后发生修改,其哈希值将改变,导致后续查找时无法定位到原始槽位,破坏字典的完整性。查找操作平均时间复杂度为O(1),但在极端冲突下可能退化。可通过代码验证:使用hash查看内置类型的哈希值,尝试将列表作为键会直接抛出TypeError。更新操作会复用原槽位,而插入新键则可能触发扩容,当负载因子超过阈值时会重建整个哈希表以维持查找效率。
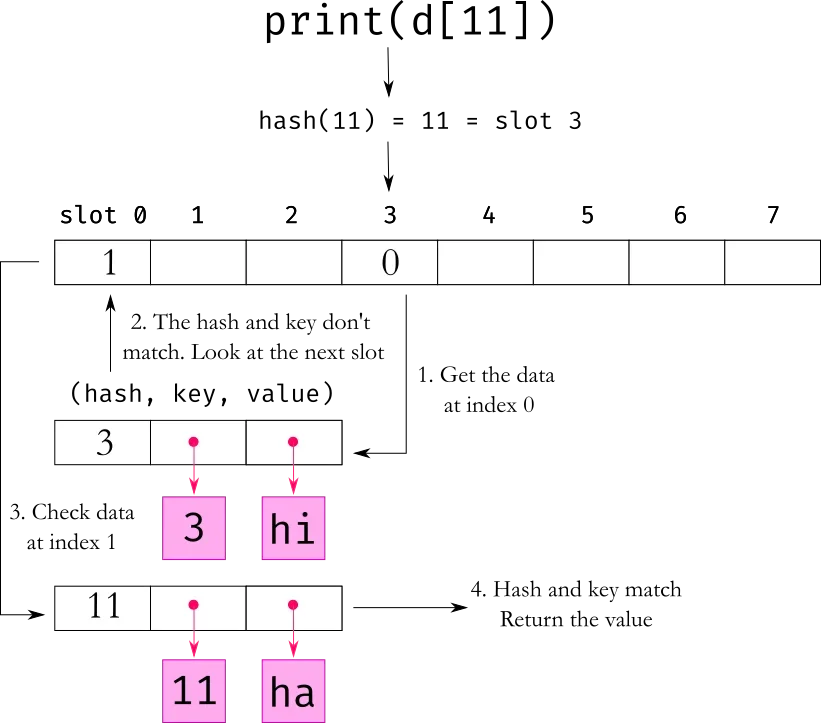
对比列表与字典的时间复杂度和内存开销
列表与字典在时间与空间维度上呈现典型的空间换时间设计取舍。列表的索引访问与尾部追加为O(1),但按值查找需线性遍历,时间复杂度为O(n);插入删除非末尾元素同样为O(n)。字典的查找、插入与删除平均时间复杂度均为O(1),但代价是更高的内存开销:字典不仅需要存储键值对的指针,还需维护稀疏的哈希表数组以控制负载因子,避免冲突恶化。使用sys.getsizeof对比相同元素数量的列表与字典,可明显发现字典的内存占用通常是列表的数倍。通过timeit模块进行基准测试也能验证理论:在十万级数据量下,列表按值查找耗时随数据量线性增长,而字典查找耗时几乎恒定。因此,当业务场景以频繁查找、去重或键值映射为主时,应优先选择字典;若仅需有序遍历、切片或按位置访问,列表的紧凑内存布局与缓存友好性则更具优势。
掌握底层实现带来的常见坑与实际优化方法
理解底层机制能有效规避开发中的典型陷阱。首先是可变对象引用问题:执行a = [[0]*3]*3时,外层列表仅保存同一子列表的引用,修改a[0][0]会导致所有行同步变化,正确做法是使用列表推导式[[0]*3 for _ in range(3)]。其次是浅拷贝陷阱:list.copy或dict.copy仅复制第一层引用,嵌套结构修改仍会相互影响,需使用copy.deepcopy。在性能优化方面,避免在循环中频繁使用list.insert(0, x)或list.pop(0),可改用collections.deque实现O(1)的双端操作;对于字典,若需频繁插入删除且对顺序不敏感,可考虑预分配或使用set替代。当键的哈希冲突严重时,字典性能会急剧下降,此时应优化哈希算法或改用其他结构。总体而言,数据量小且需保持插入顺序时选列表,高频查找与映射选字典,双端操作选deque,有序键值映射则考虑collections.OrderedDict或bisect模块。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















