


StackOverflow热帖讨论高效Python遍历字典技巧

先理解Python字典的几种遍历方式
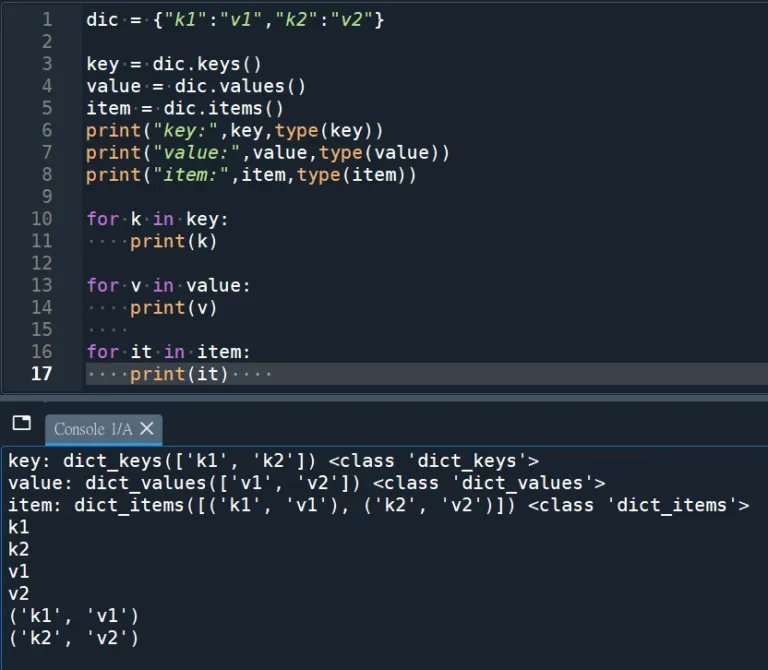
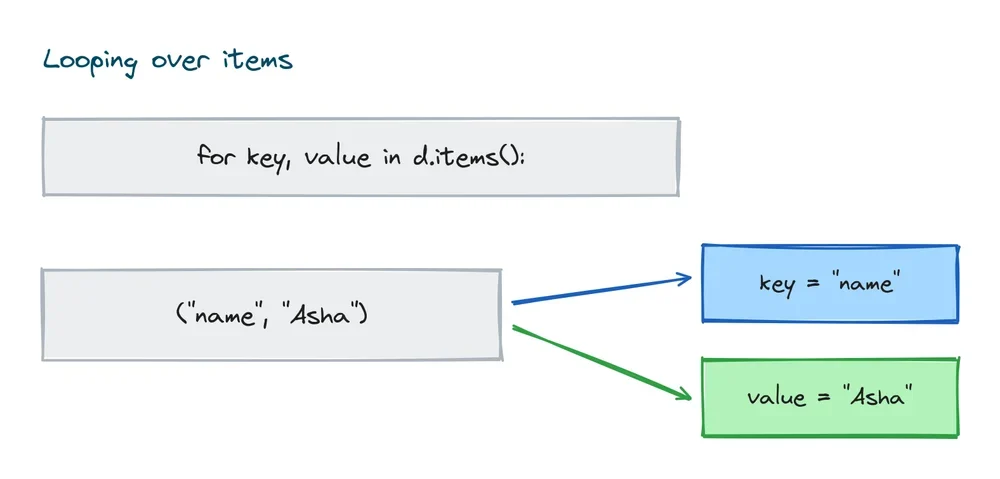
在Python中遍历字典主要有四种基础写法,理解其返回值差异是写出正确代码的前提。直接遍历字典(如 for k in d:)在Python 3中默认等价于遍历键,与显式调用 d.keys() 结果完全一致,均返回字典的键序列。若仅需获取值,应使用 d.values(),它返回一个包含所有值的视图对象。当需要同时处理键与值时,d.items() 是标准选择,它返回由 (键, 值) 元组组成的视图。StackOverflow上的高赞回答普遍指出,初学者常误以为直接遍历会返回键值对,实际上必须通过解包语法 for k, v in d.items(): 才能安全获取两者。明确这四种方式的语义边界,能从根本上避免索引越界或类型错误,为后续的性能与可读性优化打下基础。
根据需求选择最高效且最清晰的写法
选择遍历方式时,代码可读性应优先于微小的性能差异。若业务逻辑仅需判断键是否存在或提取键名,直接使用 for k in d: 最为简洁且符合Pythonic风格;若只需对值进行聚合计算或过滤,for v in d.values(): 能避免多余的键查找开销。当键与值需配对处理时(如格式化输出或构建新映射),d.items() 是唯一推荐方案,它通过C层优化一次性返回元组,比在循环内反复执行 d[k] 查找更高效。StackOverflow社区反复强调,不应为了追求所谓的极致效率而写出 for k in d: v = d[k] 这类冗余代码,这不仅增加了解释器负担,还降低了可维护性。根据实际需求匹配对应方法,才能在清晰表达意图的同时保持合理性能。
用基准测试验证遍历性能差异
性能差异不能仅凭经验推断,必须通过可复现的基准测试进行量化验证。使用Python内置的 timeit 模块,可以构造包含一万条记录的字典,分别对 for k in d:、for k in d.keys():、for v in d.values(): 和 for k, v in d.items(): 进行循环计时。测试代码需固定迭代次数并关闭垃圾回收干扰,例如 timeit.timeit('for k in d: pass', setup='d={i: i*2 for i in range(10000)}', number=10000)。实际运行结果表明,在相同Python版本与硬件环境下,直接遍历与 keys() 耗时几乎一致,values() 略快于键遍历,而 items() 因需构建元组会有极轻微开销,但差异通常在纳秒至微秒级别。需注意的是,数据规模、Python解释器版本及测试环境均会影响绝对耗时,因此应关注相对趋势而非绝对数值,避免将微秒级差异误判为性能瓶颈。
StackOverflow常见误区与实际避坑
StackOverflow讨论中暴露出多个高频误区,开发者需建立正确的优化认知。首先,Python 3中 d.keys() 返回的是动态视图而非列表,直接遍历字典已完全等价,额外调用不仅无益反而增加函数调用开销。其次,遍历过程中直接修改字典(如 del d[k] 或 d[k] = v)会触发 RuntimeError: dictionary changed size during iteration,正确做法是遍历 list(d.keys()) 副本或使用字典推导式生成新对象。此外,许多开发者容易陷入过早优化陷阱,将遍历方式的纳秒级差异视为核心优化目标,却忽略了算法复杂度或I/O瓶颈才是性能主因。最后,需注意Python 2与3的底层差异:Py2的 keys()/values()/items() 返回完整列表,内存开销大,而Py3统一改为惰性视图。理解这些机制,才能写出健壮且高效的代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















