


python可以做什么:从Web开发到数据科学的实际应用

先认识Python能做什么:覆盖多种实际开发场景
Python之所以广受欢迎,核心在于其“胶水语言”特性与丰富的第三方生态。在实际开发中,Python主要覆盖六大方向:Web开发(如使用Django或Flask构建网站后端与API)、数据分析与可视化(处理Excel/CSV、生成报表)、自动化办公(批量重命名文件、自动发送邮件、操作PDF/Word)、人工智能与机器学习(模型训练、自然语言处理)、科学计算(物理仿真、数学建模)以及系统运维脚本(日志监控、定时任务)。初学者无需一开始就精通所有领域,只需明确自身业务痛点。例如,财务人员可用Python替代重复的Excel公式,运维工程师可用其编写定时巡检脚本。掌握这些场景的边界,能帮助你快速定位学习路径,避免盲目投入。
Web开发与自动化:Python如何解决日常开发任务
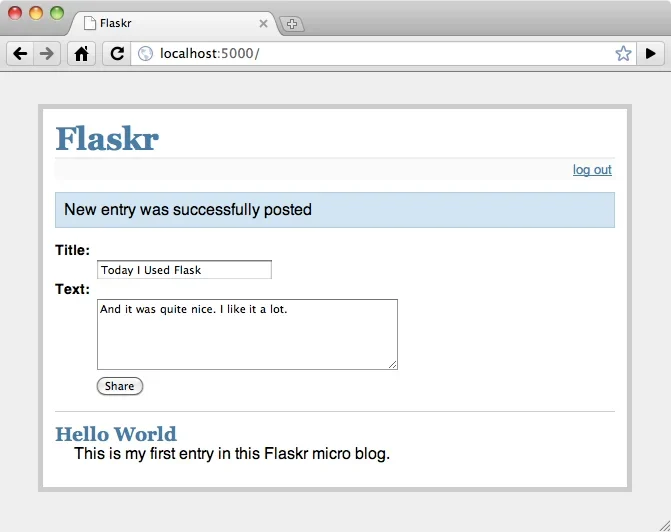
在Web开发领域,Python通过轻量级框架Flask和全栈框架Django大幅降低后端开发门槛。以Flask为例,仅需十余行代码即可启动一个返回JSON的RESTful API服务,配合requests库可快速对接第三方接口。在自动化任务中,Python的os、shutil与glob模块能高效处理文件系统。例如,编写一个脚本遍历指定目录,筛选出所有.pdf文件并按创建日期重命名,再调用schedule库实现每日定时执行。这种“代码即工具”的模式让开发者能将繁琐的手工操作转化为可复用的程序。实际部署时,结合gunicorn或uWSGI即可将本地脚本转化为生产级服务,真正打通从编写到上线的全流程。
数据科学与人工智能:Python为什么成为主流工具
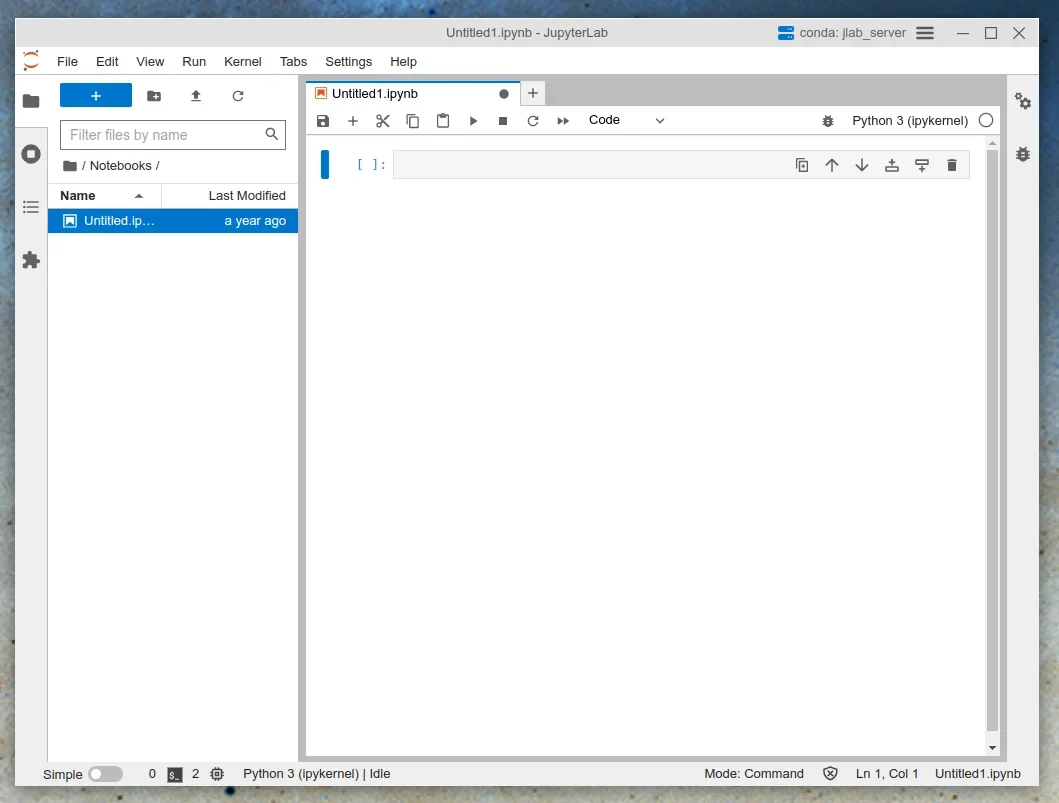
Python在数据科学与AI领域的主导地位源于其清晰的工具链分工。数据清洗通常依赖pandas,它能以DataFrame结构高效处理缺失值、类型转换与分组聚合;数值计算由NumPy提供底层向量化支持,避免Python原生循环的性能瓶颈;可视化则通过Matplotlib或Seaborn将统计结果转化为折线图、热力图等直观图表。在机器学习环节,scikit-learn封装了从特征工程到模型评估的完整流程。例如,加载一份包含房价特征的CSV文件后,使用pandas.read_csv()读取数据,调用df.describe()查看基础统计量,再通过train_test_split划分数据集并训练线性回归模型,最终输出均方误差(MSE)。该流程每一步均可在Jupyter Notebook中逐行验证,结果具备高度可复现性。
选对应用方向并动手验证:从小项目开始学习Python
选择Python学习方向应基于实际需求:若侧重业务系统,优先掌握Django/Flask;若处理报表与模型,则聚焦pandas与scikit-learn。建议从一个可运行的小项目起步,例如编写一个“每日天气查询脚本”:使用requests获取公开API数据,用json解析响应,并通过print格式化输出。开发时务必使用python -m venv env创建虚拟环境,避免全局依赖冲突;通过pip install -r requirements.txt管理第三方库。新手常犯的错误是同时啃多个框架、仅看视频不敲代码,或忽略Python 3.x版本差异导致语法报错。坚持“单点突破、边写边测”的原则,配合官方文档与真实报错调试,才能将理论转化为可交付的工程能力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















