


金融建模中处理负值数据时python 求对数的方法

先检查数据:确认负值、零值与数据分布
在金融建模中,直接使用math.log()或numpy.log()处理包含零或负值的数据会直接触发ValueError或返回NaN,因为对数函数的定义域严格限定为正实数。因此,第一步必须是全面的数据探查。通过Pandas的df.min()、(df < 0).sum()和(df == 0).sum()可以快速定位异常值数量与分布区间。更重要的是,需结合业务逻辑判断负值的来源:例如资产价格理论上不应为负,若出现负值可能是数据录入错误或复权计算异常;而收益率、净利润或价差等指标天然允许负值。明确负值的业务属性后,才能避免盲目清洗导致关键市场信号丢失。建议在建模前输出数据的基本描述统计与直方图,确认负值占比是否超过模型容忍阈值,为后续变换提供依据。
选择合适的对数变换:不要简单把负值取绝对值
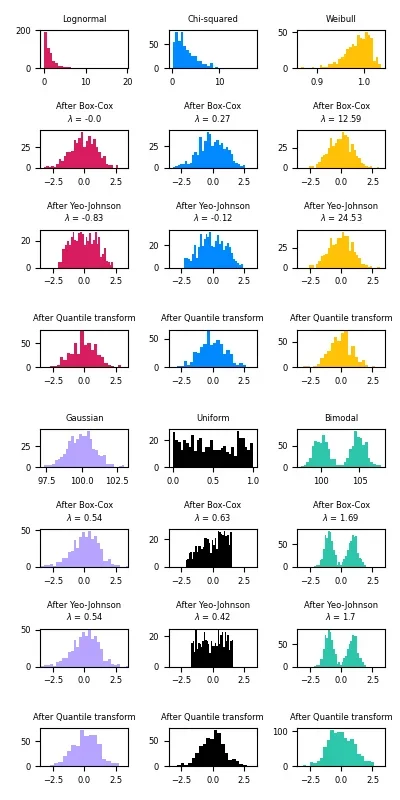
面对负值数据,直接调用np.abs()再求对数是最常见的错误做法。绝对值变换会彻底抹除数据的正负方向信息,在金融场景中,正收益与负亏损的风险特征截然不同,取绝对值将导致模型无法区分多空信号。正确的做法是根据业务需求选择变换策略:若数据整体偏正但存在少量负值,可采用平移对数log(x + c),其中常数c需大于最小负值的绝对值,以保证所有输入为正;若需严格保留正负符号且关注相对变化幅度,可使用符号对数变换sign(x) * log(|x| + 1),该方法在零处连续且能维持原始方向。对于收益率序列,通常优先使用log1p(x)处理接近零的小幅波动。选择时必须评估变换是否扭曲了原始金融指标的经济含义,避免为消除报错而牺牲模型可解释性。
用Python实现负值安全的对数计算
在实际工程实现中,应利用NumPy的向量化操作与Pandas的列级方法构建可复用的对数处理函数。首先,通过shift = np.abs(df.min()) + epsilon动态计算平移量,其中epsilon可设为极小值(如1e-8)防止零值溢出。核心计算可封装为:np.where(df > 0, np.log(df + shift), np.sign(df) * np.log(np.abs(df) + shift)),该逻辑能一次性处理正、负、零值并返回对齐的DataFrame。为保留原始数据,建议使用df.assign(log_transformed=...)生成新列而非原地覆盖。此外,需显式处理边界情况:利用np.isfinite()过滤inf与NaN,或通过df.replace([np.inf, -np.inf], np.nan).dropna()清理异常值。向量化实现不仅避免Python循环的性能瓶颈,还能无缝对接Scikit-learn的Pipeline,确保金融特征工程的稳定性与可追溯性。
验证变换结果:检查数值稳定性与金融含义
变换完成后,必须对输出结果进行严格的数值稳定性与业务一致性验证。首先,使用df.isna().sum()和np.isinf(transformed).any()检查是否残留无效值,并确认极值未超出浮点数安全范围。其次,对比变换前后的描述性统计量(如均值、标准差、偏度),观察数据分布是否从长尾向正态靠拢,但需警惕过度压缩导致尾部风险信号弱化。在金融建模中,排序关系与相对波动率至关重要,可通过计算变换前后序列的斯皮尔曼秩相关系数验证单调性是否保持。若进行可视化,可叠加绘制变换前后的核密度估计图,直观检验分布形态变化。最终需回归业务逻辑:例如对数收益率的波动率是否仍符合历史区间,确保变换未破坏风险定价或因子暴露的原始解释力。
常见避坑:避免因负值处理导致模型失真
金融建模中处理负值对数时,常见陷阱会直接导致模型预测失真或回测失效。首要误区是盲目使用np.log()而不做前置检查,引发运行时警告或静默生成NaN;其次是无依据地设定平移常数,若训练集与测试集使用不同的c值,将造成严重的数据穿越与分布偏移。直接取绝对值或忽略零值同样会扭曲因子方向性与杠杆效应。为避免上述问题,应遵循以下实践原则:第一,所有变换参数(如平移量、符号处理逻辑)必须在训练集上拟合,并固化后应用于验证集与生产环境;第二,优先选择具有明确数学性质且可逆变换的方法,便于结果还原与归因分析;第三,在模型文档中明确记录负值处理策略及其对风险指标的影响,确保策略可审计、可复现。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















