


Python快速排序实现与性能对比分析

本文详细解析了Python中快速排序的多种实现方式,包括基于lambda表达式的简洁写法、常规递归封装、算法导论标准实现以及非递归栈模拟版本。通过实际代码测试对比各方法的运行时间,并重点探讨了递归深度限制与内存溢出问题及其解决方案,最终验证了Python内置sorted函数的高效性。
快速排序基本原理
快速排序的核心逻辑在于分治与递归:首先选取数组中的一个基准元素,将小于该元素的值移至左侧,大于该元素的值移至右侧,随后对左右两个子数组重复此过程,直至完成排序。
多种Python实现方式
第一种实现方式是利用匿名函数lambda。
匿名函数的基本语法为func_name = lambda x: array,其中冒号左侧的x表示输入参数,右侧的array为返回值,函数名可根据需要自定义。
quick_sort = lambda array: \
  array if len(array) <= 1 \
    else quick_sort([item for item in array[1:] if item <= array[0]]) \
       + [array[0]] + \
       quick_sort([item for item in array[1:] if item > array[0]])
第二种方式是将匿名函数的逻辑拆解并封装为普通函数。
def func2(array):
  if len(array)<=1:
    return array
  tmp = array[0]
  left = [x for x in array[1:] if x<=tmp]
  right = [x for x in array[1:] if x>tmp]
  return func2(left) + [tmp] + func2(right)
第三种方式参考了网络上常见的实现模板。
def func2(array,left,right):
  if left>=right:
    return
  low=left
  high=right
  tmp=array[low]
  while left<right:
    while left<right and array[right]>tmp:
      right-=1
    array[left] = array[right]
    while left<right and array[left]<=tmp:
      left+=1
    array[right]=array[left]
  array[right]=tmp
  func2(array,low,left-1)
  func2(array,left+1,high)
第四种方式依据《算法导论》中的标准算法实现。
def func3(array, l, r):
  if l < r:
    q = partition(array, l, r)
    func3(array, l, q - 1)
    func3(array, q + 1, r)
def partition(array, l, r):
  x = array[r]
  i = l - 1
  for j in range(l, r):
    if array[j] <= x:
      i += 1
      array[i], array[j] = array[j], array[i]
  array[i + 1], array[r] = array[r], array[i + 1]
  return i + 1
第五种方式利用栈结构实现非递归版本,以避免递归带来的潜在问题。
def func4(array, l, r):
  if l >= r:
    return
  stack = []
  stack.append(l)
  stack.append(r)
  while stack:
    low = stack.pop(0)
    high = stack.pop(0)
    if high - low <= 0:
      continue
    x = array[high]
    i = low - 1
    for j in range(low, high):
      if array[j] <= x:
        i += 1
        array[i], array[j] = array[j], array[i]
    array[i + 1], array[high] = array[high], array[i + 1]
    stack.extend([low, i, i + 2, high])
第六种方式直接使用Python内置的排序功能。
即调用sorted(array)函数进行排序。
性能测试与结果分析
原本计划使用装饰器来统一测量各函数的运行时间,但由于快速排序内部存在递归调用,直接应用装饰器会导致报错,因此改为逐个计算耗时。以下是用于测量时间的装饰器代码示例:
def count_time(func):
  @wraps(func)
  def helper(func,*args,**kwargs):
    start=time()
    result = func(*args,**kwargs)
    end=time()
    print("函数:", func.__name__, "运行时间:", round(end - start, 4), "s")
    return result
  return helper
测试输入为随机生成的0至100之间的整数,我们观察不同数据规模下的耗时情况:
from functools import wraps
from random import randint
from time import time
func1_start =time()
res = quick_sort(array)
func1_end =time()
print("函数:func1 运行时间:", round(func1_end - func1_start, 4), "s")
func2_start =time()
func2(array)
func2_end =time()
print("函数:func2 运行时间:", round(func2_end - func2_start, 4), "s")
func3_start =time()
func3(array,0,len(array)-1)
func3_end =time()
print("函数:func3 运行时间:", round(func3_end - func3_start, 4), "s")
func4_start =time()
func4(array,0,len(array)-1)
func4_end =time()
print("函数:func4 运行时间:", round(func4_end - func4_start, 4), "s")
func5_start =time()
func5(array,0,len(array)-1)
func5_end =time()
print("函数:func5 运行时间:", round(func5_end - func5_start, 4), "s")
func6_start =time()
sorted(array)
func6_end =time()
print("函数:func6 运行时间:", round(func6_end - func6_start, 4), "s")
数组array的定义如下:
array = [randint(0,100) for i in range(5000)]
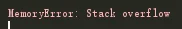
值得注意的是,随着数据量的增加,方法4(即《算法导论》中的实现)会出现以下问题:

这是由于Python对递归深度有限制,可以通过以下方式临时解决该限制:
import sys
sys.setrecursionlimit(100000)
此外,方法4还可能出现内存溢出问题,该方法在实际应用中需谨慎使用。
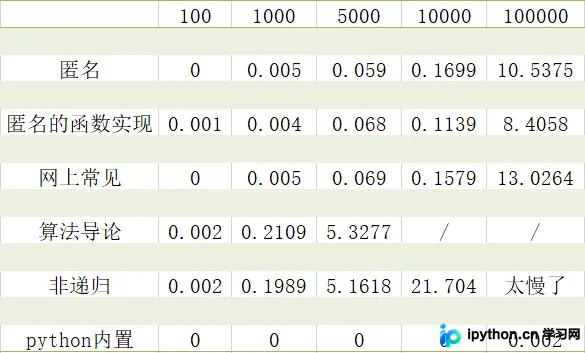
最后,对比上述各方法消耗的时间:
结论与建议
总结:
方法一和方法二的执行速度较快,且逻辑易于理解。若要掌握快速排序的核心思想,重点掌握方法二即可;
Python内置的排序函数速度依然最快;
以上介绍了Python快速排序的多种实现方式及其运行时间对比,希望能为读者提供帮助。如有任何疑问,欢迎留言,小编会及时回复。感谢大家的支持! 若本文对您有帮助,欢迎转载,请注明出处,谢谢!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















