


Python列表与字典入门:核心概念、代码示例与运行验证

先理解列表与字典:结构、特点与适用场景
列表(List)与字典(Dictionary)是Python中最常用的两种内置数据结构。列表使用方括号[]定义,内部元素按顺序排列,通过从0开始的整数索引进行定位,适合存储有序且允许重复的数据集合,例如学生成绩序列或待办事项清单。字典使用花括号{}定义,内部以“键:值”对的形式组织,键必须是不可变类型(如字符串、数字或元组),通过键名直接映射到对应的值,适合存储具有明确属性标识的数据,例如用户信息表或配置参数。选择数据结构时,若关注元素的先后顺序或需要频繁按位置切片,应优先使用列表;若关注数据的语义关联、需要快速查找特定属性或避免重复键,字典则是更优解。理解两者的底层组织逻辑,是编写高效、可读代码的第一步。
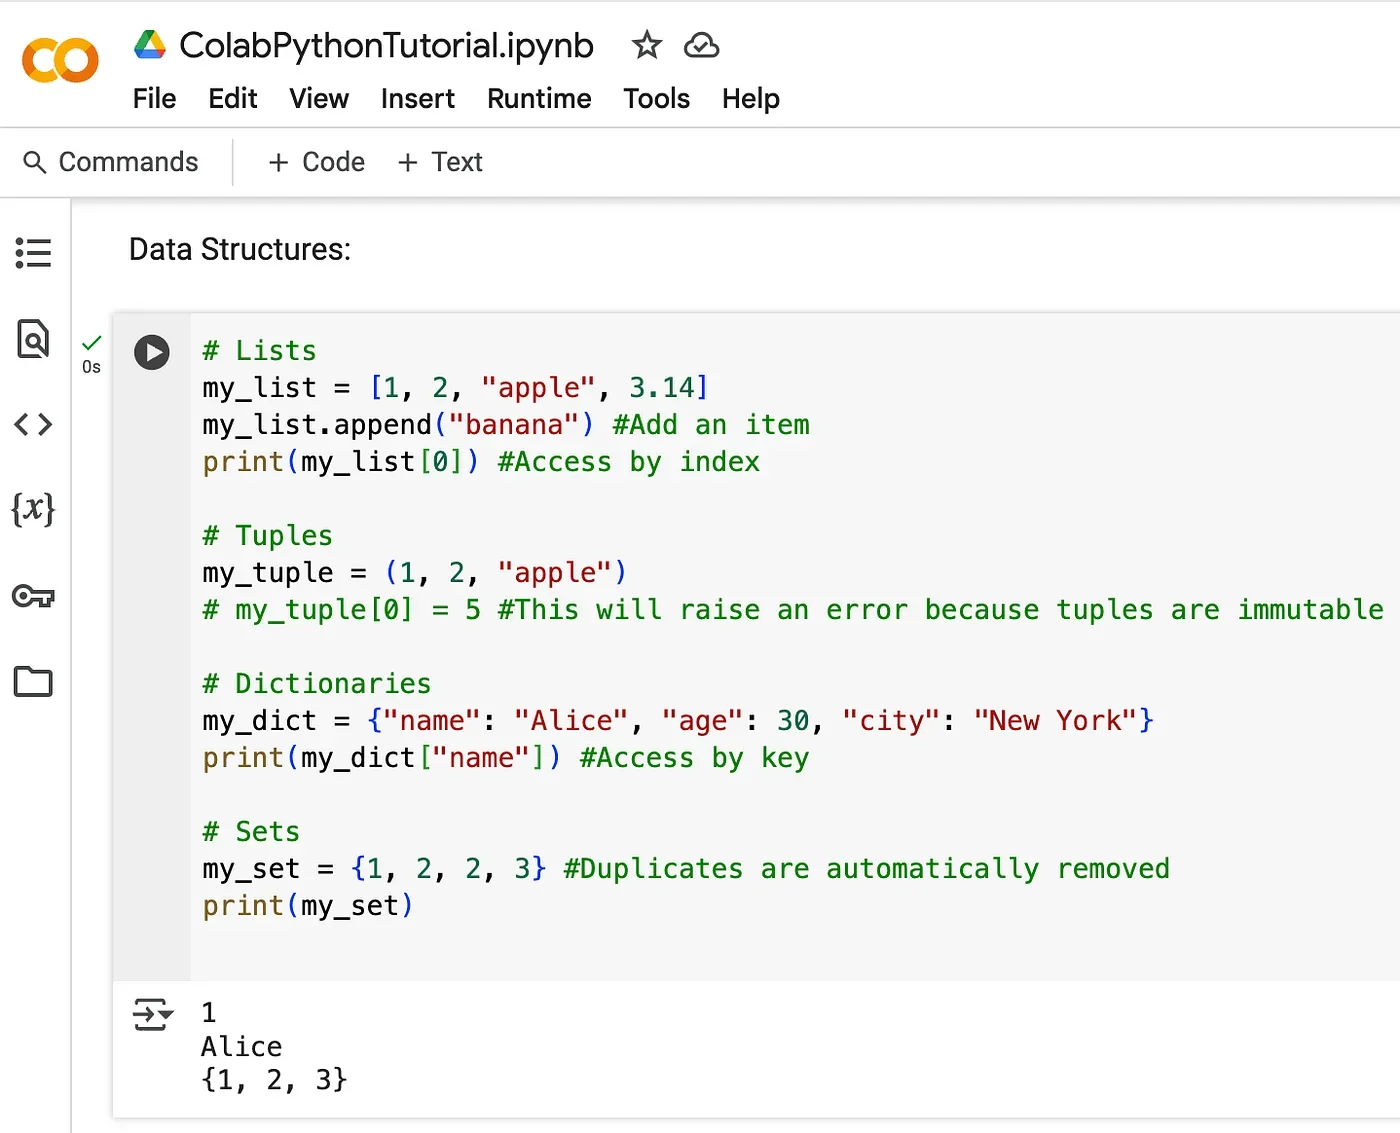
创建与访问数据:掌握索引、键和值
创建列表只需将元素放入方括号并用逗号分隔,例如fruits = ["apple", "banana", "cherry"];创建字典则需指定键值对,如user = {"name": "Alice", "age": 25}。访问数据时,列表依赖整数索引,如fruits[0]返回"apple",索引越界会直接报错。字典通过键名获取值,如user["name"]返回"Alice",若键不存在则抛出KeyError。对于嵌套结构,访问需逐层递进。例如定义嵌套数据data = {"scores": [85, 92, 78], "meta": {"grade": "A"}},要获取第二门成绩需写data["scores"][1],结果为92;要获取等级则写data["meta"]["grade"],结果为"A"。掌握这种链式访问语法,能够轻松处理JSON格式或复杂业务数据,为后续的数据清洗与分析打下坚实基础。
修改与管理数据:增加、删除和更新元素
列表是可变序列,支持原地修改。使用append()可在末尾追加元素,如nums.append(4)使[1, 2, 3]变为[1, 2, 3, 4];insert(index, value)可在指定位置插入,如nums.insert(0, 0)将列表变为[0, 1, 2, 3, 4];remove(value)按值删除首个匹配项,pop(index)则按索引删除并返回该元素。字典同样支持动态增删改。新增或更新键值对只需直接赋值,如user["email"] = "a@b.com",若键已存在则覆盖旧值,若不存在则自动创建新条目。删除操作可使用del user["age"]或user.pop("age"),执行后该键值对将从内存中彻底移除,字典长度相应减少。每次修改后,建议立即打印变量或使用len()、type()验证结构变化,确保数据状态符合业务逻辑预期。
遍历与结果验证:让数据处理真正跑起来
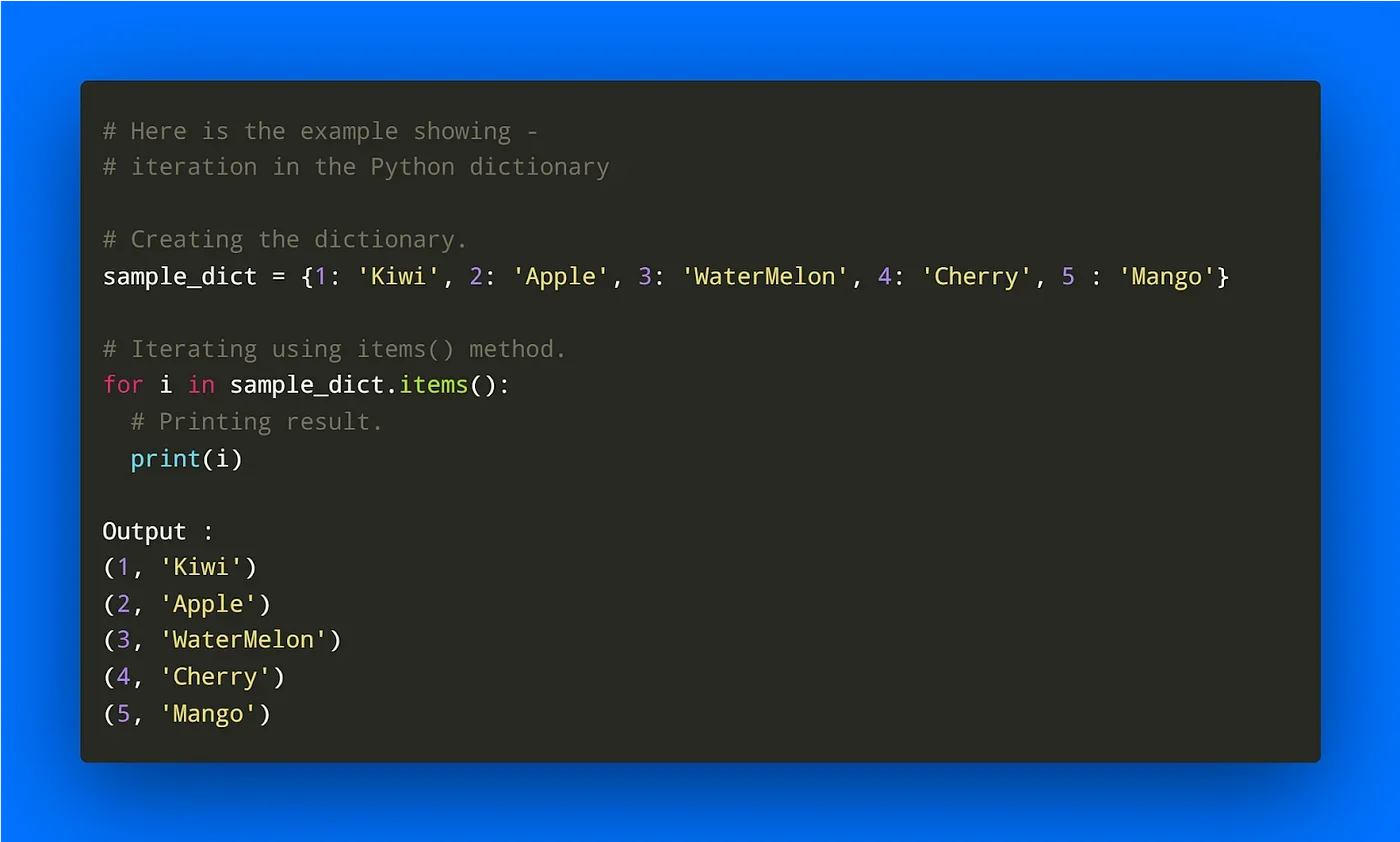
遍历是批量处理数据的核心手段。对于列表,直接使用for item in my_list:即可按顺序获取每个元素,配合enumerate()还能同时拿到索引与值,便于定位处理。对于字典,遍历方式更为灵活:for key in my_dict:仅遍历键;for value in my_dict.values():仅遍历值;最常用的是for key, value in my_dict.items():,可同时解包键与值。在实际开发中,遍历后必须结合结果验证。例如,遍历学生成绩列表计算平均分后,应使用print(f"平均分为: {avg:.2f}")输出核对;遍历字典统计各分类数量时,可打印中间状态或最终汇总结果。通过“处理-打印-比对”的闭环流程,开发者能迅速确认逻辑是否正确,避免静默错误累积到生产环境,从而构建健壮的数据处理管道。
常见避坑:索引越界、键不存在与类型误用
初学者最常遭遇的运行时错误是IndexError: list index out of range与KeyError。列表索引从0开始,若列表长度为3,合法索引仅为0、1、2,访问lst[3]必触发越界异常。排查时应先打印len(lst)确认边界,或使用try-except捕获异常。字典的KeyError源于访问了未定义的键,可通过dict.get(key, default)安全获取,或在访问前用if key in dict:进行防御性判断。此外,切勿混淆两者方法:列表没有.keys()或.items(),字典也不支持.append()。若误将列表当作字典使用,会直接抛出AttributeError。养成使用type()检查变量类型、在修改前备份原始数据、以及利用IDE的类型提示功能,能大幅降低此类低级错误的发生率,提升代码稳定性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















