


Python模块与包管理实战:从基础用法到完整案例

创建项目结构并认识模块与包
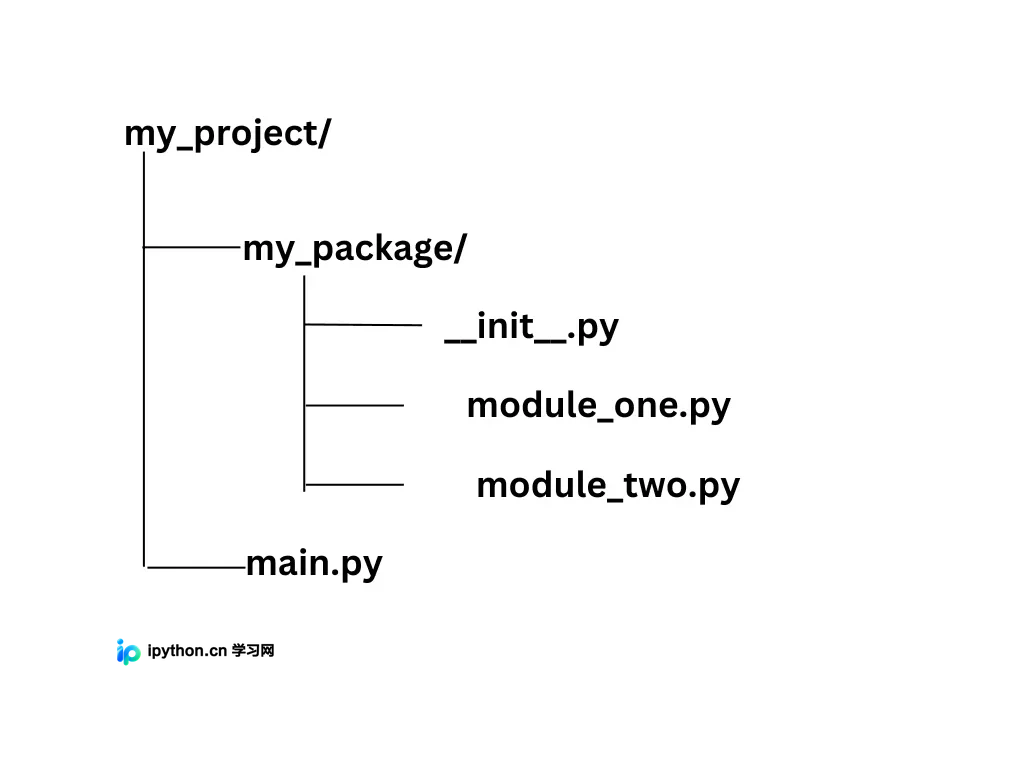
在Python开发中,模块通常指单个.py文件,而包则是包含多个模块的目录,且目录下必须存在__init__.py文件。构建清晰的项目结构是模块化开发的第一步。例如,创建一个名为my_project的根目录,内部包含main.py作为入口,以及core和utils两个子目录。在core/__init__.py中可留空或编写包级初始化逻辑。在main.py中,使用import core.config可导入整个模块,而使用from utils.helpers import format_date则能精准提取特定函数。这种分层导入机制不仅避免了命名空间污染,还提升了代码的可读性与维护性。通过合理划分模块边界,开发者能够将复杂系统拆解为独立单元,为后续的工程化协作奠定基础。
配置环境并安装与管理第三方包
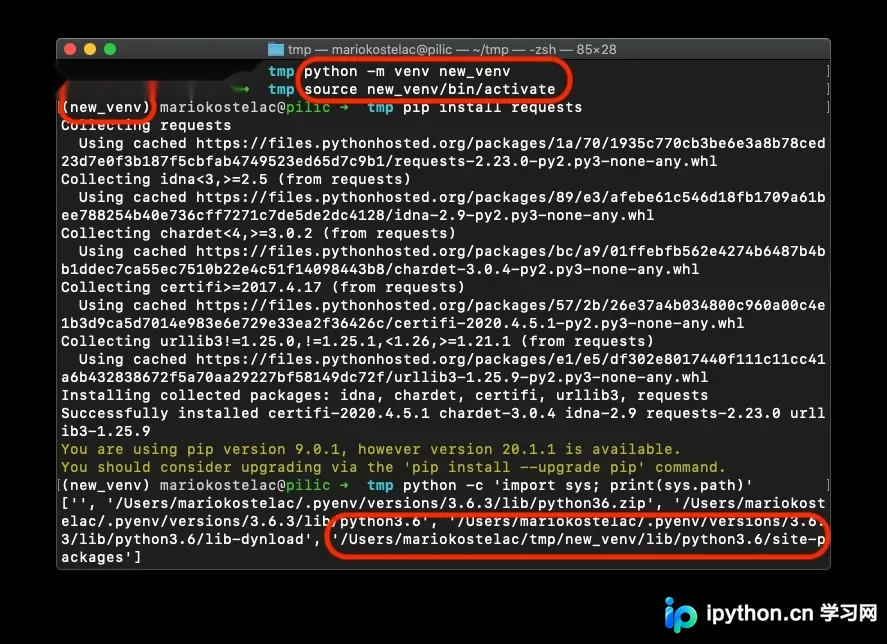
项目依赖隔离是保障环境稳定性的核心手段。推荐使用内置的venv模块创建独立虚拟环境:执行python -m venv .venv生成隔离目录,随后通过source .venv/bin/activate(Linux/macOS)或.venv\Scripts\activate(Windows)激活环境。激活后,终端提示符会显示环境名称,此时使用pip install requests==2.31.0即可安装指定版本的第三方包。通过pip list可查看当前环境已安装包及其版本,pip install --upgrade requests用于安全升级,pip uninstall requests则用于清理废弃依赖。为便于团队协作与环境复现,应使用pip freeze > requirements.txt导出依赖清单。该文件记录了精确的版本号,其他开发者只需执行pip install -r requirements.txt即可一键还原完全一致的运行环境,彻底消除兼容性难题。
构建完整案例并实现模块化调用
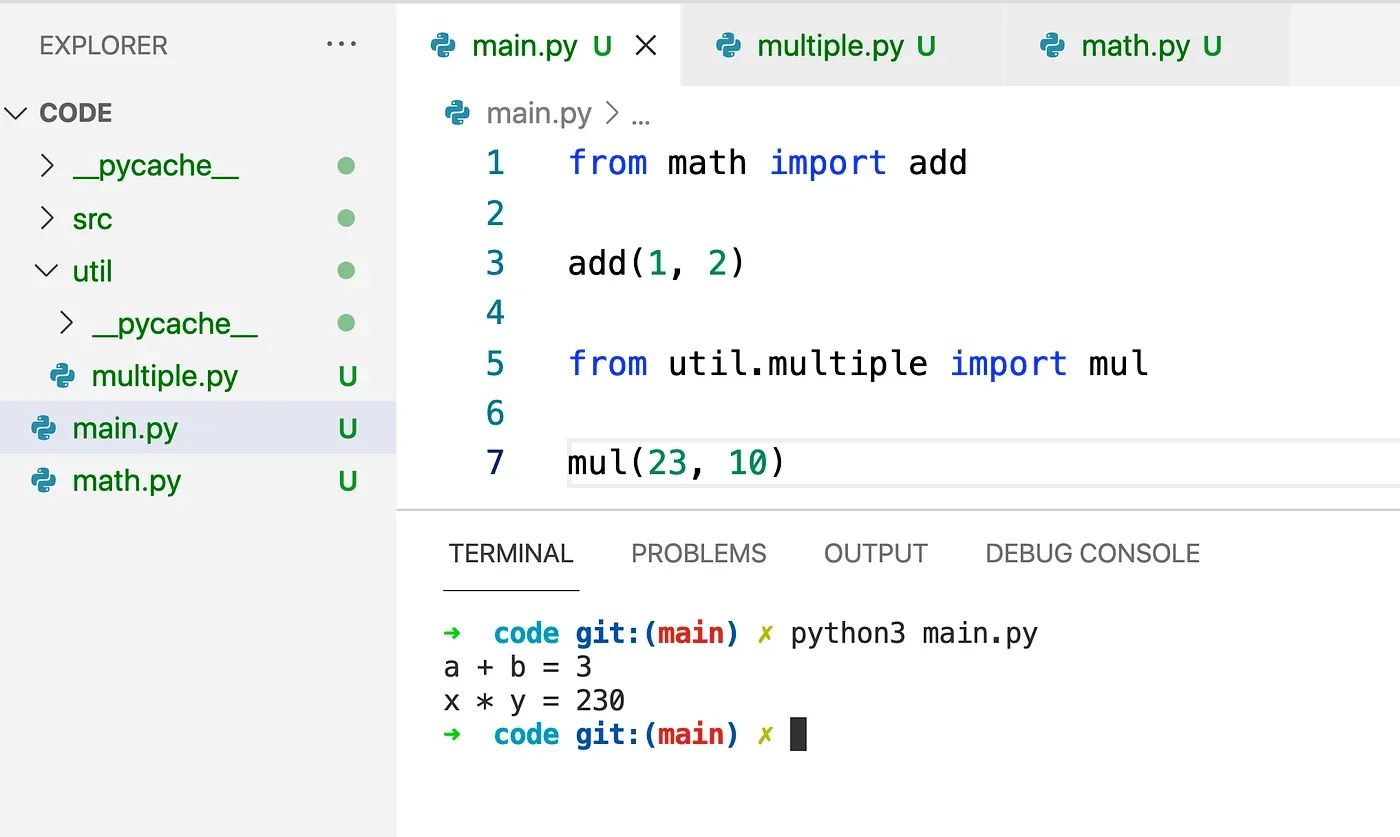
模块化设计的核心在于高内聚低耦合。以一个简易的文本统计工具为例,可将功能拆分为独立模块:在utils/text_processor.py中定义count_words函数,在utils/file_handler.py中实现read_file与write_report。主程序main.py通过from utils.text_processor import count_words和from utils.file_handler import read_file按需导入。在main.py中,先调用read_file读取目标文件内容,再传入count_words计算词频,最后将结果格式化输出。若需扩展功能,只需在utils目录下新增模块,无需修改主程序逻辑。这种架构使代码职责单一,测试时可针对单个模块编写单元测试,部署时也可按需打包。通过清晰的导入路径与函数调用链,项目结构呈现出树状依赖关系,大幅降低了后期维护成本。
验证运行结果并排查导入与依赖问题
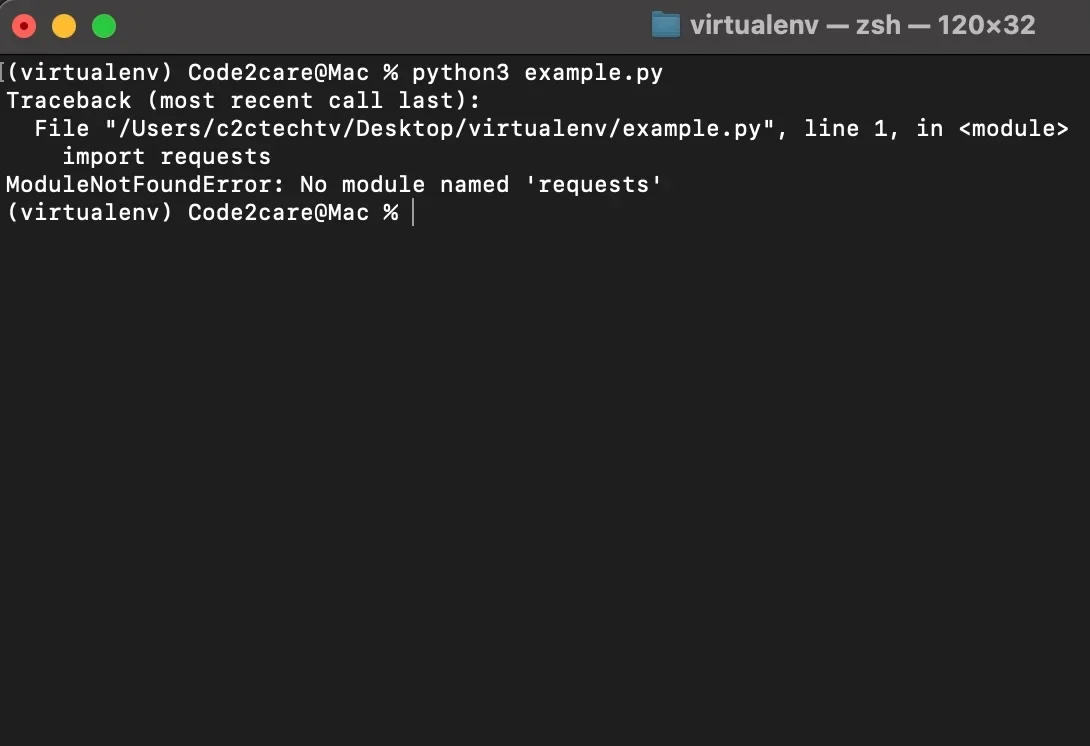
模块与包在实际运行中常因路径或依赖问题报错。遇到ModuleNotFoundError时,首先检查当前工作目录是否在sys.path中,可通过import sys; print(sys.path)验证;若包目录未被识别,可在入口文件顶部添加sys.path.append(os.path.dirname(os.path.abspath(__file__))),或确保以包根目录为起点执行脚本。ImportError多由拼写错误、缺失__init__.py或循环导入引起。循环导入指A模块导入B,B又导入A,导致解释器陷入死锁,解决方法是将共享逻辑抽离至独立模块,或改用延迟导入。依赖版本冲突可通过pip check检测,若提示不兼容,需使用pip install package==x.y.z锁定兼容版本。排查时建议开启python -v查看导入详细过程,结合终端报错堆栈精准定位,确保模块调用链路畅通无阻。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















