


Python+OpenCV实现车牌定位功能(实例代码)

发布时间:2026-10-13 |
3人浏览过
本文基于哈尔滨工业大学视听觉信号处理课程实验,分享使用Python和OpenCV进行车牌定位的完整代码与思路。内容涵盖图像预处理、形态学运算及HSV颜色空间检测等关键步骤,并针对参数调整提供具体建议,旨在为相关学习者提供参考。
实验背景与说明
前置说明
本内容源自哈尔滨工业大学大三上学期视听觉信号处理课程中关于视觉处理的实验三部分。经与往届学长实验要求对比,发现各年级实验标准存在差异,故此处明确标注为2019年秋季学期的视觉实验三内容。
受限于开发时间,本代码未进行性能优化,算法逻辑仅供学习参考。
实验目标
实验目标
针对提供的车牌图像,完成车牌区域的定位与识别任务。
代码实现与参数调整
代码实现
完整代码展示如下,供读者参考使用。
源码展示
具体实验代码如下:
核心源代码
import cv2
import numpy as np
def lpr(filename):
  img = cv2.imread(filename)
  # 预处理,包括灰度处理,高斯滤波平滑处理,Sobel提取边界,图像二值化
  # 对于高斯滤波函数的参数设置,第四个参数设为零,表示不计算y方向的梯度,原因是车牌上的数字在竖方向较长,重点在于得到竖方向的边界
  # 对于二值化函数的参数设置,第二个参数设为127,是二值化的阈值,是一个经验值
  gray_img = cv2.cvtColor(img, cv2.COLOR_RGB2GRAY)
  GaussianBlur_img = cv2.GaussianBlur(gray_img, (3, 3), 0)
  Sobel_img = cv2.Sobel(GaussianBlur_img, -1, 1, 0, ksize=3)
  ret, binary_img = cv2.threshold(Sobel_img, 127, 255, cv2.THRESH_BINARY)
  # 形态学运算
  kernel = np.ones((5, 15), np.uint8)
  # 先闭运算将车牌数字部分连接,再开运算将不是块状的或是较小的部分去掉
  close_img = cv2.morphologyEx(binary_img, cv2.MORPH_CLOSE, kernel)
  open_img = cv2.morphologyEx(close_img, cv2.MORPH_OPEN, kernel)
  # kernel2 = np.ones((10, 10), np.uint8)
  # open_img2 = cv2.morphologyEx(open_img, cv2.MORPH_OPEN, kernel2)
  # 由于部分图像得到的轮廓边缘不整齐,因此再进行一次膨胀操作
  element = cv2.getStructuringElement(cv2.MORPH_RECT, (5, 5))
  dilation_img = cv2.dilate(open_img, element, iterations=3)
  # 获取轮廓
  contours, hierarchy = cv2.findContours(dilation_img, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
  # 测试边框识别结果
  # cv2.drawContours(img, contours, -1, (0, 0, 255), 3)
  # cv2.imshow("lpr", img)
  # cv2.waitKey(0)
  # 将轮廓规整为长方形
  rectangles = []
  for c in contours:
    x = []
    y = []
    for point in c:
      y.append(point[0][0])
      x.append(point[0][1])
    r = [min(y), min(x), max(y), max(x)]
    rectangles.append(r)
  # 用颜色识别出车牌区域
  # 需要注意的是这里设置颜色识别下限low时,可根据识别结果自行调整
  dist_r = []
  max_mean = 0
  for r in rectangles:
    block = img[r[1]:r[3], r[0]:r[2]]
    hsv = cv2.cvtColor(block, cv2.COLOR_BGR2HSV)
    low = np.array([100, 60, 60])
    up = np.array([140, 255, 255])
    result = cv2.inRange(hsv, low, up)
    # 用计算均值的方式找蓝色最多的区块
    mean = cv2.mean(result)
    if mean[0] > max_mean:
      max_mean = mean[0]
      dist_r = r
  # 画出识别结果,由于之前多做了一次膨胀操作,导致矩形框稍大了一些,因此这里对于框架+3-3可以使框架更贴合车牌
  cv2.rectangle(img, (dist_r[0]+3, dist_r[1]), (dist_r[2]-3, dist_r[3]), (0, 255, 0), 2)
  cv2.imshow("lpr", img)
  cv2.waitKey(0)
# 主程序
for i in range(5):
  lpr(str(i+1) + ".jpg")
参数调整策略
参数配置说明
在上述代码中,所有涉及参数调节的函数(如形态学操作)均需边调整边观察当前参数下的运行效果。只有当某一步骤的运行结果达到较好状态后,方可继续执行后续步骤。
该代码对输入图片的质量要求较高,不同图片可能导致识别失败。若出现识别错误,可尝试依次调整预处理模块、形态学模块以及HSV检测模块的相关参数。
实验结果分析
实验效果展示
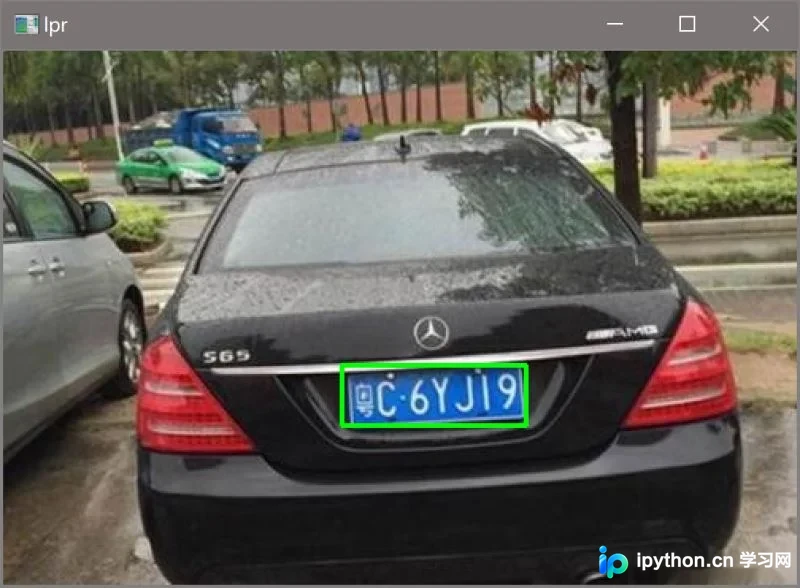
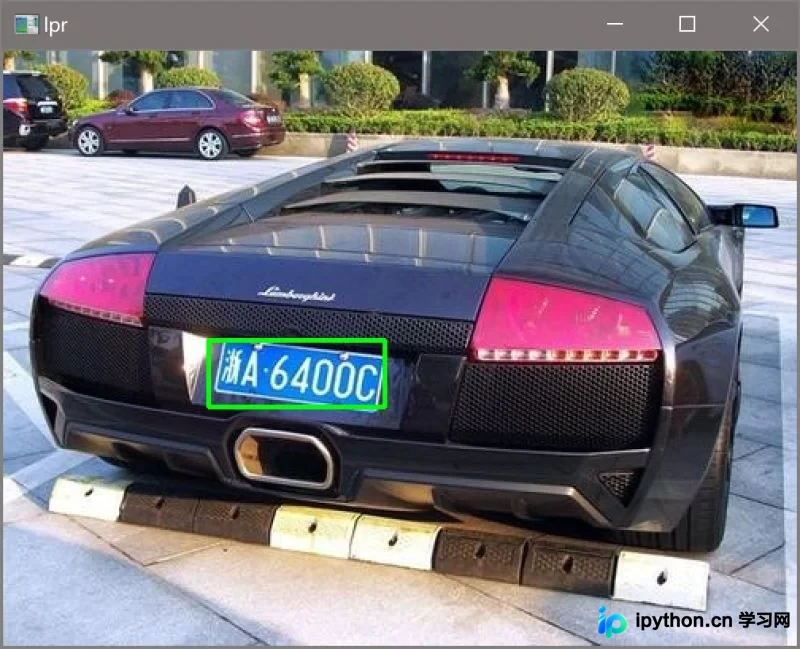
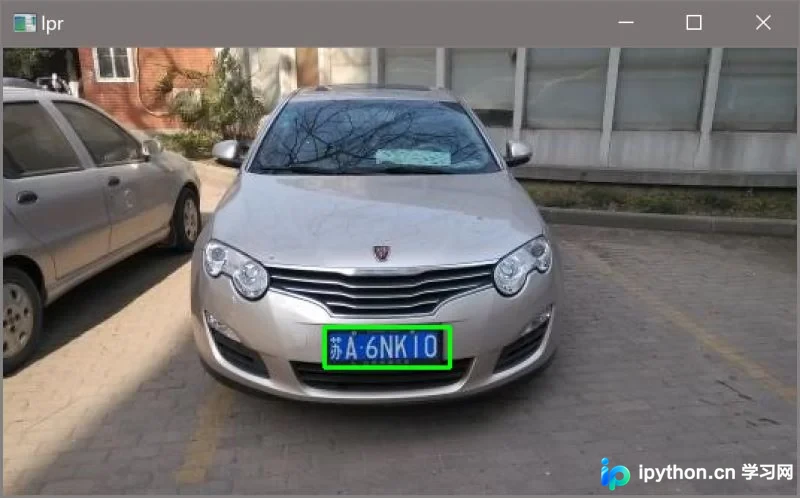
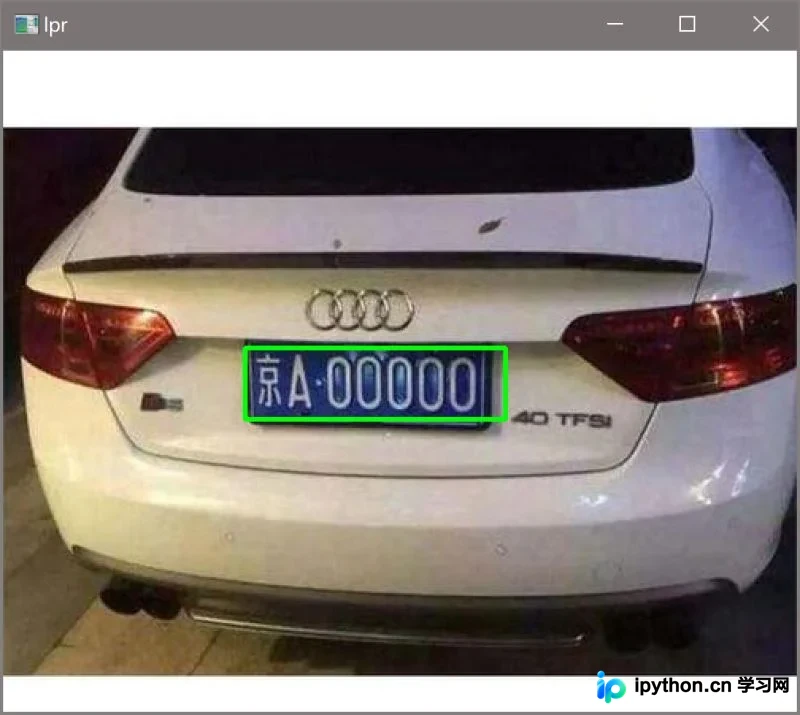
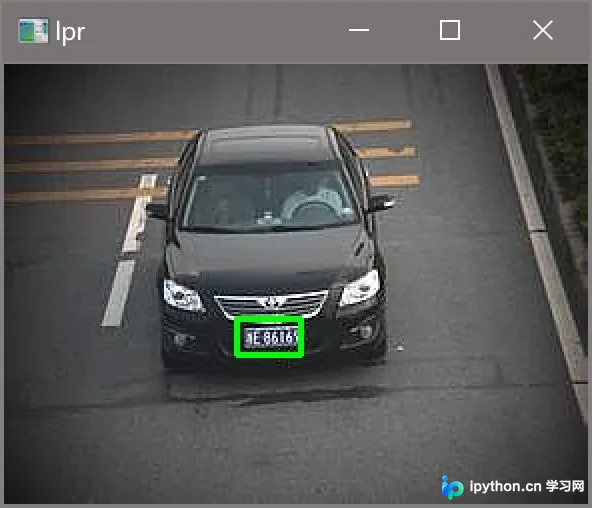
注:图五为识别难度最高的图片,最终通过将HSV下限调整为[100, 60, 60]成功实现识别。
总结
总结
以上介绍了基于Python和OpenCV实现车牌定位的功能实例,希望能为读者提供帮助。如有任何疑问,欢迎留言,小编会及时回复。在此感谢大家对本网站的支持!若觉得本文对您有帮助,欢迎转载,请注明出处,谢谢!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















