


Python调用百度AI接口实现截图OCR识别与翻译

发布时间:2026-10-13 |
3人浏览过
本文介绍如何利用Python调用百度AI接口实现图片识别与翻译功能。通过监听快捷键截取屏幕图像,利用百度OCR接口提取文字,并结合有道词典进行翻译。文章提供了完整的代码示例,涵盖截图、图片保存、API调用及结果解析等关键步骤,帮助开发者快速实现自动化图文处理流程。
Python调用百度AI接口实现截图OCR识别与翻译
本文主要讲解如何使用Python调用百度AI接口,实现图片识别并附加翻译功能。
Python诞生30周年背景
值此Python诞生30周年之际,回顾这一技术发展历程具有重要意义。
核心代码实现
# encoding:utf-8
import requests
import base64
from PIL import Image
import pytesseract
# 这里需要安装一下 Tesseract-OCR
# 链接:https://pan.baidu.com/s/1D2eODet7x9xshBVi6ZUZ_Q
# 提取码:qfef
# 安装好之后别忘了把Tesseract-OCR路径添加到环境变量中
import json
import requests
import keyboard #监听按键库
from PIL import ImageGrab #图像处理库
import time
from aip import AipOcr #pip install baidu_aip
# print("开始截图")
# 1. 截取图片
keyboard.wait(hotkey='ctrl+alt+a')
# print("键盘按下了'ctrl+alt+a'")
keyboard.wait('enter')
# print("键盘按下了'enter'")
# 模拟延迟,来解决grabclipboard函数的缓存问题(grabclipboard函数操作太快,它就会读取上一次的内容)
time.sleep(0.1)
# 2. 保存图片到电脑上
image = ImageGrab.grabclipboard()
image.save('screen.png')
#*************************************************************************************
request_url = "https://aip.baidubce.com/rest/2.0/ocr/v1/accurate_basic"
# 二进制方式打开图片文件
f = open('screen.png', 'rb')
img = base64.b64encode(f.read())
params = {"image":img}
access_token = "你自己的access_token,百度AI里面有教程,我把网址放下面了"
# https://ai.baidu.com/ai-doc/OCR/vk3h7y58v
request_url = request_url + "?access_token=" + access_token
headers = {'content-type': 'application/x-www-form-urlencoded'}
response = requests.post(request_url, data=params, headers=headers)
print("文字识别:")
if response:
  locList = response.json()['words_result']
  for i in locList:
    print(i['words'])
print("\n翻译:")
if response:
  locList = response.json()['words_result']
  for i in locList:
    text = i['words']
##================================================================================##
    # 翻译函数,word 需要翻译的内容
    def translate(word):
      # 有道词典 api
      url = 'http://fanyi.youdao.com/translate?smartresult=dict&smartresult=rule&smartresult=ugc&sessionFrom=null'
      # 传输的参数,其中 i 为需要翻译的内容
      key = {
        'type': "AUTO",
        'i': word,
        "doctype": "json",
        "version": "2.1",
        "keyfrom": "fanyi.web",
        "ue": "UTF-8",
        "action": "FY_BY_CLICKBUTTON",
        "typoResult": "true"
      }
      # key 这个字典为发送给有道词典服务器的内容
      response = requests.post(url, data=key)
      # 判断服务器是否相应成功
      if response.status_code == 200:
        # 然后相应的结果
        return response.text
      else:
        print("有道词典调用失败")
        # 失败就返回空
        return None
    def get_reuslt(repsonse):
      # 通过 json.loads 把返回的结果加载成 json 格式
      result = json.loads(repsonse)
      print("%s" % result['translateResult'][0][0]['tgt'])
    def main():
      list_trans = translate(text)
      get_reuslt(list_trans)
    if __name__ == '__main__':
      main()
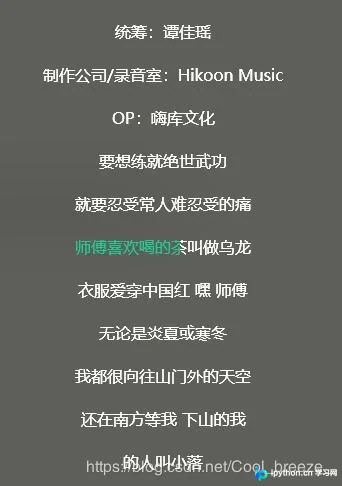
截图保存效果
执行代码后,保存的截图文件如下所示:
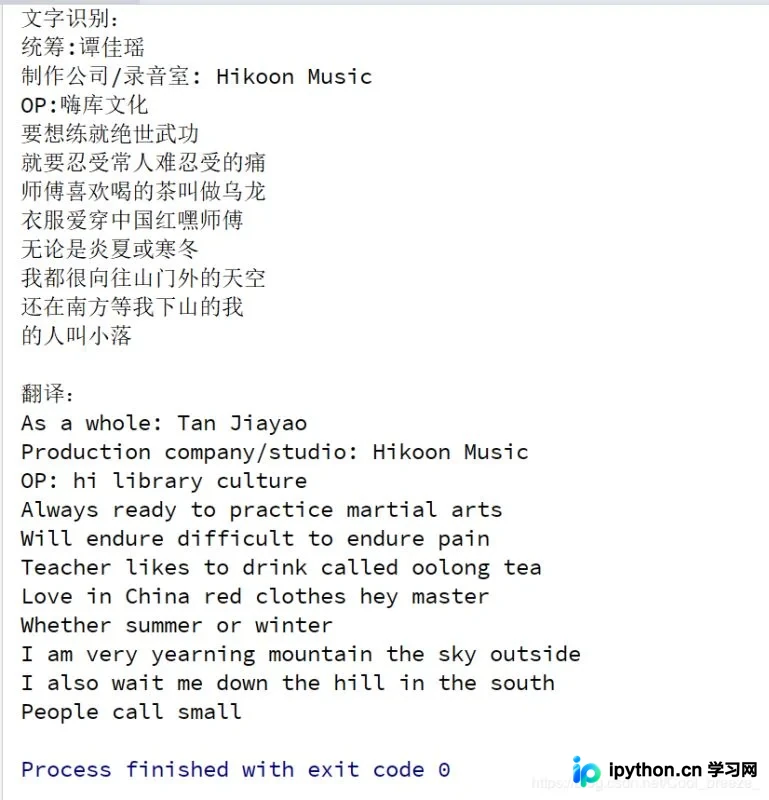
运行结果展示
程序运行输出的识别与翻译结果如下:
总结
总结
结语
以上介绍了使用Python实现图片识别与翻译的具体方法,希望能为读者提供有益参考。如有任何疑问,欢迎留言交流,小编将及时回复。感谢大家对本站的支持! 若本文对您有帮助,欢迎转载,请注明出处,谢谢!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















