


Python实现无序链表去重:顺序与递归法解析

发布时间:2026-10-13 |
4人浏览过
本文介绍Python中处理无序单链表删除重复节点的两类经典算法:顺序删除与递归删除。顺序法通过双重循环实现,时间复杂度O(n^2),空间复杂度O(1);递归法虽逻辑相似,但函数调用开销导致效率略低。此外,文章还探讨了利用链表有序性优化去重性能的思路,适用于已排序链表的线性扫描场景。
问题描述与示例
题目描述:
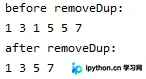
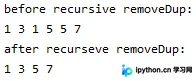
给定一个未排序的链表,要求去除其中重复的节点,同时保持原有节点的相对顺序。例如,对于链表 1->3->1->5->5->7,去重后的结果应为 1->3->5->7。
方法:
- 顺序删除
- 递归删除
顺序删除法实现
1.顺序删除
该方法采用双重循环遍历链表,因此时间复杂度为O(n**2)。在遍历过程中,仅使用常数个额外指针变量来保存当前遍历节点、前驱节点以及待删除节点,因此空间复杂度为O(1)。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
# @Time  : 2020/1/15 20:55
# @Author : buu
# @Software: PyCharm
# @Blog  :https://blog.csdn.net/weixin_44321080
class LNode:
  def __init__(self, x):
    self.data = x
    self.next = None

def removeDup(head):
  """
  对带头结点的无序单链表删除重复的结点
  顺序删除:通过双重循环直接在链表上进行删除操作
  即,外层循环用一个指针从第一个结点开始遍历整个链表,内层循环从外层指针指向的下一个结点开始,
  遍历其余结点,将与外层循环遍历到的的指针所指的结点的数据域相同的结点删除
  :param head: 头指针
  :return:
  """
  if head is None or head.next is None:
    return
  outerCur = head.next
  innerCur = None
  innerPre = None
  while outerCur is not None:
    innerCur = outerCur.next
    innerPre = outerCur
    while innerCur is not None:
      if outerCur.data == innerCur.data:
        innerPre.next = innerCur.next
        innerCur = innerCur.next
      else:
        innerPre = innerCur
        innerCur = innerCur.next
    outerCur = outerCur.next

if __name__ == '__main__':
  i = 1
  head = LNode(6)
  tmp = None
  cur = head
  while i < 7:
    if i % 2 == 0:
      tmp = LNode(i + 1)
    elif i % 3 == 0:
      tmp = LNode(i - 2)
    else:
      tmp = LNode(i)
    cur.next = tmp
    cur = tmp
    i += 1
  print("before removeDup:")
  cur = head.next
  while cur is not None:
    print(cur.data, end=' ')
    cur = cur.next
  removeDup(head)
  print("\nafter removeDup:")
  cur = head.next
  while cur is not None:
    print(cur.data, end=' ')
    cur = cur.next
结果:
递归删除法分析
2.递归
此方法在逻辑上与方法一类似,同样需要对链表进行双重遍历,因此时间复杂度为O(n**2)。由于递归调用会产生大量的函数栈帧开销,从理论性能分析,该方法的效率低于顺序删除法。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
# @Time  : 2020/1/15 21:30
# @Author : buu
# @Software: PyCharm
# @Blog  :https://blog.csdn.net/weixin_44321080
class LNode:
  def __init__(self, x):
    self.data = x
    self.next = None
def removeDupRecursion(head):
  """
  递归法:将问题逐步分解为小问题,即,对于结点cur,首先递归地删除以cur.next为首
  的子链表中重复的结点;接着删除以cur为首的链表中的重复结点,
  :param head:
  :return:
  """
  if head.next is None:
    return head
  pointer = None
  cur = head
  head.next = removeDupRecursion(head.next)
  pointer = head.next
  while pointer is not None:
    if head.data == pointer.data:
      cur.next = pointer.next
      pointer = cur.next
    else:
      pointer = pointer.next
      cur = cur.next
  return head
def removeDup(head):
  """
  对带头结点的单链表删除重复结点
  :param head: 链表头结点
  :return:
  """
  if head is None:
    return
  head.next = removeDupRecursion(head.next)
if __name__ == '__main__':
  i = 1
  head = LNode(6)
  tmp = None
  cur = head
  while i < 7:
    if i % 2 == 0:
      tmp = LNode(i + 1)
    elif i % 3 == 0:
      tmp = LNode(i - 2)
    else:
      tmp = LNode(i)
    cur.next = tmp
    cur = tmp
    i += 1
  print("before recursive removeDup:")
  cur = head.next
  while cur is not None:
    print(cur.data, end=' ')
    cur = cur.next
  removeDup(head)
  print("\nafter recurseve removeDup:")
  cur = head.next
  while cur is not None:
    print(cur.data, end=' ')
    cur = cur.next
结果:
有序链表去重优化思路
引申:从有序链表中删除重复项
上述介绍的方法同样适用于链表有序的情况,但由于未充分利用链表有序这一特性,算法性能并非最优。鉴于链表具有有序性,无需进行两次遍历,因此可采用以下思路: 使用指针cur指向链表的第一个节点,此时需分两种情况讨论:
- 如果cur.data == cur.next.data,则删除cur.next节点;
- 如果cur.data != cur.next.data,则执行cur=cur.next,继续遍历后续节点;
总结
以上所述是小编给大家介绍的python无序链表删除重复项的方法,希望对大家有所帮助,如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对本站网站的支持! 如果你觉得本文对你有帮助,欢迎转载,烦请注明出处,谢谢!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















