


Python正则分组:命名捕获与条件匹配

理解正则分组与命名捕获
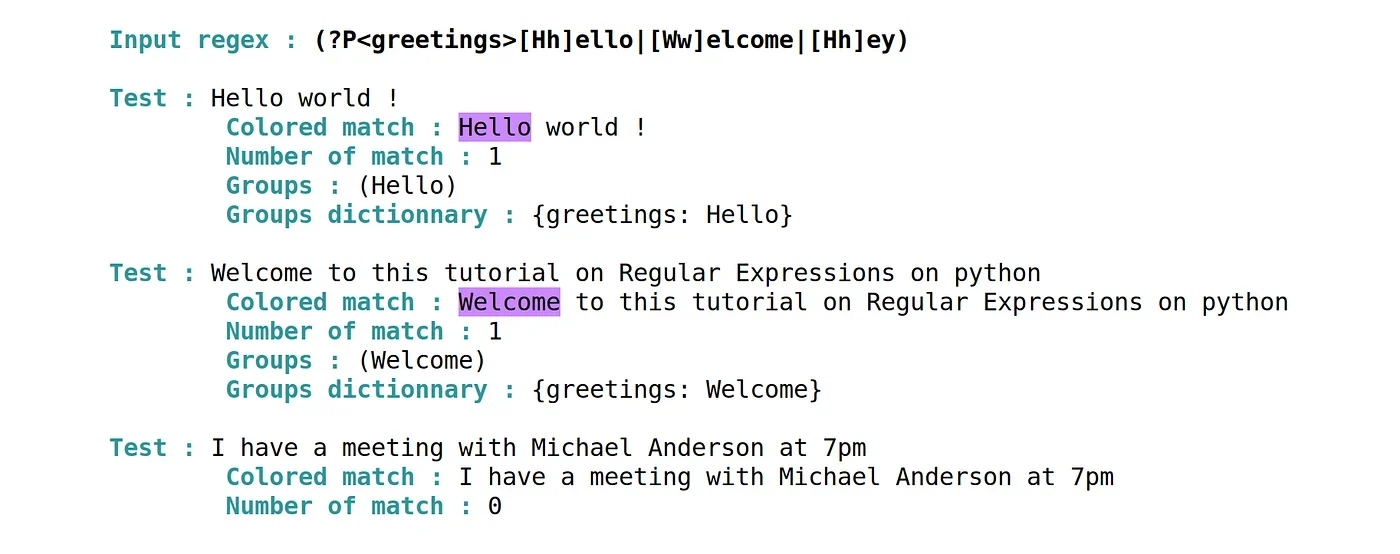
在 Python 的 re 模块中,圆括号 () 默认创建普通捕获组,匹配内容会按左括号出现顺序分配数字编号,后续需通过 group(1)、group(2) 等按位置提取。若仅需逻辑分组而不需保存结果,应使用非捕获组 (?:...),它能减少内存开销并避免编号偏移干扰后续引用。命名捕获组通过 (?P<name>...) 语法定义,为特定片段赋予语义化标识。匹配成功后,可通过 match.group('name') 直接提取目标值,或调用 match.groupdict() 获取包含所有命名组键值对的字典。例如解析日期 r'(?P<year>\d{4})-(?P<month>\d{2})-(?P<day>\d{2})',调用 groupdict() 将返回 {'year': '2023', 'month': '10', 'day': '05'}。该机制彻底摆脱了依赖位置索引的脆弱性,当正则模式因业务调整插入新分组时,原有提取逻辑无需修改,显著提升代码可维护性。
使用命名分组与反向引用精确匹配
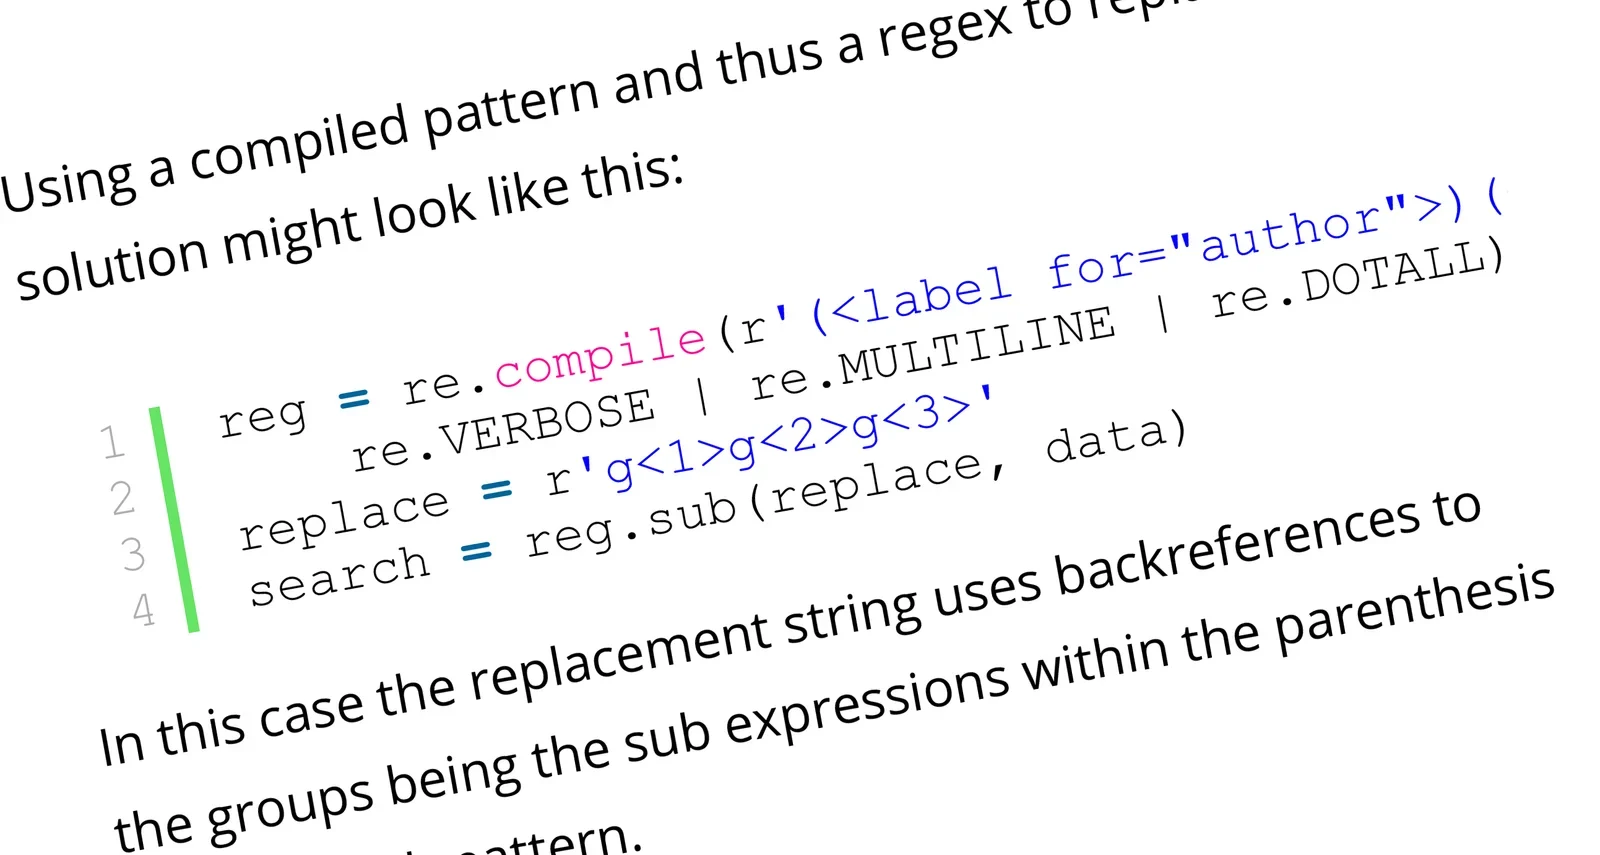
命名分组在验证成对结构、重复模式或严格格式时具有不可替代的作用。Python 支持通过 (?P=name) 语法引用已命名的捕获组,其功能等价于传统的数字反向引用 \1,但可读性更强且不会因插入新分组导致编号错位。例如校验闭合的自定义标签,可编写正则 r'<(?P<tag>[a-z]+)>(?P<content>.*?)</(?P=tag)>'。当输入为 '<div>hello</div>' 时,(?P=tag) 会强制要求结束标签必须与起始标签名称完全一致;若输入 '<div>hello</span>',则引擎因反向引用校验失败而返回 None。该机制同样适用于重复单词检测,如 r'\b(?P<word>\w+)\s+(?P=word)\b' 可精准定位连续重复词。在日志清洗与数据校验场景中,使用命名反向引用能有效避免人工拼接字符串带来的逻辑漏洞,确保前后文数据强一致。
掌握条件匹配与分支逻辑
条件匹配语法 (?(name)yes-pattern|no-pattern) 允许正则引擎根据指定命名组是否成功参与匹配来决定后续匹配路径。若 name 组成功捕获,则执行 yes-pattern;否则执行 no-pattern(no-pattern 可省略)。该特性常与可选分组结合,实现动态分支逻辑。例如解析带可选区号的电话号码:r'(?P<area>\(\d{3}\))?(?(area)\s?-?\d{3}-\d{4}|\d{3}-\d{4})'。当输入包含 '(010)' 时,area 组捕获成功,引擎进入 yes 分支,要求后续格式为空格或连字符加三位减四位;若无区号,则直接匹配三位减四位格式。需注意,条件判断仅依赖分组是否参与匹配,而非捕获内容是否为空字符串。合理设计前置可选组是避免分支误判的关键,且条件语法中必须包含 yes-pattern,否则将引发 re.error 编译异常。
综合应用、验证与常见避坑
将命名捕获与条件匹配结合可构建高鲁棒性的结构化解析器。以解析服务器日志 '[INFO] 2023-10-01 | User: admin | Action: login' 为例,正则可设计为 r'\[(?P<level>\w+)\]\s+(?P<date>\d{4}-\d{2}-\d{2})\s*\|\s*User:\s*(?P<user>\w+)\s*\|\s*Action:\s*(?P<action>\w+)',配合 groupdict() 直接输出结构化字典。实际开发中需警惕四大陷阱:一是同一模式内重复定义相同组名会直接抛出 re.error,需全局检查命名唯一性;二是普通分组与命名分组混用时,数字编号仍按左括号顺序递增,建议统一使用命名组以消除编号混乱;三是条件分支遗漏竖线分隔符或 no-pattern 会导致语法错误,编写时应严格对照官方文档;四是过度嵌套分组会引发灾难性回溯,可通过 re.DEBUG 标志查看编译树,或引入第三方 regex 库的 finditer 逐步验证边界输入,确保解析逻辑严密且性能可控。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















