


Python序列化与CSV文件特性详解

发布时间:2026-10-13 |
5人浏览过
本文详解Python中的序列化机制,重点介绍pickle模块实现对象持久化的方法。同时对比CSV与Excel文件的差异,阐明CSV仅支持字符串数据、无样式及多表等限制,帮助开发者正确使用CSV进行数据存储与读取。
本文深入解析Python中的序列化技术以及CSV文件的读取方法,通过具体示例展示核心用法,为相关开发工作提供实用参考。
Python序列化基础
一、Python序列化基础
序列化是将对象转换为可存储或传输的“串行化”数据格式的过程,通常用于保存到硬盘或通过网络发送;反序列化则是其逆过程,将读取到的串行数据还原为原始对象。在Python中,主要依赖pickle模块提供的函数来完成这两项操作。
序列化操作的具体实现
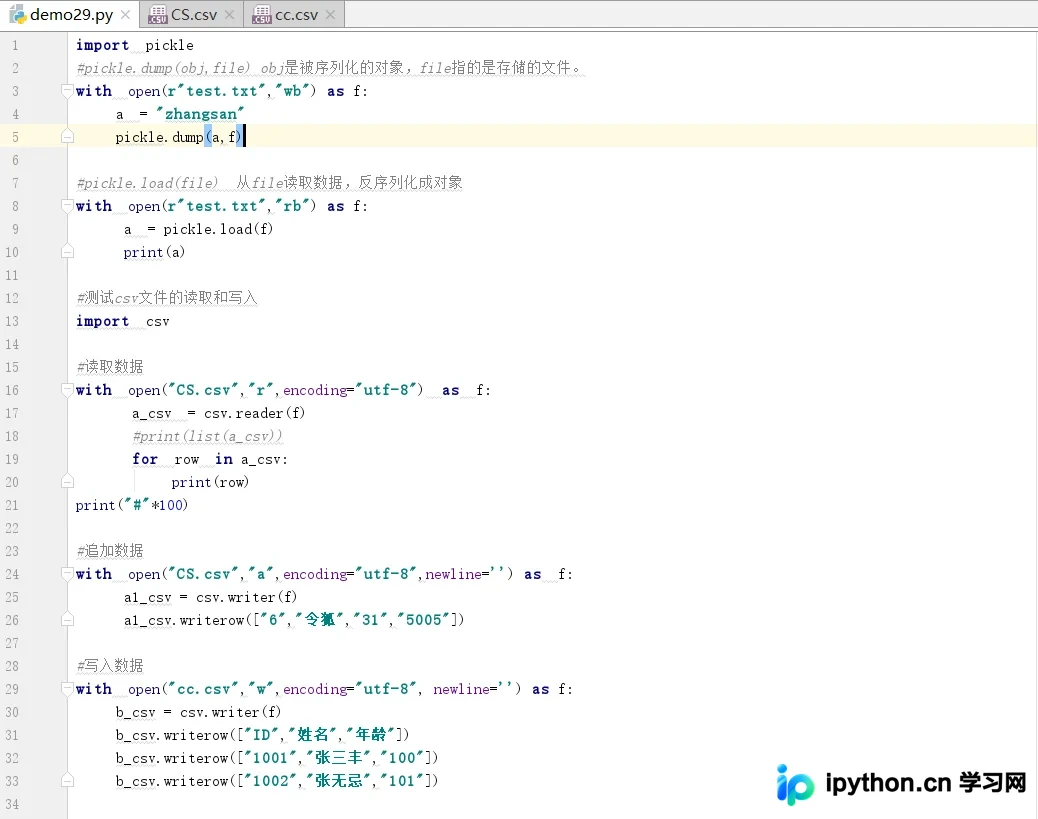
使用pickle.dump(obj, file)函数进行序列化,其中obj代表需要被序列化的目标对象,file指代用于存储数据的文件句柄。
使用pickle.load(file)函数进行反序列化,该函数从指定的file文件中读取数据,并将其还原为对应的对象。
CSV文件与Excel文件的区别
二、CSV文件与Excel文件的区别
1. 数据类型限制:CSV文件中不包含类型信息,所有存储的值均被视为字符串。
2. 样式缺失:CSV格式不支持设置字体颜色或其他视觉样式。
3. 单元格控制:无法定义单元格的宽度与高度,也不支持合并单元格操作。
4. 工作表限制:CSV文件仅包含单一数据表,不支持创建多个工作表。
5. 多媒体支持:CSV格式无法嵌入图像或图表等多媒体元素。
示例演示
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















