


使用TensorFlow实现XOR异或运算的完整教程

本文详细介绍如何使用TensorFlow构建简单的多层神经网络来解决XOR(异或)线性不可分问题。通过定义输入输出、权重初始化、ReLU激活函数及Adam优化器,逐步演示模型训练过程。文章包含完整Python代码示例,并分析学习率与迭代次数对损失函数的影响,帮助初学者理解神经网络的基本原理与调参技巧。
XOR异或运算基础
XOR(异或)是计算机科学和数学中常见的逻辑运算符号,数学表示为 。其核心规则简单明了:当两个输入值a和b相等时,结果为0;当两者不同时,结果为1,即遵循“相同为0,不同为1”的原则。
从感知机到多层神经网络
在计算机早期发展中,逻辑运算主要依托电子管实现,这在微机原理课程中有所涉及。在神经网络领域,早期尝试使用感知机(单层神经网络,仅含输入层和输出层)来解决此类问题。尽管关于神经网络层数的定义存在争议(通常N层指隐藏层加输出层),但感知机无法处理XOR运算,因为XOR属于线性不可分问题,单层结构无法在特征空间中画出线性分割边界。
为了解决线性不可分问题,多层神经网络应运而生。其基本思路是通过引入隐藏层来捕捉非线性关系。
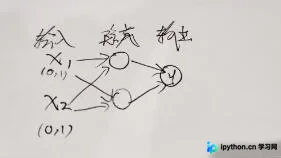
XOR运算有两个输入,每个输入取值为0或1,因此共有四种组合:[0,0]、[0,1]、[1,0]和[1,1]。通过中间隐藏层的非线性变换,可以实现对这些组合的异或逻辑处理。
神经网络架构设计
本实验仅需一个隐藏层即可完成XOR运算。建议初学者参考吴恩达的神经网络课程,其讲解从零基础出发,通俗易懂。以下图示为手工绘制的网络架构示意图,虽非精确绘图,但能清晰表达核心结构。
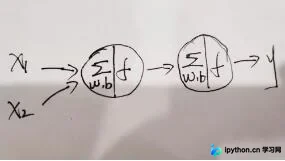
上图展示了最基本的神经网络结构:包含两个输入节点x1和x2,一个隐藏层(仅含一个神经元),以及一个输出层。这是典型的“输入层+隐藏层+输出层”架构。针对本题,具体的输入输出及整体架构如下图所示:
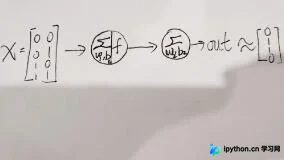
输入数据为一个矩阵,包含[0,0]、[0,1]、[1,0]、[1,1]四组数据。对应的目标输出值为[0,1,1,0]。公式中使用约等号是因为预测值与真实目标值之间存在误差;经过充分训练后,预测值将无限接近目标值。
TensorFlow代码实现
以下是完整的实现代码,未分步展示是因为实验难度较低且注释详尽。如有疑惑欢迎留言交流:
#!/usr/bin/env python
# -*- coding:utf-8 -*-

import numpy as np
import tensorflow as tf

#定义输入值与目标值
X=np.array([[0,0],[0,1],[1,0],[1,1]])
Y=np.array([[0],[1],[1],[0]])

#定义占位符,从输入或目标中按行取数据
x=tf.placeholder(tf.float32,[None,2])
y=tf.placeholder(tf.float32,[None,1])

#初始化权重,使其满足正态分布,w1和w2分别为输入层到隐藏层和隐藏层到输出层的权重矩阵
w1=tf.Variable(tf.random_normal([2,2]))
w2=tf.Variable(tf.random_normal([2,1]))

#定义b1和b2,分别为隐藏层和输出层的偏移量
b1=tf.Variable([0.1,0.1])
b2=tf.Variable([0.1])

#使用Relu激活函数得到隐藏层的输出值
a=tf.nn.relu(tf.matmul(x,w1)+b1)

#输出层不用激活函数,直接获得其值
out=tf.matmul(a,w2)+b2

#定义损失函数MSE
loss=tf.reduce_mean(tf.square(out-y))

#优化器选择Adam
train=tf.train.AdamOptimizer(0.01).minimize(loss)

#开始训练,迭代1001次(方便后边的整数步数显示)
with tf.Session() as session:
  session.run(tf.global_variables_initializer()) #初始化变量
  for i in range(1001):
    session.run(train,feed_dict={x:X,y:Y}) #训练模型
    loss_final=session.run(loss,feed_dict={x:X,y:Y}) #获取损失
    if i%100==0:
      print("step:%d   loss:%2f" % (i,loss_final))
  print("X: %r" % X)
  print("pred_out: %r" % session.run(out,feed_dict={x:X}))
结合第三张图理解代码更为直观。隐藏层神经元的主要功能是将输入值与权重进行矩阵乘法,加上偏置量后,通过激活函数进行非线性转换。本例中输出层未使用激活函数,因为任务并非分类,而是直接回归计算异或结果。通常隐藏层常用ReLU激活函数,分类输出层常用Sigmoid,但本实验为纯异或运算,故省略输出层激活函数。
标准神经元内部的操作流程可参考下图示意:
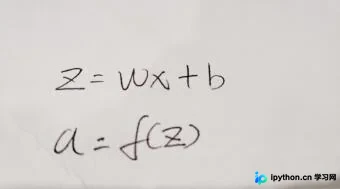
输入x和权重w通常以矩阵形式表示,因为涉及多个输入。矩阵乘法需满足特定维度条件,这是线性代数的基础内容,正确设定权重形状至关重要。
训练效果与参数调优
以下是模型训练的效果展示:
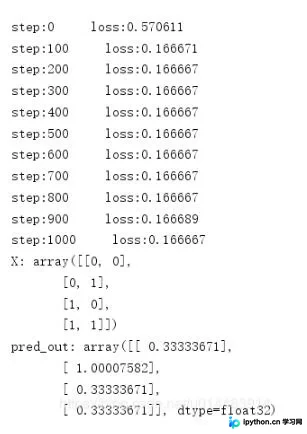
在学习率为0.1、迭代1001次的条件下,得到的结果如下:
保持学习率不变,将迭代次数增加至2001次,观察效果:
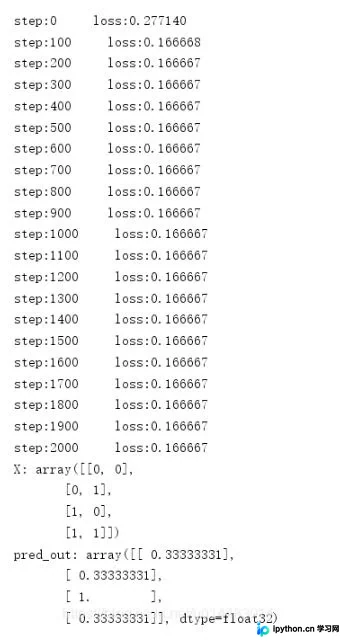
结果显示无明显改进,说明单纯增加迭代次数并非关键。保持2001次迭代,将学习率调整为0.01,再次观察效果:
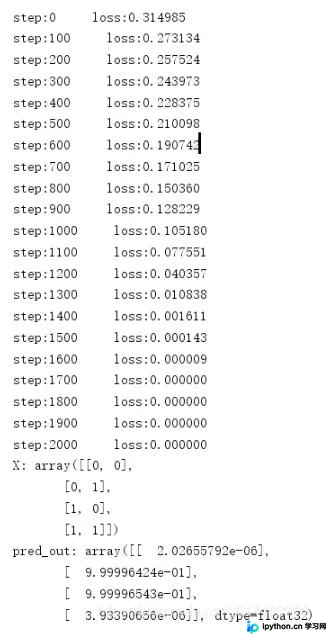
效果显著改善,最终损失降至0。在神经网络超参数中,学习率最为关键;若损失无法下降,首先应调整学习率,其他超参数次之。
观察预测值,四项结果分别对应[0,1,1,0],已非常接近理论值。
以上即为使用TensorFlow轻松实现XOR运算的完整教程,希望能为您提供参考与支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















