


Python文件操作:逐行读取与缓冲区设置

掌握文件逐行读取的基本方式
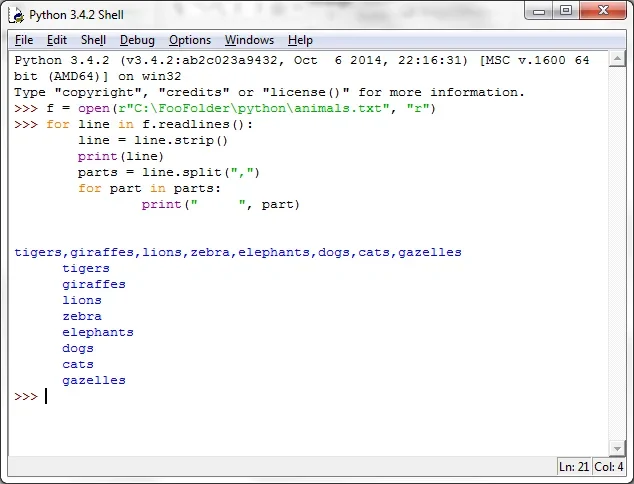
在Python中处理文本文件时,逐行读取是避免内存溢出的核心策略。常见的三种方式中,readlines()会一次性将文件所有内容读入内存并返回列表,仅适合极小文件;readline()虽能逐行读取,但需配合while循环与空字符串判断,代码较为繁琐。相比之下,使用for line in f:遍历文件对象是最推荐的实践。该语法底层依赖文件迭代器,每次仅从磁盘加载当前行到内存,处理完毕后立即释放,从而彻底规避了全量加载导致的内存峰值。例如,面对数GB的日志文件时,迭代器模式能保持稳定的低内存占用,而readlines()极易触发MemoryError。开发者应优先采用for循环结构,兼顾代码简洁性与运行效率。
理解open()缓冲区与buffering参数
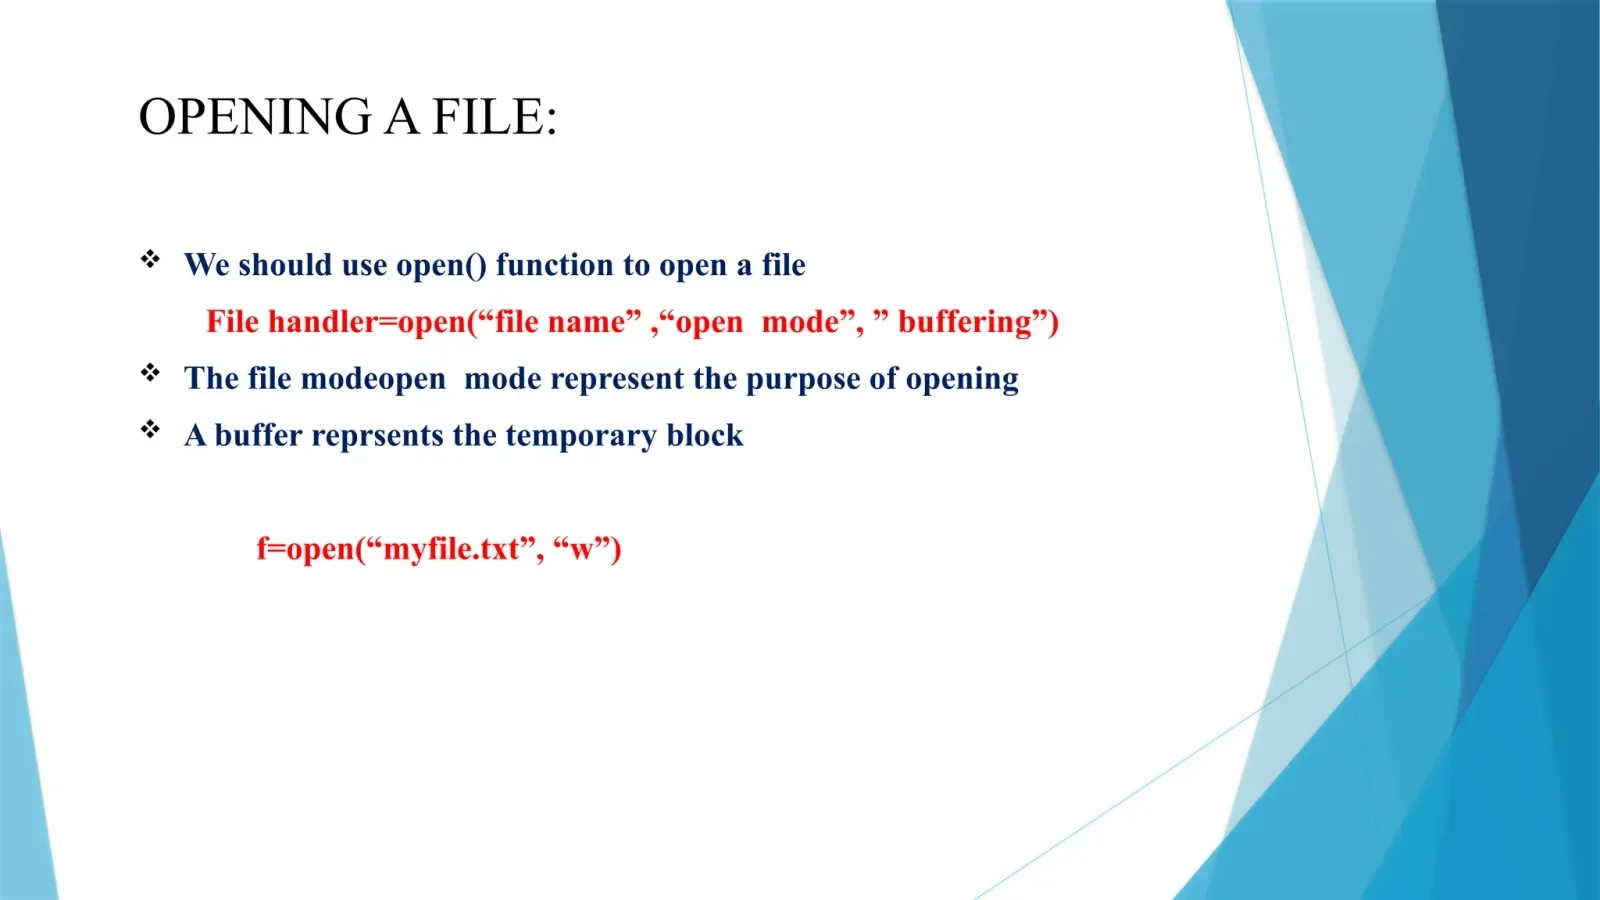
open()函数的buffering参数直接控制底层I/O缓冲策略。默认值为-1,表示采用系统推荐的缓冲大小(通常为8KB),在文本模式下若连接终端则启用行缓冲,否则使用块缓冲。文本模式与二进制模式的缓冲机制存在本质差异:文本模式的缓冲作用于原始字节流,读取后需经过解码层转换为字符串;而二进制模式直接操作字节。当需要实时捕获日志输出时,可显式设置buffering=1实现行缓冲,确保每读取一行即刷新;若处理海量连续数据,可设为buffering=65536等较大值以减少系统调用次数。需注意,buffering=0仅在二进制模式下合法,用于要求数据即时落盘的场景。合理配置该参数能显著平衡I/O延迟与吞吐量。
配置缓冲区并验证读取性能
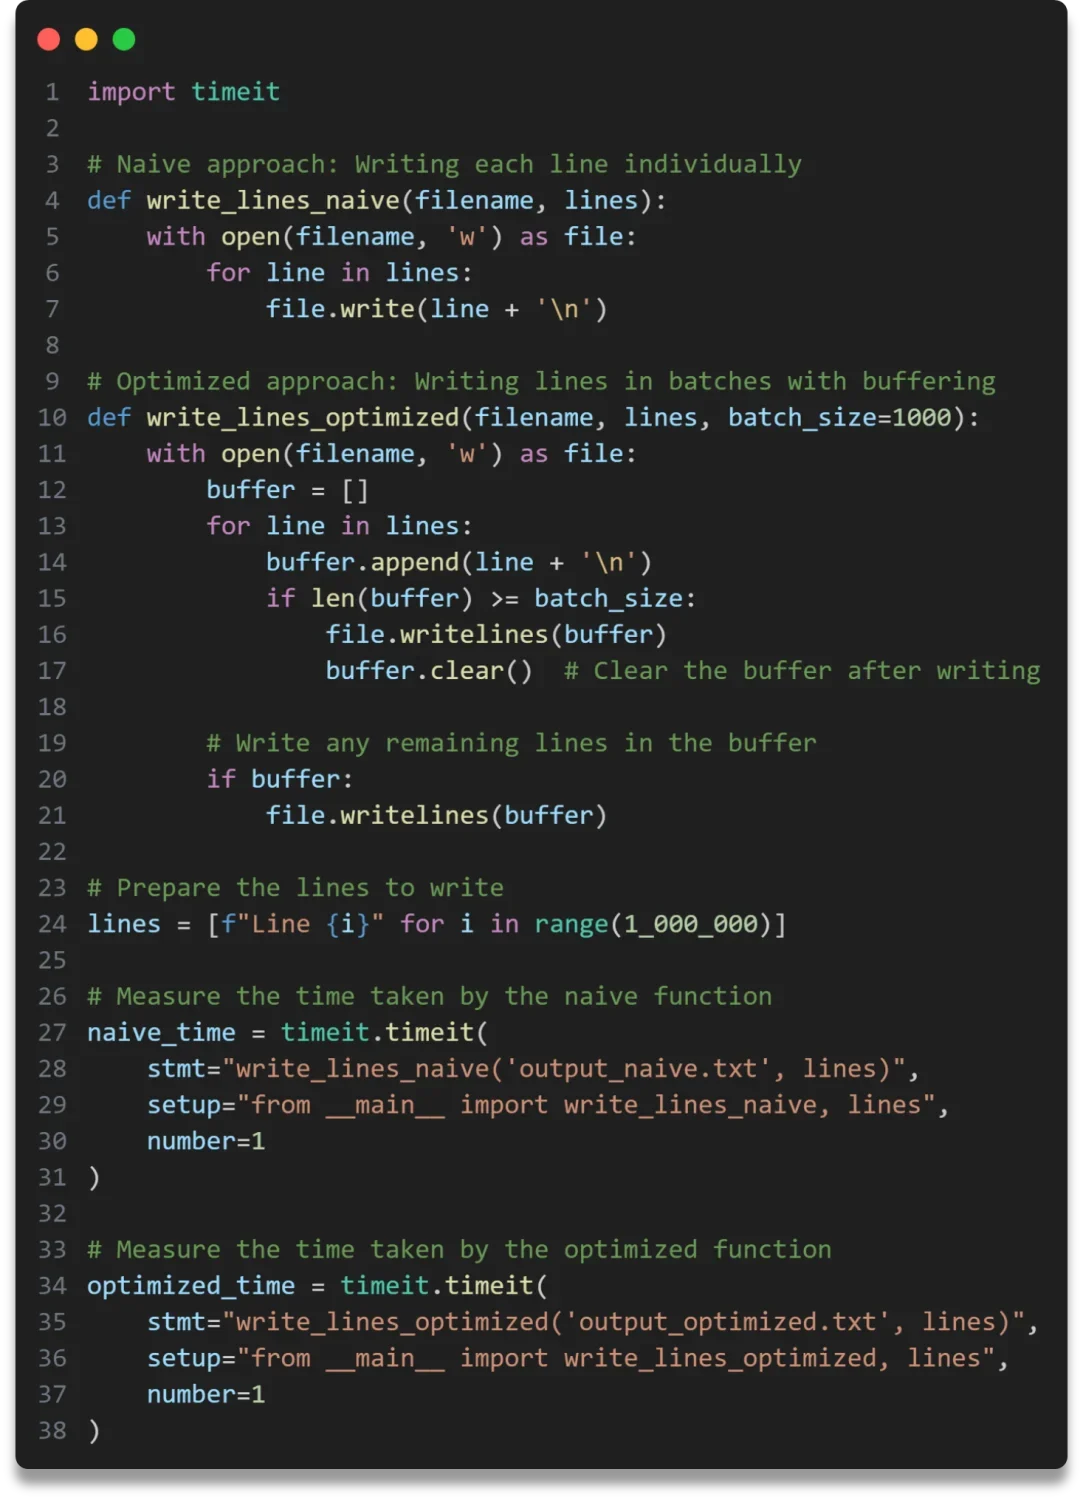
为验证缓冲区配置的实际效果,可编写基准测试脚本对比不同buffering值下的逐行读取耗时。测试逻辑为:生成约500MB的测试文件,分别以buffering=-1(系统默认)、buffering=1(行缓冲)和buffering=65536(64KB块缓冲)打开,使用for循环遍历并统计总耗时。实际运行表明,行缓冲因频繁触发底层系统调用,耗时通常比默认配置明显偏高;而64KB缓冲在机械硬盘上可能带来小幅读取加速,但在NVMe固态硬盘上差异微乎其微。这是因为现代操作系统已具备高效的预读机制,Python迭代器本身也进行了内部优化。测试代码可通过time.perf_counter()记录起止时间,并配合资源监控工具观察内存变化。开发者应依据实际硬件环境与业务延迟容忍度选择参数,避免脱离场景盲目调优。
常见误区与最佳实践
在实际开发中,开发者常陷入两个典型误区:其一是将for line in f.readlines()误认为逐行读取,该写法会先将全量数据载入列表,完全丧失迭代器的内存优势;其二是盲目将buffering设为极大值,期望提升性能,却忽略了过大的缓冲区会占用额外内存并可能掩盖底层I/O错误。最佳实践应遵循以下规范:始终使用with open('data.txt', 'r', encoding='utf-8') as f:结构,确保文件句柄在作用域结束时自动关闭,避免资源泄漏;显式声明encoding以消除跨平台默认编码差异;结合try...except捕获UnicodeDecodeError或OSError,对损坏文件进行降级处理或记录日志。规范的代码结构不仅提升健壮性,也为后续维护与性能调优奠定清晰基础。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















