


Python打开与读取文件操作的常用方法

本文系统化梳理 Python 文件读写核心流程,详解 open 函数多模式配置、read 与 readlines 场景化选取,以及 tell 与 seek 字节级指针控制,附参数对照与完成状态校验标准,助力快速构建稳定数据存取模块。
基础文件读写流程解析
在 Python 中,数据持久化与交互离不开文件对象。核心流程遵循“创建句柄 → 按需读取 → 释放资源 → 定位跳转”的逻辑。以下为标准化操作指南与避坑要点。
第1步:通过 open 函数创建并配置文件对象
目的:建立程序与外部文件的访问通道,为后续读写预留系统资源。
入口与动作:调用内置函数初始化句柄,接收路径参数后由底层 C 接口分配内存缓冲区。
file = open(filename, mode='r', buffering=-1)重要参数:
filename:目标文件名称或绝对/相对路径,字符串格式。同目录仅写文件名,跨目录需补全路径。mode:打开权限标识。默认为只读文本模式'r',也可设为'w'(覆盖写)、'a'(追加写)或加'b'切换二进制模式。buffering:I/O 缓冲策略。0关闭缓冲(仅限二进制流),1使用默认行缓冲,大于1表示自定义字节块大小。
完成状态校验:执行完毕且不抛 FileNotFoundError 等异常即表示句柄已就绪。务必注意:生产环境推荐结合上下文管理器 with open(...) as file: 自动保障资源释放,避免显式调用 close() 遗漏导致的文件损坏或锁死。
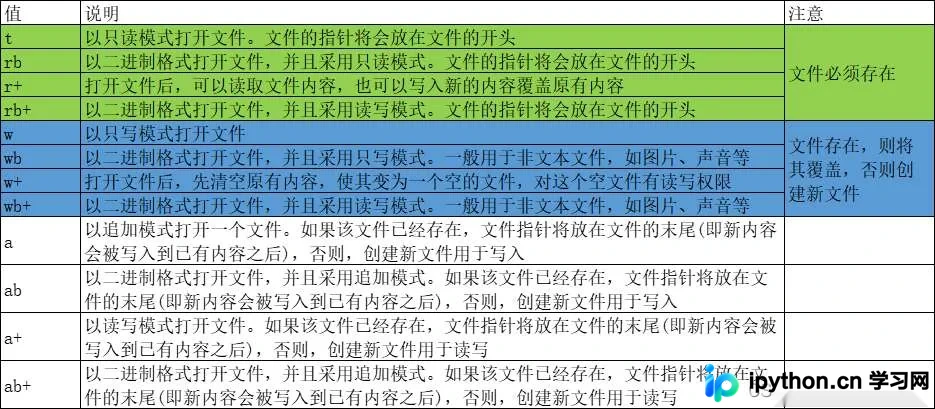
第2步:按数据规模选择 read、readline 或 readlines 读取内容
目的:匹配不同业务场景,以最小内存开销提取结构化或纯文本数据。
入口与动作:基于已打开的 file 对象触发相应读取指令。连续流式处理推荐使用迭代或逐行读取,避免一次性加载超大文件导致 OOM(内存溢出)。
# 读取前 N 个字符或字节
chunk = file.read(8)
# 单次提取完整换行符包裹的一行
single_line = file.readline()
# 拆分为列表,元素含换行符
all_lines = file.readlines()重要参数:size(仅 read() 适用)。值为正整数时限制读取长度;省略则返回剩余全部内容。需注意:read(size) 在文本模式下统计字符数,在二进制模式下统计字节数。若文件体积超出可用内存边界,该方法将无法正确读取而是返回空串,此时应改用循环迭代 for line in file: 分块处理。
完成状态校验:返回值类型为字符串(文本模式)或字节串(二进制模式)/列表。流读完尾时 read() 返回 b''/'',readline() 返回 b''/''。
第3步:使用 tell 与 seek 实现指针位移与位置校验
目的:支持非顺序访问、断点续传、跳过文件头标识或精准覆盖特定段落。
入口与动作:通过偏移量数学计算重新对齐内部游标,随后发起读写请求。
# 查询当前字节偏移量
current_pos = file.tell()
# 绝对定位或相对跳转
file.seek(offset=10, whence=0)
重要参数:
offset:移动步长整数。可正可负(向后回退),具体合法范围受whence约束。whence:基准坐标系。0(SEEK_SET)从文件头起算,1(SEEK_CUR)从当前位置叠加,2(SEEK_END)从文件尾部倒推。默认值为0。
完成状态校验:tell() 返回值严格代表距文件头的字节数。多字节编码(如 UTF-8 汉字占 3 字节、GBK 占 2 字节)下,该数值与“字符个数”呈非线性映射关系,跨编码迁移时需重新校准 seek() 偏移量。
以上就是 Python 打开与读取文件操作的常用详细内容,更多关于 Python 基础语法与文件处理技巧的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















