


Python迭代器:iter与next协议实现

理解迭代器协议与iter、next的工作机制
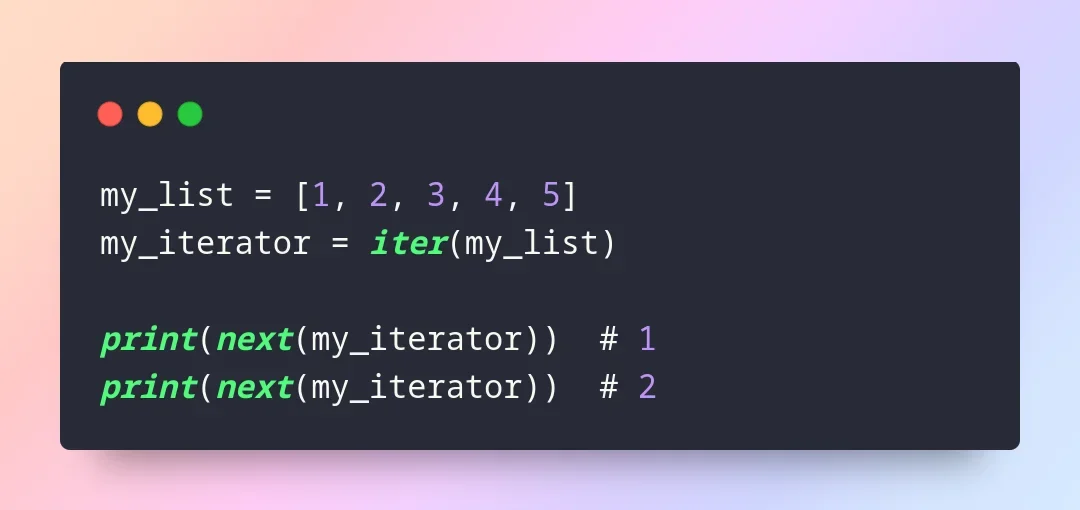
在Python中,可迭代对象(Iterable)与迭代器(Iterator)是两个密切相关但职责不同的概念。可迭代对象只需实现__iter__()方法,返回一个迭代器即可,例如列表、元组和字符串。而迭代器必须同时实现__iter__()和__next__()方法,其中__iter__()返回自身,__next__()负责返回序列中的下一个元素。内置函数iter(obj)会调用对象的__iter__()方法获取迭代器,而next(iterator)则调用其__next__()方法推进状态。例如,对列表lst = [1, 2, 3]执行it = iter(lst)后,it即为一个列表迭代器。连续调用next(it)会依次返回1、2、3。这种协议设计将数据容器与遍历逻辑解耦,使得Python的for循环能够统一处理各种数据结构,而无需关心底层实现细节。
实现一个自定义迭代器类
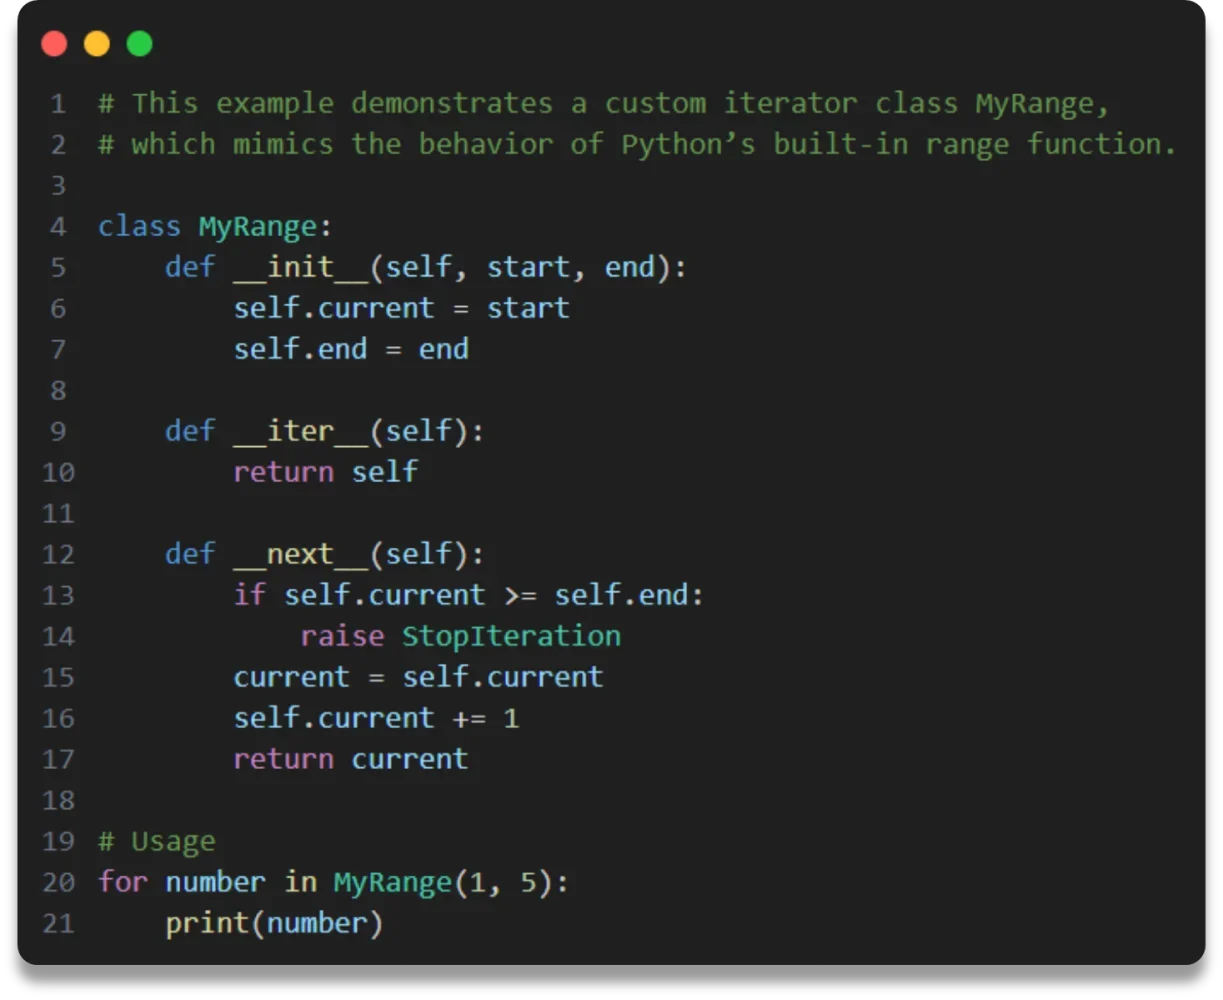
要实现一个符合迭代器协议的自定义类,核心在于正确维护内部状态并实现双下划线方法。以下是一个生成指定范围内偶数的迭代器示例:class EvenIterator:\n def __init__(self, limit):\n self.current = 0\n self.limit = limit\n def __iter__(self):\n return self\n def __next__(self):\n if self.current >= self.limit:\n raise StopIteration\n value = self.current\n self.current += 2\n return value\n在该实现中,__init__初始化起始值与上限;__iter__直接返回self,表明该实例本身就是迭代器;__next__负责计算并返回下一个偶数,同时更新self.current状态。实例化it = EvenIterator(6)后,可直接使用for num in it: print(num)进行遍历,输出结果为0、2、4。由于__iter__返回了自身,该对象天然兼容Python的迭代上下文,无需额外转换即可无缝接入for、sum()、list()等内置函数。
处理StopIteration并验证迭代器行为
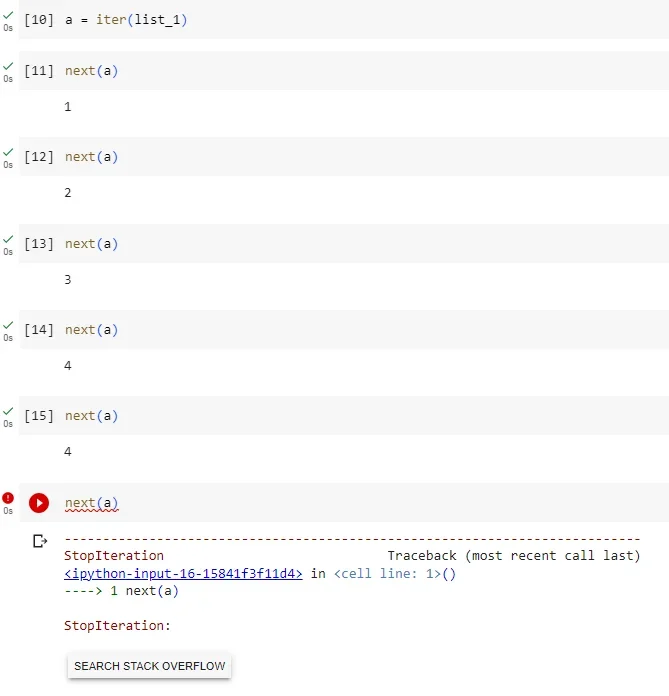
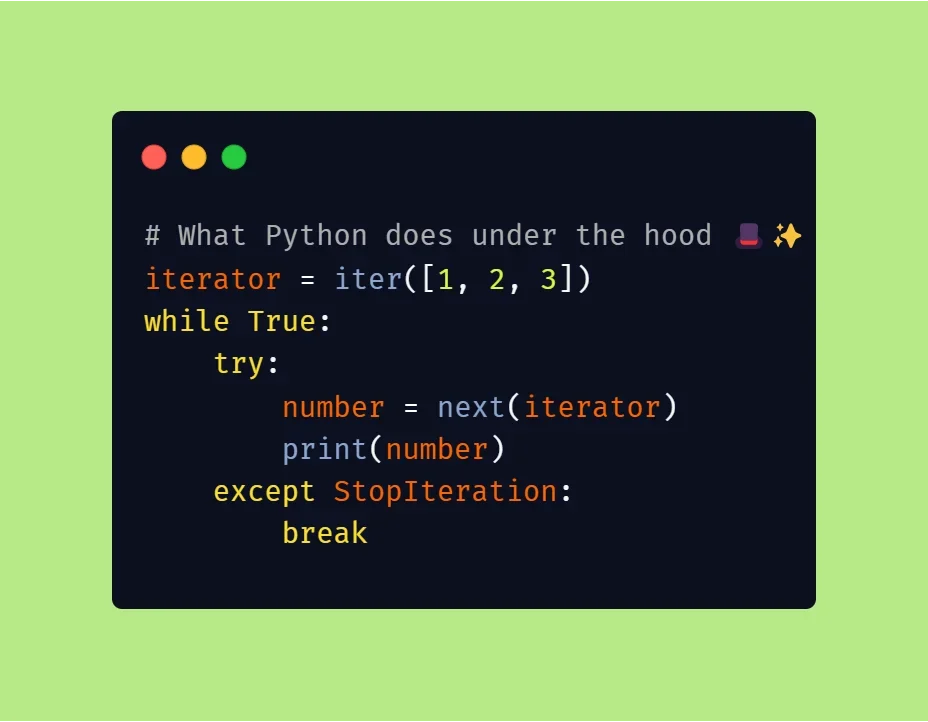
迭代器协议规定,当数据耗尽时,__next__()必须抛出StopIteration异常,这是Python识别遍历结束的唯一标准。若手动连续调用next(it),在元素取尽后程序将立即中断并报错。例如,对上述EvenIterator(6)连续调用四次next(),前三次正常返回,第四次将触发StopIteration。然而,在实际开发中极少手动调用next(),因为for循环底层已封装了异常捕获机制。for循环在每次迭代时隐式调用next(),一旦捕获到StopIteration,便会自动终止循环并清理迭代器,不会将异常暴露给上层代码。这种设计既保证了遍历的安全性,又避免了冗长的try-except块。开发者只需关注业务逻辑,无需手动处理终止信号,这也是Python迭代器优雅且高效的核心原因。
迭代器使用中的常见坑与实践选择
使用迭代器时需警惕几个典型陷阱。首先,迭代器是一次性消费品,遍历结束后内部状态已耗尽,再次使用for循环或list()将得到空结果,若需重复遍历应重新实例化或改用生成器。其次,__iter__()必须返回迭代器对象自身,若错误返回新迭代器或可迭代对象,会导致无限循环或状态混乱。此外,next(iterator, default)可安全获取默认值而不抛异常,适用于不确定长度的流式数据。实践中,迭代器适用于内存受限的大文件读取、无限序列生成或惰性计算场景;而普通列表等可迭代对象更适合需要多次随机访问、切片或频繁修改的数据集。明确区分两者边界,能有效避免状态污染与性能损耗,提升代码的健壮性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















