


Java switch-case 声明变量报错原理及作用域解析

在使用Java编写 switch-case 结构时,开发者常遇到“局部变量重复”或“变量可能未被初始化”的编译错误。这些问题的根源在于Java对变量作用域的严格规定以及代码执行的线性逻辑限制。本文将深入解析这两种常见报错场景及其背后的作用域机制,并提供正确的编码范式。
switch 中的两大常见报错场景
在 Java 的 switch 语句块内操作变量时,编译器会对变量的定义位置和使用路径进行静态检查。以下是两种典型的错误写法:
第1步:排查“Duplicate local variable”(局部变量重复)
目的:理解为何在不同分支声明同名变量会报错。
入口:switch 结构中多个 case 标签。
动作:在同一个 switch 大括号范围内,为不同的 case 分支分别定义了相同名称的局部变量。
switch (type) {
    case 1:
        String test; // 在 case 1 中定义
        ...
        break;
    case 2:
        String test; // 在 case 2 中再次定义,编译报错
        ...
        break;
}
原因: Java 将 switch 的大括号 {} 视为一个整体的块(Block)。在这个块内存在唯一的作用域。虽然执行逻辑上两个分支互斥,但编译器无法动态确认具体会走哪个分支,因此在同一个作用域内不允许出现重复定义的局部变量标识符。
第2步:排查“may not have been initialized”(可能未初始化)
目的:理解为何变量虽只定义一次,仍可能报错。
入口:switch 内部变量引用处。
动作:变量在一个 case 中定义并赋值,但在另一个 case 中尝试使用。
switch (type) {
    case 1:
        String test;           // 仅在 case 1 作用域有效
        test = "my error";     // 初始化仅在此分支执行
        ...
        break;
    case 2:
        System.out.print(test); // 访问变量,编译报错!
        ...
        break;
}
原因: Java 要求变量在被使用前必须完成初始化。当程序流经 case 2 时,由于跳过了 case 1 中的初始化语句,test 实际上处于未初始化状态。出于安全性考虑,编译器禁止这种潜在的不安全操作。
正确的处理与最佳实践
要修复上述问题,核心原则是确保变量在使用前已被所有可能的执行路径初始化,或缩小变量的作用域范围。
方案一:提升作用域至 switch 外部
这是最通用的做法。先定义变量,再在具体的 case 中进行赋值或使用。
// 正确写法示例
String result;
switch (type) {
    case 1:
        result = "Value 1";
        break;
    case 2:
        result = "Value 2";
        break;
    default:
        result = "Default";
}
// 此时 result 一定已初始化
方案二:利用代码块隔离作用域
如果必须在 switch 内部声明变量且仅限当前分支使用,可以通过额外的花括号 { } 创建子作用域。
switch (type) {
    case 1: {
        String temp = "Only valid here";
        // 使用 temp...
        break;
    }
    case 2:
        // temp 不存在,不会干扰其他分支
        break;
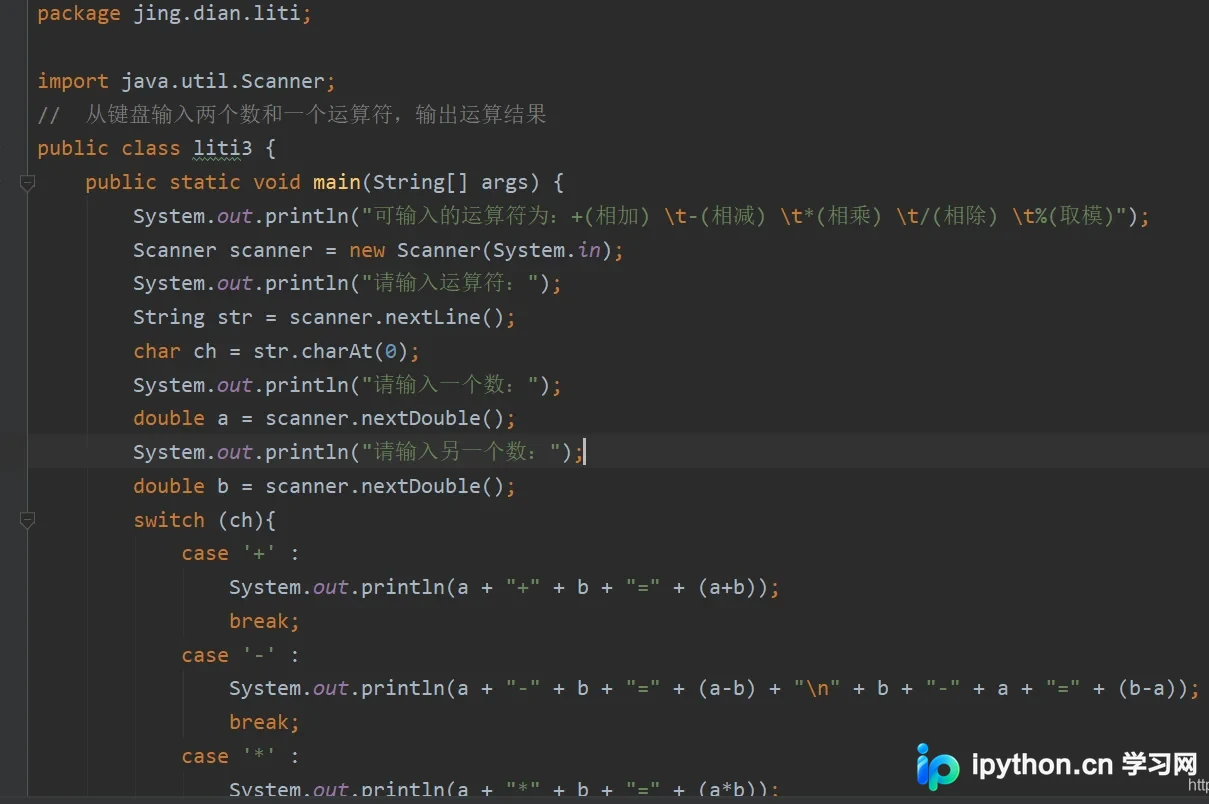
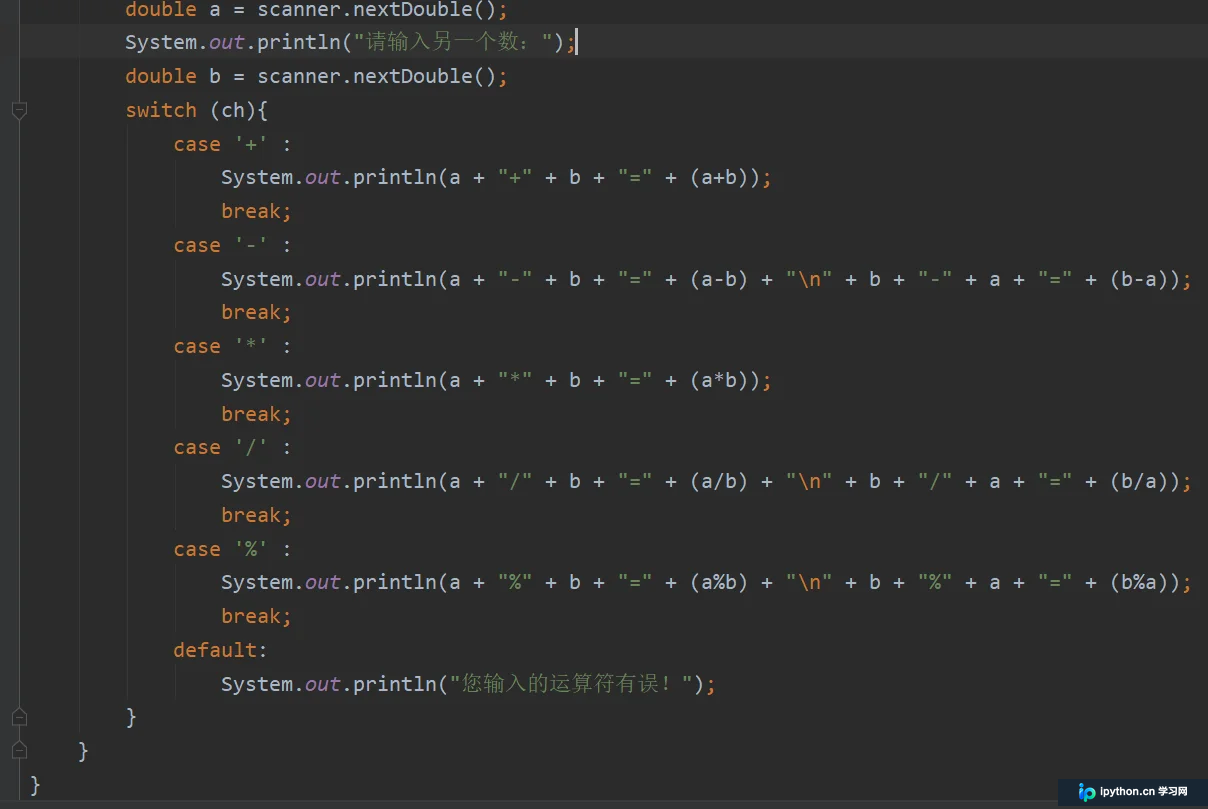
}
深入理解 Java 变量作用域
上述报错的本质是对 变量作用域(Scope) 规则的误用。Java 支持四种主要的变量作用域级别:
- 类级(Class Level / Static): 通过
static关键字修饰。它在类加载时创建,占用类内存,可通过ClassName.varName访问。其生命周期贯穿整个应用程序运行期。 - 对象实例级(Instance Level): 即成员变量。不属于任何方法,属于类的属性。必须通过对象实例化后才能访问,随着对象的消亡而销毁。
- 方法级(Method Level): 在方法体内部定义的变量。仅在该方法执行期间有效,方法结束即回收。
- 块级(Block Level): 定义在由
{ }包围的代码块内部(如if、for、switch或自定义块)。变量的生存周期仅限于该块被执行完。一旦离开该块(即跳出case或循环),变量即被销毁。
正是由于 switch-case 共享一个大括号块级作用域,才导致了前文所述的冲突。
对比 C++ 的差异:
C++ 对待 switch-case 更为严格。根据《C++ Primer》的描述,C++ 严禁跨过变量的初始化语句直接跳到该变量作用域的另一位置。这意味着在 C++ 的 case 中,通常不能在初始化之后直接跳转使用,往往需要通过封装函数或提前声明来规避跳转导致的初始化遗漏。
switch-case 基础用法回顾
为了确保代码规范性,需注意以下 switch 语句的使用规范:
- 表达式类型: 条件表达式只能接受
int(含 Byte/Short/Char)、enum以及 Java 7 起支持的String类型。 - default 分支: 用于处理所有未匹配的情况,非必需,但建议保留以防止遗漏。
- 穿透性(Fall-through): 若
case后的语句未加break,程序将继续执行下一个case的语句,直到遇见break或结束。常用于多分支共用同一段逻辑。 - 无需大括号包裹语句: 单个
case内部的执行语句不需要额外使用{}包裹,除非需要限定某个变量的作用域。
以上就是在 Java switch-case 中处理变量作用域和避免报错的详细内容,更多关于 Java 基础语法优化的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















