


Python实战:爬取并分析疫情期间的网络谣言数据

发布时间:2026-10-13 |
6人浏览过
本文详细介绍如何使用Python爬取权威辟谣平台数据,并通过Pandas和Matplotlib进行可视化分析。文章涵盖从数据抓取、清洗嵌套列表关键字,到绘制谣言真假占比饼图及高频关键字柱状图的全过程,帮助读者掌握利用编程手段进行舆情数据分析的完整技能。
数据抓取与爬虫实现
一、数据抓取
为了节省篇幅,这里直接提供可运行的完整代码。
import requests
import pandas as pd
class SpiderRumor(object):
 def __init__(self):
 self.url = "https://vp.fact.qq.com/loadmore?artnum=0&page=%s"
 self.header = {
  "User-Agent": "Mozilla/5.0 (iPhone; CPU iPhone OS 11_0 like Mac OS X) AppleWebKit/604.1.38 (KHTML, like Gecko) Version/11.0 Mobile/15A372 Safari/604.1",
 }
 def spider_run(self):
 df_all = list()
 for url in [self.url % i for i in range(30)]:
  data_list = requests.get(url, headers=self.header).json()["content"]
  temp_data = [[df["title"], df["date"], df["result"], df["explain"], df["tag"]] for df in data_list]
  df_all.extend(temp_data)
  print(temp_data[0])
 pd.DataFrame(df_all, columns=["title", "date", "result", "explain", "tag"]).to_csv("冠状病毒谣言数据.csv", encoding="utf_8_sig")
if __name__ == '__main__':
 spider = SpiderRumor()
 spider.spider_run()
爬虫实现逻辑
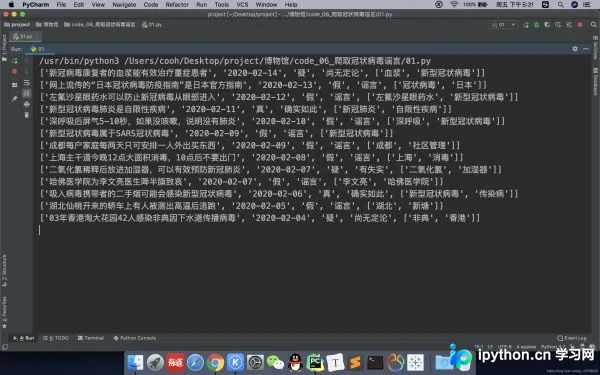
疫情谣言数据分析与可视化
二、数据分析
数据可视化展示
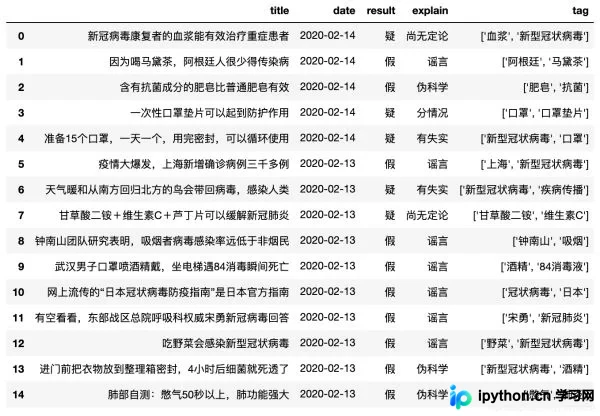
每日谣言数量统计
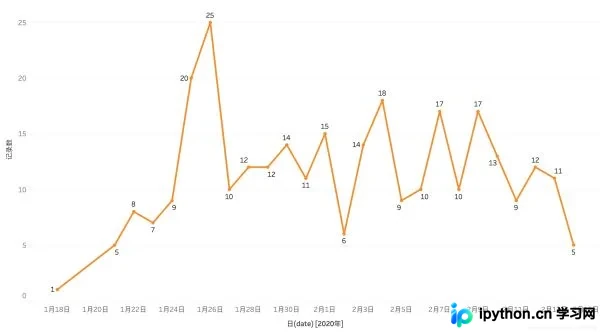
从图表中可以观察到,1月24日和1月25日出现了谣言发布的高峰期。接下来我们将重点分析这两天的具体数据情况。
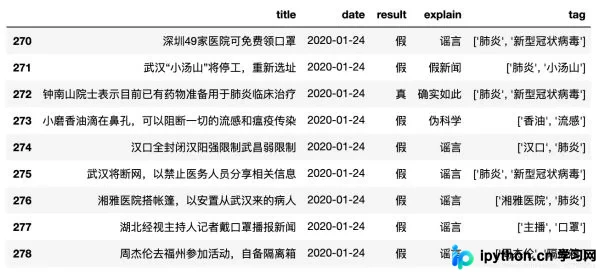
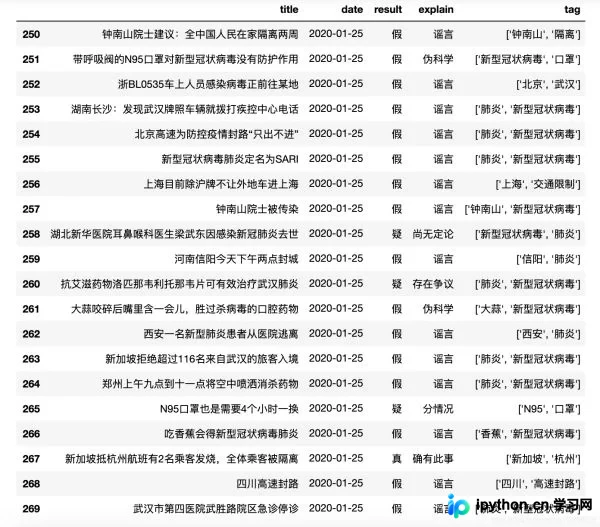
根据上图数据显示,在1月24日传播的29条谣言中,有96.55%被证实为虚假信息。
谣言真实性分布比例
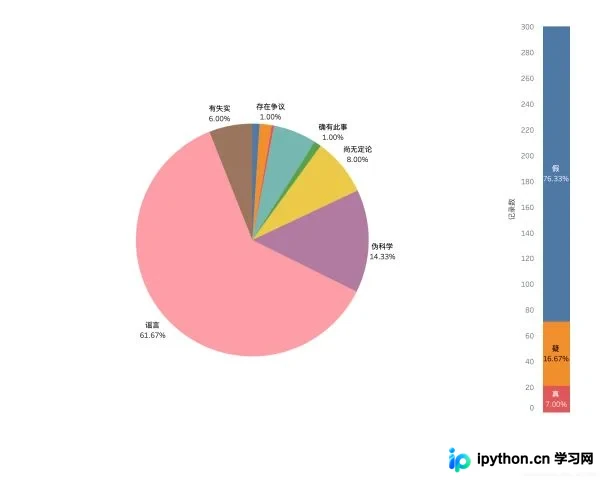
统计周期从1月18日至2月14日,共计发现300条相关谣言。右上图显示,其中76.33%为假谣言,仅有7.00%为真实信息。此外,14.33%的谣言属于伪科学范畴,另有8.00%属于尚无定论或凭空捏造的内容,这部分需要引起高度关注⚠️。
谣言高频关键字展示
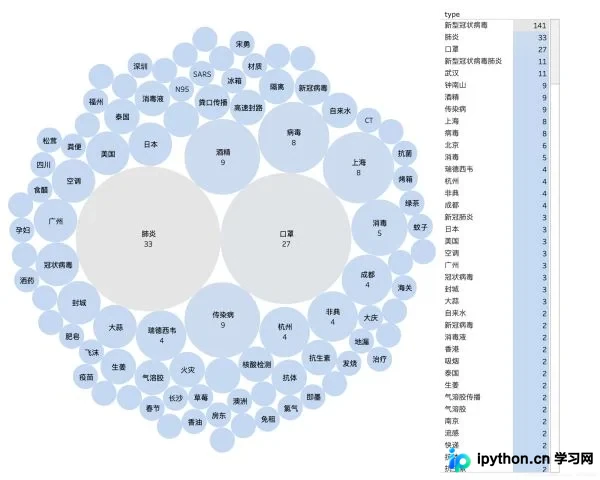
下面将介绍使用matplotlib库绘制饼图的具体代码实现。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
# Windows系统设置中文字体
plt.rcParams['font.sans-serif']=['SimHei']
plt.rcParams['axes.unicode_minus'] = False
data = pd.read_csv("/冠状病毒谣言数据.csv"")
labels = data["explain"].value_counts().index.tolist()
sizes = data["explain"].value_counts().values.tolist()
colors = ['lightgreen', 'gold', 'lightskyblue', 'lightcoral']
plt.figure(figsize=(15,8))
plt.pie(sizes, labels=labels,
 colors=colors, autopct='%1.1f%%', shadow=True, startangle=50) # shadow=True 表示阴影
plt.axis('equal') # 使图居中
plt.show()
绘制谣言关键字分布图(基于tag字段分析)
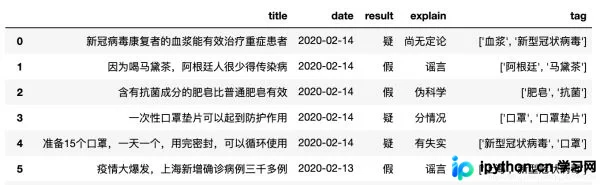
由于tag字段存储的是列表格式,直接提取后会形成嵌套列表结构,例如[[a, b], [b, c], [c, d]]。为了快速提取所有关键字,可以使用一行列表生成式:[j for i in a for j in i]。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
# Windows系统设置中文字体
plt.rcParams['font.sans-serif']=['SimHei']
plt.rcParams['axes.unicode_minus'] = False

data = pd.read_csv("/冠状病毒谣言数据.csv"")
df = pd.Series([j for i in [eval(i) for i in data["tag"].tolist()] for j in i]).value_counts()[:20]
X = df.index.tolist()
y = df.values.tolist()
plt.figure(figsize=(15, 8)) # 设置画布
plt.bar(X, y, color="orange")
plt.tight_layout()
# plt.grid(axis="y")
plt.grid(ls='-.')
plt.show()
总结
以上介绍了利用Python爬取新型冠状病毒相关谣言新闻并进行数据分析的全过程,希望这些内容能对读者在数据抓取与分析方面有所帮助。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















