


Python利用BS4与正则提取HTML正文文本框

发布时间:2026-10-13 |
4人浏览过
本文介绍使用Python从HTML页面中提取主要文本框的方法。通过BS4遍历所有div标签,利用正则表达式筛选并统计每个div内的中文字数,最终选取中文内容最长的div作为正文区域。文章提供了完整的requests请求、正则匹配及BeautifulSoup解析代码示例,适用于CSDN等博客类网站的正文抓取场景。
Python识别HTML正文文本框概述
本文详细解析了使用Python识别HTML页面中主要文本框的技术过程。文中通过具体的示例代码展示了实现细节,内容详实,对从事网页抓取或数据分析工作的读者具有较高的参考价值。
抓取目标与核心思路
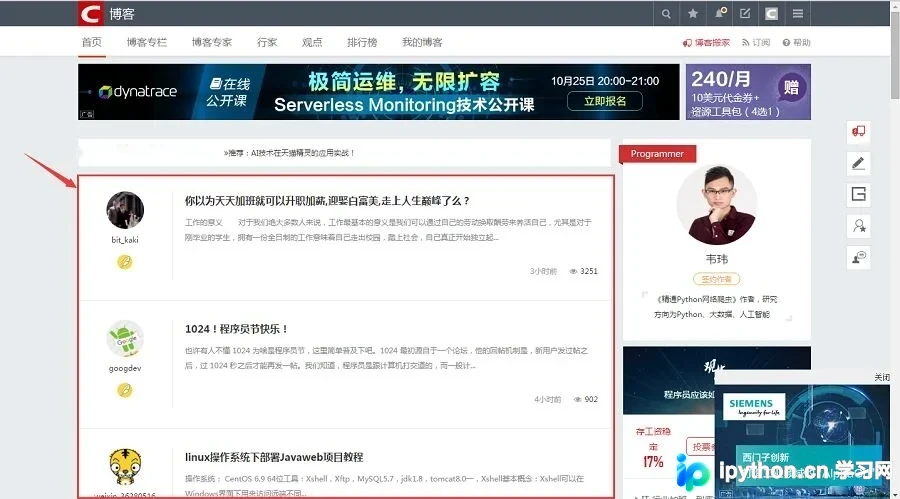
在进行网页数据抓取时,通常只需要获取页面的核心文本内容。以CSDN博客为例,其主要文本区域通常由特定的HTML结构包裹,如所示的红色框选区域。
获取网页内容头部定义
抓取的核心思路是利用BS4库查找页面中所有的div元素,随后使用正则表达式筛选出每个div中包含的中文内容。通过比较各div内中文字数的多少,确定中文字数最多的div即为正文所在的div。首先定义一个用于获取网页内容的头部信息:
import requests
headers = {
  'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/47.0.2526.106 Safari/537.36',
  'Host': 'blog.csdn.net'}
session = requests.session()

def getHtmlByRequests(url):
  headers.update(
    dict(Referer=url, Accept="*/*", Connection="keep-alive"))
  htmlContent = session.get(url=url, headers=headers).content
  return htmlContent.decode("utf-8", "ignore")
中文内容正则匹配规则
接下来定义用于识别每个div中中文内容的正则表达式模式:
import re
# 统计中文字数
def countContent(string):
  pattern = re.compile(u'[\u1100-\uFFFD]+?')
  content = pattern.findall(string)
  return content
遍历Div并定位最长文本
随后遍历页面中的每一个div,利用上述正则表达式判断并计算其中中文内容的长度,从而找出长度最长的div元素:
# 分析页面信息
def analyzeHtml(html):
  # 初始化网页
  soup = BeautifulSoup(html, "html.parser")
  part = soup.select('div')
  match = ""
  for paragraph in part:
    content = countContent(str(paragraph))
    if len(content) > len(match):
      match = str(paragraph)
  return match
提取主要Div文本内容
在定位到主要的div元素后,进一步提取该div内部的纯文本内容:
def main():
  url = "http://blog.csdn.net/"
  html = getHtmlByRequests(url)
  mainContent = analyzeHtml(html)
  soup = BeautifulSoup(mainContent, "html.parser")
  print(soup.select('div')[0].text)
完整代码实现
以下是整合上述步骤的完整Python代码实现:
#!/usr/bin/env python
# -*- coding: utf-8 -*-

from bs4 import BeautifulSoup
import requests
import re

headers = {
  'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/47.0.2526.106 Safari/537.36',
  'Host': 'blog.csdn.net'}
session = requests.session()


def getHtmlByRequests(url):
  headers.update(
    dict(Referer=url, Accept="*/*", Connection="keep-alive"))
  htmlContent = session.get(url=url, headers=headers).content
  return htmlContent.decode("utf-8", "ignore")

# 统计中文字数
def countContent(string):
  pattern = re.compile(u'[\u1100-\uFFFD]+?')
  content = pattern.findall(string)
  return content

# 分析页面信息
def analyzeHtml(html):
  # 初始化网页
  soup = BeautifulSoup(html, "html.parser")
  part = soup.select('div')
  match = ""
  for paragraph in part:
    content = countContent(str(paragraph))
    if len(content) > len(match):
      match = str(paragraph)
  return match


def main():
  url = "http://blog.csdn.net/"
  html = getHtmlByRequests(url)
  mainContent = analyzeHtml(html)
  soup = BeautifulSoup(mainContent, "html.parser")
  print(soup.select('div')[0].text)


if __name__ == '__main__':
  main()
以上即为本文的全部内容,希望这些代码示例能对您的学习或工作有所帮助。如需更多技术支持,欢迎持续关注本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















