


Python 解决 CSV 文件乱码:utf-8-sig 编码详解

本文详细解析 Python 写入 CSV 文件时出现乱码的原因及解决方案。通过对比不指定编码、utf-8 和 utf-8-sig 三种方式,指出 Excel 读取 CSV 依赖文件头部的 BOM 信息。推荐使用 utf-8-sig 编码格式,确保中文等多字节字符在 Excel 中正常显示,同时适用于 txt 文件写入。
Python CSV 与 TXT 编码对比示例
首先通过具体示例,分别采用 不指定编码、指定编码为 utf-8 以及 指定编码为 utf-8-sig 这三种不同策略进行对比,并将结果应用于写入 csv 文件与 txt 文件的场景中,以观察差异。
不指定编码存入 CSV
一、不指定编码方式,直接存入 csv 文件
import csv

with open('test.csv', 'w') as fp:
 writer = csv.writer(fp)
 writer.writerow(['汉语', '俄语', '韩语', '日语', '英语'])
 writer.writerow(['爱你', 'люблю тебя', '사랑해요', '愛しています', 'love you'])
在此情况下运行程序,系统会抛出如下错误信息:
UnicodeEncodeError: 'gbk' codec can't encode character '\uc0ac' in position 14: illegal multibyte sequence
指定 utf-8 编码存入 CSV
二、指定编码为 utf-8,再存入 csv 文件
接下来尝试将内容以 utf-8 编码方式存入 test.csv 文件中,观察发现除了英文字符外,其他语言字符均显示为乱码:
import csv

with open('test.csv', 'w', encoding='utf-8') as fp:
 writer = csv.writer(fp)
 writer.writerow(['汉语', '俄语', '韩语', '日语', '英语'])
 writer.writerow(['爱你', 'люблю тебя', '사랑해요', '愛しています', 'love you'])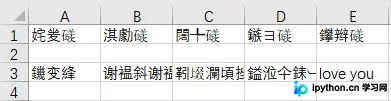
指定 utf-8-sig 编码存入 CSV
三、指定编码为 utf-8-sig,再存入 csv 文件
当将编码方式更换为 utf-8-sig 之后,文件内容显示恢复正常:
import csv

with open('test.csv', 'w', encoding='utf-8-sig') as fp:
 writer = csv.writer(fp)
 writer.writerow(['汉语', '俄语', '韩语', '日语', '英语'])
 writer.writerow(['爱你', 'люблю тебя', '사랑해요', '愛しています', 'love you'])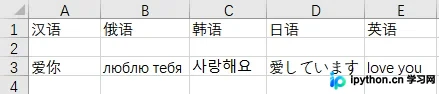
不指定编码存入 TXT
四、不指定编码方式,直接存入 txt 文件
with open('test.txt','w') as fp:
 fp.write('爱你, люблю тебя, 사랑해요, 愛しています, love you')
与存入 csv 文件的情况类似,同样会触发以下错误:
UnicodeEncodeError: 'gbk' codec can't encode character '\uc0ac' in position 16: illegal multibyte sequence
指定编码存入 TXT
五、指定编码为 utf-8 / utf-8-sig,再存入 txt 文件
分别以 utf-8 或者 utf-8-sig 编码方式存入 test.txt 文件中,内容显示均完全正常:
ith open('test.txt','w', encoding='utf-8') as fp:
  fp.write('爱你, люблю тебя, 사랑해요, 愛しています, love you')

with open('test.txt','w', encoding='utf-8-sig') as fp:
  fp.write('爱你, люблю тебя, 사랑해요, 愛しています, love you')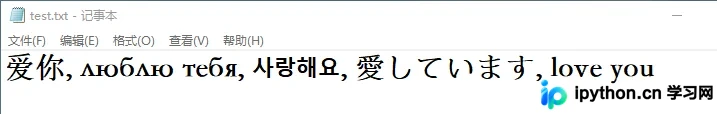
utf-8 与 utf-8-sig 的区别
utf-8 与 utf-8-sig 有什么区别?
utf-8以字节为编码单元,其字节顺序在所有系统中保持一致,不存在字节序问题,因此实际上并不需要 BOM;uft-8-sig中 sig 全拼为 signature,即带有签名的 utf-8(UTF-8 with BOM);BOM全称 ByteOrder Mark,字节顺序标记,出现在文本文件头部,Unicode 编码标准中用于标识文件是采用哪种格式的编码。
CSV 文件使用 utf-8-sig 的原因
为什么写入 csv 文件要用 utf-8-sig 编码?
- Excel 在读取 csv 文件时,是通过读取文件头上的 BOM 来识别编码格式的。如果文件头没有 BOM 信息,Excel 则默认按照 Unicode 编码进行读取。
- 当我们使用 utf-8 编码来生成 csv 文件时,由于并未生成 BOM 信息,Excel 会自动按照 Unicode 编码读取,从而导致出现乱码问题。
TXT 文件使用 utf-8 编码的原因
为什么写入 txt 文件要用 utf-8 编码?
在写入 txt 文件时,Windows 系统会默认尝试转码为 gbk。如果遇到某些 gbk 不支持的字符,就会报错。如果在打开文件时明确声明编码方式为 utf-8,就能避免这个错误。
知识点扩展:utf-8 与 utf-8-sig 详细区别
知识点扩展:
utf-8 和 utf-8-sig 的区别
前言:在写入 csv 文件中,出现了乱码的问题。
解决:utf-8 改为 utf-8-sig
区别如下:
1、”utf-8“ 是以字节为编码单元,它的字节顺序在所有系统中都是一样的,没有字节序问题,因此它不需要 BOM,所以当用 "utf-8" 编码方式读取带有 BOM 的文件时,它会把 BOM 当做是文件内容来处理,也就会发生类似上边的错误。
2、“uft-8-sig" 中 sig 全拼为 signature,也就是 "带有签名的 utf-8",因此 "utf-8-sig" 读取带有 BOM 的 "utf-8 文件时" 会把 BOM 单独处理,与文本内容隔离开,也是我们期望的结果。
总结
以上所述是小编给大家介绍的 Python 利用 utf-8-sig 编码格式解决写入 csv 文件乱码问题,希望对大家有所帮助,也非常感谢大家对本站网站的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















