


Python数据清洗:缺失值处理与异常值检测

识别数据质量问题:缺失值与异常值概览
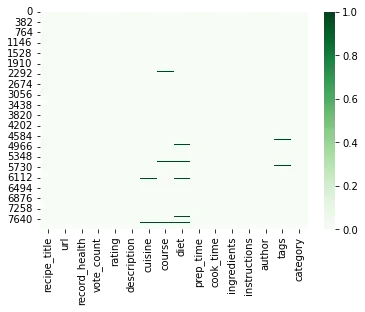
在数据清洗的初始阶段,准确识别数据质量问题是构建可靠分析模型的前提。缺失值通常由数据采集设备故障、用户未填写或系统传输中断导致,可分为完全随机缺失、随机缺失与非随机缺失三种类型。异常值则可能源于录入错误、测量偏差或真实的极端业务场景。使用Pandas进行快速探查时,可通过df.isnull().sum()统计各列缺失数量,结合df.info()查看数据类型与内存占用。进一步利用df.describe()获取数值型字段的均值、标准差与分位数,初步判断数据分布形态。对于分类字段,可使用value_counts()观察类别频次,识别低频或异常类别。建立这一基线后,数据分析师能够清晰掌握数据全貌,避免在后续处理中盲目操作,为制定针对性的清洗策略提供客观依据。
处理缺失值:删除、填补与分组策略
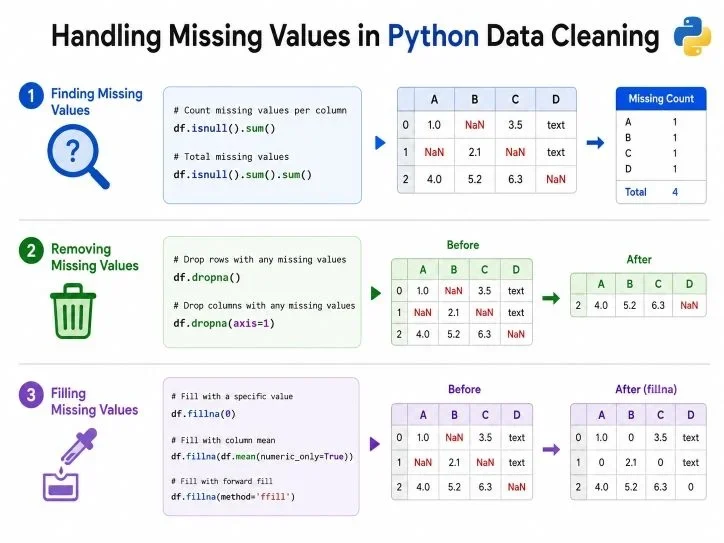
处理缺失值需综合考量缺失比例、字段属性及业务逻辑,切忌一刀切。当某列缺失率超过百分之七十且对核心分析无直接贡献时,可使用df.dropna(axis=1)直接删除该列;若缺失集中在少数样本,则通过df.dropna()剔除无效行。对于数值型字段,若缺失率较低且数据近似正态分布,可采用均值填补;若存在明显偏态或极端值,中位数更为稳健。分类字段推荐使用众数填补,或结合业务含义赋予未知标签。更精细的策略是分组填补,例如按城市分组后计算各组的平均收入进行填充:df['income'].fillna(df.groupby('city')['income'].transform('mean'))。合理选择策略能有效保留数据信息量,防止因随意填补引入系统性偏差。
检测异常值:统计方法与可视化判断
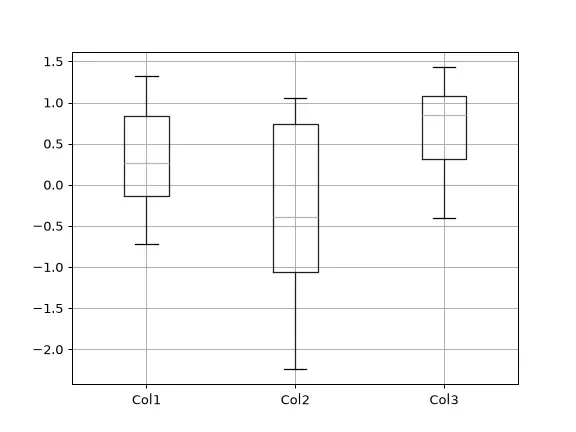
异常值检测需结合统计计算与可视化手段,以区分数据噪声与真实业务极值。四分位距法是常用且稳健的统计方法:首先计算第一四分位数Q1与第三四分位数Q3,得出IQR等于Q3减Q1,将小于Q1减一点五倍IQR或大于Q3加一点五倍IQR的记录标记为异常。在Python中可通过scipy.stats.zscore计算Z-score,通常将绝对值大于三的观测值视为偏离常态。配合Matplotlib或Seaborn绘制箱线图与散点图,能直观呈现异常点分布。需特别注意,统计异常不等于业务异常。例如电商大促期间的订单量激增在统计上属离群点,但具有明确业务合理性,应予以保留;而年龄字段出现负数或负数金额则属录入错误,需修正或剔除。结合领域知识进行交叉验证,是确保异常值处理科学性的关键。
清洗后验证:对比结果与常见避坑
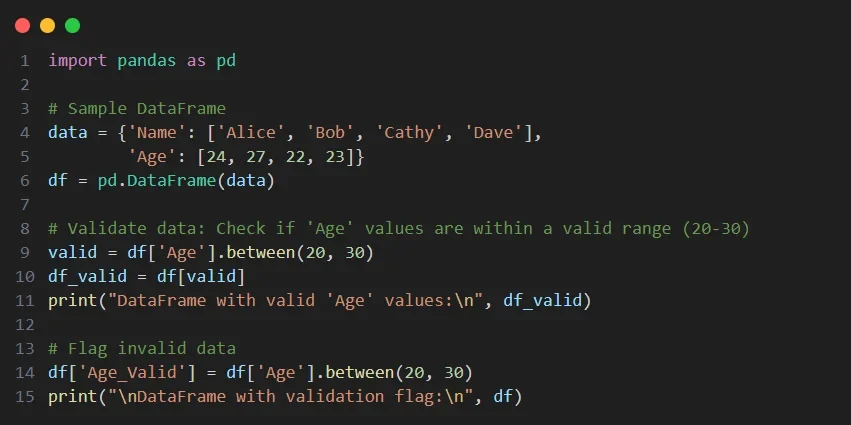
数据清洗完成后,必须通过量化指标进行严格验证,确保处理过程未破坏原始数据结构。首先对比清洗前后的数据行数与缺失率,确认删除或填补操作符合预期阈值。利用df.describe()与直方图检查数值分布是否发生畸变,例如均值填补可能导致方差人为缩小,此时需评估是否改用多重插补。统计异常值数量变化,验证剔除逻辑是否精准。常见避坑要点包括:避免过度删除导致样本量不足或代表性丧失;严禁在划分训练集与测试集前进行全局填补,以防数据泄漏;填补策略需与下游模型假设匹配,如树模型对缺失值容忍度高,而线性模型则敏感。最后,所有清洗步骤应记录为可复现的代码流水线,并对照业务规则进行最终逻辑校验,确保输出数据集既干净又具备分析价值。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















