



Pandas 里最常用、也最容易“会一点但总用不顺”的功能之一,就是 df.groupby()。它背后的核心思路是“分裂-应用-组合”:先把数据按维度拆成多个组,再对每组执行计算,最后把结果重新拼回来。
这篇文章按实际使用顺序来讲:先弄清 groupby 到底返回什么,再区分聚合、广播和整组筛选,最后补上链式写法与性能判断。看完后,你可以更快判断一个分组需求该落在 agg()、transform()、filter() 还是 apply() 上。
先理解 GroupBy 对象是什么
创建 GroupBy 对象
import pandas as pd
import numpy as np

df = pd.DataFrame({
    '部门': ['销售', '销售', '技术', '技术', '人事', '人事'],
    '员工': ['张三', '李四', '王五', '赵六', '钱七', '孙八'],
    '工资': [8000, 9000, 15000, 12000, 7000, 7500],
    '奖金': [2000, 2500, 3000, 3500, 1500, 1800],
    '入职年份': [2019, 2021, 2018, 2020, 2022, 2021]
})

# 按单列分组
grouped = df.groupby('部门')
# 返回 DataFrameGroupBy 对象,尚未执行任何计算

# 按多列分组
multi_grouped = df.groupby(['部门', '入职年份'])

# 查看分组
print(grouped.groups)        # 返回 {组名: 行索引列表}
print(grouped.indices)       # 同上但返回 numpy 数组
print(grouped.ngroups)       # 分组数量
for name, group in grouped:
    print(name, group.shape) # 遍历每个组
这里最关键的一点是:groupby 本身通常不会立刻计算,它先返回一个 DataFrameGroupBy 对象。真正触发计算的,是后面的 sum()、mean()、agg()、transform() 等操作。
如果你经常疑惑“为什么我已经分组了却还没结果”,原因通常就在这里:groupby 是惰性的。
聚合:先解决大多数统计汇总问题
单列聚合怎么写
# 对单个列聚合
print(grouped['工资'].sum())       # 每组工资总和
print(grouped['工资'].mean())      # 每组工资均值
print(grouped['工资'].count())     # 每组非空计数
print(grouped['工资'].std())       # 标准差
print(grouped['工资'].min())       # 最小值
print(grouped['工资'].max())       # 最大值
print(grouped['工资'].median())    # 中位数
print(grouped['工资'].first())     # 第一个值
print(grouped['工资'].last())      # 最后一个值
print(grouped['工资'].nunique())   # 唯一值数
print(grouped['工资'].var())       # 方差
print(grouped['工资'].sem())       # 均值的标准误差
print(grouped['工资'].quantile(0.75))  # 0.75 分位数
这种写法适合快速拿某一个指标,比如“每个部门的平均工资”或“每组最大值”。如果你只需要一个统计量,这是最直接的入口。
一次算多个指标,优先用 agg()
# 方式一: 传入函数列表
result = grouped['工资'].agg(['sum', 'mean', 'std', 'count'])
print(result)
#           sum    mean     std  count
# 部门
# 人事   14500    7250    353.5      2
# 技术   27000   13500   2121.3      2
# 销售   17000    8500    707.1      2

# 方式二: 传入字典 -> 对不同列应用不同聚合
result = grouped.agg({
    '工资': ['sum', 'mean'],
    '奖金': ['min', 'max', 'sum']
})
print(result)

# 方式三: 命名聚合(推荐!)
result = grouped.agg(
    总工资=('工资', 'sum'),
    平均工资=('工资', 'mean'),
    最高奖金=('奖金', 'max'),
    人数=('员工', 'count')
)
print(result)
日常业务代码里,最值得优先采用的是命名聚合。它把“结果列名”“来源列”“计算方式”写在同一处,读代码时不需要反复对照多层列索引。
这里还要保留一个版本信息:命名聚合是 Pandas 0.25 之后引入的。
常用内置聚合函数速查
| 函数名 | 说明 | 函数名 | 说明 |
|---|---|---|---|
'sum' | 求和 | 'prod' | 乘积 |
'mean' | 均值 | 'std' | 标准差 |
'median' | 中位数 | 'var' | 方差 |
'min' | 最小值 | 'max' | 最大值 |
'count' | 非空计数 | 'size' | 包括 NaN 的计数 |
'first' | 第一个 | 'last' | 最后一个 |
'nunique' | 唯一值数 | 'sem' | 均值标准误 |
'quantile' | 分位数 | 'ohlc' | Open-High-Low-Close |
什么时候需要自定义聚合函数
# 自定义函数
def range_func(x):
    return x.max() - x.min()

print(grouped['工资'].agg(range_func))
print(grouped['工资'].agg(lambda x: x.max() - x.min()))

# 多列自定义
print(grouped.agg(lambda x: x.max() - x.min()))
自定义聚合适合内置函数表达不了的指标,比如“极差”“特定规则打分”这类结果。但数据量一大,lambda 或 Python 层函数通常比内置聚合慢,性能敏感场景应优先改写成向量化或内置方法。
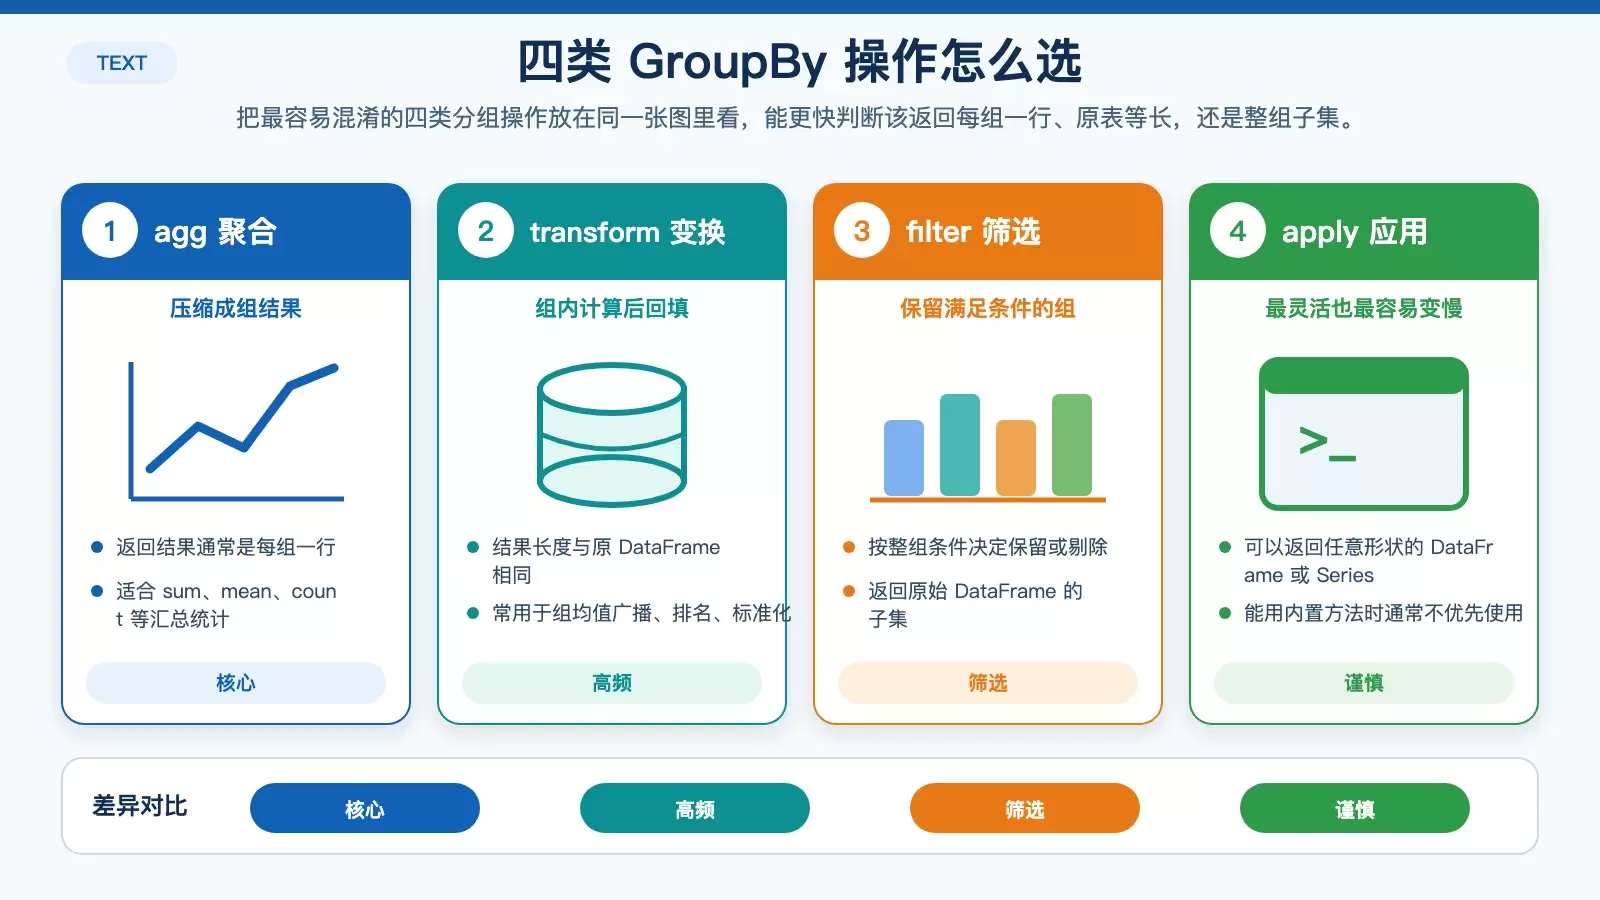
别混用:agg、transform、filter、apply 的边界
transform:组内计算后再回填到每一行
transform 的典型特征是:返回结果与原始 DataFrame 等长。它不负责把组压缩成一行,而是把组内计算结果“广播”回原表。
# 组内减去均值(去中心化)
df['工资_组内去中心'] = grouped['工资'].transform(lambda x: x - x.mean())

# 组内 Z-Score 标准化
df['工资_ZScore'] = grouped['工资'].transform(
    lambda x: (x - x.mean()) / x.std()
)

# 组内填充均值
df['工资_组内补均值'] = grouped['工资'].transform(
    lambda x: x.fillna(x.mean())
)

# 常用内置 transform
df['工资_排名'] = grouped['工资'].transform('rank')          # 组内排名
df['工资_百分比'] = grouped['工资'].transform('pct_change')  # 组内变化率
df['工资_组均值'] = grouped['工资'].transform('mean')        # 组均值广播
如果你的目标是“新增一列组内结果”,比如组均值、组内排名、标准化后的值,那么优先想到的就应该是 transform。
agg 和 transform 最重要的区别
# agg 返回: 每个组一行
print(grouped['工资'].agg('mean'))     # shape: (3,)

# transform 返回: 与原 DataFrame 相同行数
print(grouped['工资'].transform('mean'))  # shape: (6,)
agg 是“压缩结果”,transform 是“回填结果”。很多分组代码写错,本质上就是把这两者的返回形状搞混了。
filter:按组条件保留或剔除整组数据
# 保留组大小 >2 的组
filtered = grouped.filter(lambda g: len(g) > 2)

# 保留工资总和 > 20000 的组
filtered = grouped.filter(lambda g: g['工资'].sum() > 20000)

# 保留组内工资最大值 > 10000 的组
filtered = grouped.filter(lambda g: g['工资'].max() > 10000)
filter 针对的是“整组是否保留”。返回结果还是原始 DataFrame 的子集,只是某些组被整体移除了,单行内容本身不会被改写。
apply:最灵活,也最容易变慢
# apply 可以返回任意形状的 DataFrame/Series
def top_n(group, n=1):
    return group.nlargest(n, '工资')

result = grouped.apply(top_n, n=1)
print(result)

# 返回标量
result = grouped.apply(lambda g: g['工资'].max() - g['工资'].min())

# apply 可返回多列
def summary(g):
    return pd.Series({
        '人数': len(g),
        '平均工资': g['工资'].mean(),
        '工资范围': g['工资'].max() - g['工资'].min()
    })

result = grouped.apply(summary)
print(result)
apply 几乎什么都能做,因为它允许你返回任意形状的结果。但正因为太灵活,很多本该由 agg 或 transform 完成的任务,也被错误地塞进了 apply,最后拖慢执行效率。
一个实用判断标准是:能用 agg、transform、filter 解决,就尽量不要先上 apply。
除了按列分组,还能怎么分
按函数分组
# 按索引长度的奇偶分组
df.groupby(lambda idx: idx % 2 == 0).sum()

# 按工资是否 > 10000 分组
df.groupby(lambda idx: df.loc[idx, '工资'] > 10000).sum()
按映射字典分组
mapping = {'张三': '组A', '李四': '组A', '王五': '组B',
           '赵六': '组B', '钱七': '组C', '孙八': '组C'}
df.groupby(mapping).sum()  # 注意: 按 index 映射
df.groupby(df['员工'].map(mapping)).sum()  # 按列值映射
这类写法适合把原始值先归并成更高层的业务分类,比如把不同员工、地区或渠道映射成统一分组标签。
as_index=False 什么时候更顺手
# as_index=True (默认): 分组键作为索引
result = df.groupby('部门', as_index=True).sum()

# as_index=False: 分组键保留为列(类似 SQL group by)
result = df.groupby('部门', as_index=False).sum()
如果后面还要继续 merge、导出表格,或者你更习惯 SQL 风格结果,as_index=False 往往更省事。
几个常见参数别忽略
# level: 按 MultiIndex 的层级分组
# axis: 按列分组 (axis=1)
# sort: 是否对组键排序(默认 True,设为 False 提升性能)
# dropna: 是否丢弃 NaN 组键(默认 True)
# observed: 分类数据是否只显示出现的组

# 性能优化设置
df.groupby('部门', sort=False, dropna=True)
参数里最常被低估的是 sort=False。当你并不关心组键排序时,它往往能减少一些不必要的开销。
高频实战技巧:累计、偏移、排名与抽样
组内累计操作
df['工资_累计和'] = grouped['工资'].cumsum()     # 组内累计和
df['工资_累计最大'] = grouped['工资'].cummax()   # 组内累计最大值
df['工资_累计积'] = grouped['工资'].cumprod()    # 组内累计积
组内偏移与变化
df['工资_上一行'] = grouped['工资'].shift(1)        # 组内上移
df['工资_下一行'] = grouped['工资'].shift(-1)       # 组内下移
df['工资_变化'] = grouped['工资'].diff()             # 组内差分
df['工资_变化率'] = grouped['工资'].pct_change()     # 组内变化率
这组方法很适合做时间序列或分组前后对比,比如“每个部门内员工工资较上一条记录增长多少”。
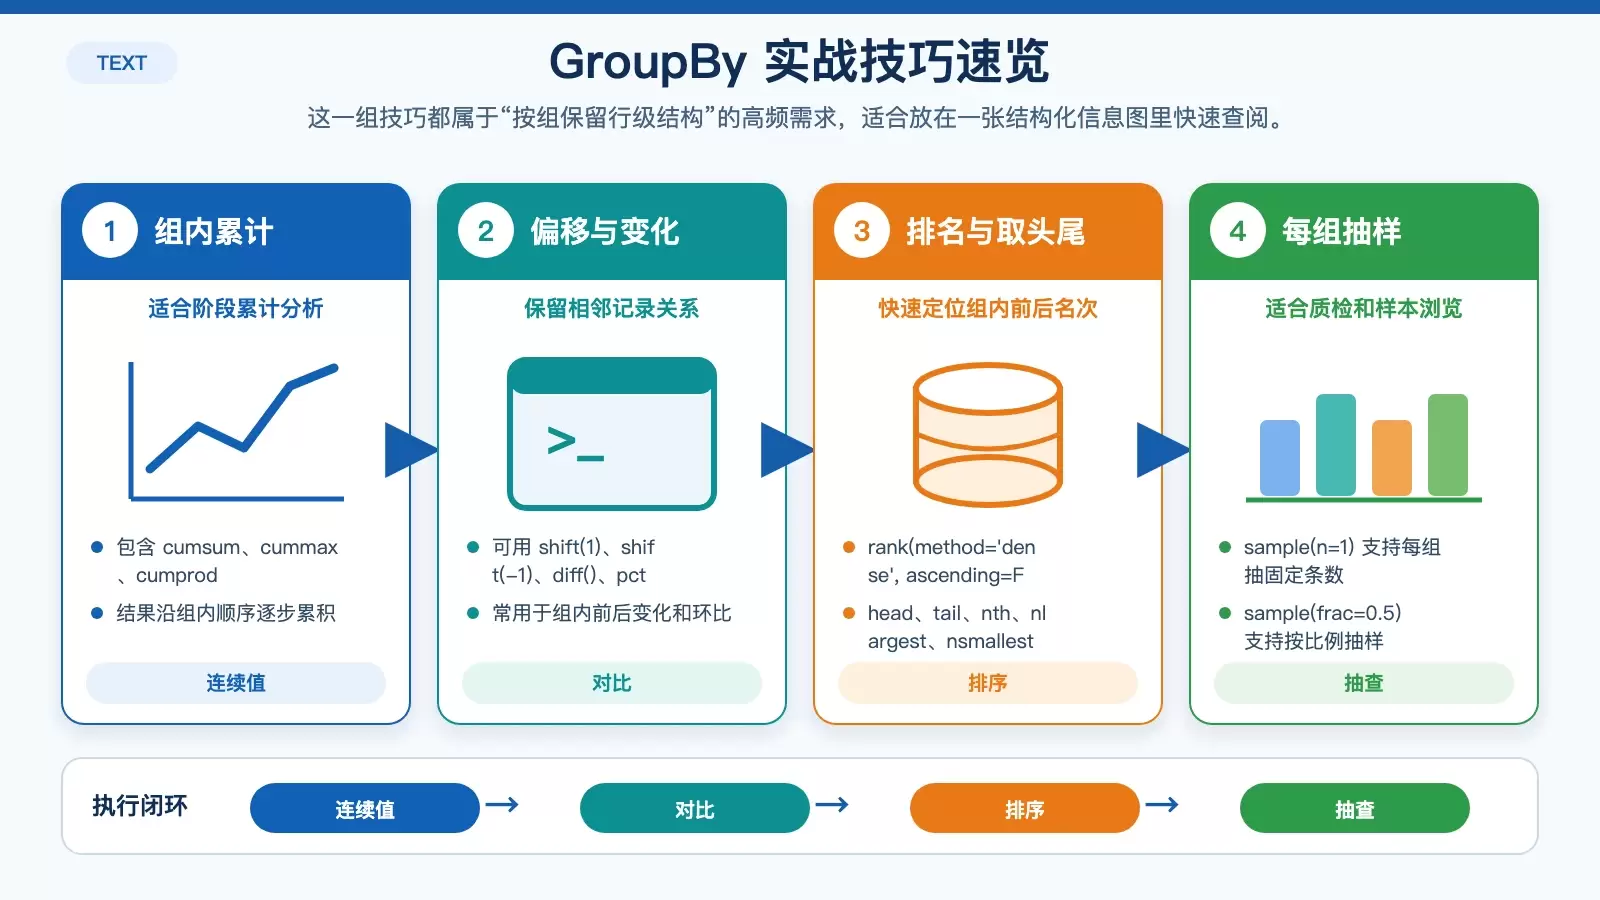
组内排名与取头尾记录
df['工资排名'] = grouped['工资'].rank(method='dense', ascending=False)
# method: 'average', 'min', 'max', 'first', 'dense'
df.groupby('部门').head(2)   # 每组前 2 行
df.groupby('部门').tail(1)   # 每组最后 1 行
df.groupby('部门').nth(0)    # 每组第 0 个
df.groupby('部门').nth([0, -1])  # 每组第 0 和最后一个
df.groupby('部门').nlargest(2, '工资')   # 每组工资最高的 2 行
df.groupby('部门').nsmallest(1, '奖金')  # 每组奖金最低的 1 行
这里原文中 method 的字符串示例应为 'average',实际使用时不要写成带空格的形式。
每组抽样
df.groupby('部门').sample(n=1, random_state=42)     # 每组抽 1 个
df.groupby('部门').sample(frac=0.5, random_state=42) # 每组抽 50%
抽样适合做质检、人工复核或快速浏览各组代表样本,random_state=42 则保证结果可复现。
把分组写进方法链,代码会更清晰
# Pandas 支持方法链
result = (df
    .groupby('部门')
    .agg(总工资=('工资', 'sum'), 人数=('员工', 'count'))
    .query('人数 > 1')
    .sort_values('总工资', ascending=False)
    .reset_index()
)
print(result)
当一段分组逻辑需要连续完成汇总、筛选、排序和重置索引时,方法链通常比多次中间变量更紧凑。为了可读性,建议像上面这样分行缩进,把每一步都控制在单独一行。
最后怎么选:一个实用判断框架
如果你要的是“每组一行”的汇总表,用 agg();如果你要的是“按组算完再回填到每一行”,用 transform();如果你想按组条件整体保留或剔除数据,用 filter();只有在返回形状复杂、内置接口不够表达时,再考虑 apply()。
真正把 groupby 用顺手,关键不是记住多少函数,而是先判断结果应该是“压缩”“广播”还是“整组筛选”。这个判断一旦清楚,后面的写法反而会简单很多。















