


Python使用Tesseract进行OCR文字识别入门指南

本文详细介绍如何利用Python和Tesseract库实现光学字符识别(OCR)。内容涵盖Tesseract的安装配置、pytesseract库的使用,以及针对规范英文和中文图片的识别代码示例与结果分析,帮助开发者快速掌握基础OCR技术。
机器视觉与文字识别概述
机器视觉
从Google无人驾驶汽车到具备假钞识别功能的自动售货机,机器视觉技术已广泛应用于各个领域,具有深远影响且愿景宏大。
本文将聚焦于机器视觉的一个细分领域:文字识别,并介绍如何利用Python相关库来识别和处理在线图片中的文字信息。
人类可以轻松阅读图片中的文字,但机器处理此类图像却面临巨大挑战。正是利用这种“对人类可读但对存储器不可读”的特性,验证码(CAPTCHA)应运而生,其识别难度各不相同。
将图像内容转换为文本的过程通常被称为光学字符识别(Optical Character Recognition,简称OCR)。目前支持OCR的底层库数量有限,大多数现有库都是基于少数几个核心OCR引擎构建或在其基础上进行定制开发。
OCR库概述与Tesseract介绍
OCR库概述
在图像读取、处理、机器学习以及图像生成等任务中,Python一直表现出色。尽管存在众多图像处理库,但本文仅重点介绍Tesseract库。
Tesseract
Tesseract是一个由Google赞助的OCR库,被公认为目前最优秀且精确度最高的开源OCR系统。除了高精度外,Tesseract还具备极高的灵活性,支持通过训练识别任意字体及Unicode字符。
Tesseract与pytesseract安装指南
安装Tesseract:Windows系统
下载可执行安装文件并完成安装即可。
安装pytesseract
Tesseract本身是一个Python命令行工具,并非通过import语句直接导入的库。安装后,需通过tesseract命令在Python外部运行。不过,我们可以通过pip安装支持Python接口的Tesseract封装库:
pip install pytesseract
规范文字处理与代码示例
处理规范的文字
大多数需要处理的文字都比较干净且格式规范。格式规范的文字通常具备以下特征:
使用统一的标准字体(不包含手写体、草书或过于花哨的字体);图像经过复印或拍摄后字体清晰,无多余痕迹或污点;文字排列整齐,无歪斜;文字未超出图片范围,无残缺不全或紧贴图片边缘的情况。
部分文字格式问题可在图片预处理阶段解决,例如将图片转换为灰度图、调整亮度和对比度,或根据需要进行裁剪和旋转,此处不再赘述。
示例:
英文:
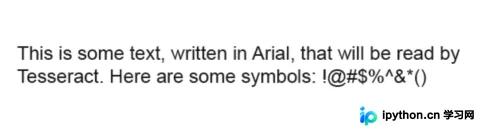
识别结果的准确率相当高。
通过Python代码实现
英文:
中文:
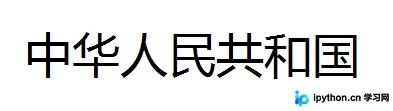
运行结果
This is some text, written in Arial, that will be read by Tesseract. Here are some symbols: !@#$%"&*() ****************************** 中 华 人 民 共 和 国
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















