


深入解析Python中的\r、\n与\r\n及Unicode编码处理

本文详细解析了Python中\r、\n及\r\n的历史渊源与系统差异,涵盖Unix、MAC和Windows的不同标准。同时介绍了如何处理爬虫获取的Unicode编码文件,通过指定encoding='unicode_escape'等参数正确读取和解码内容,确保数据准确输出。
回车与换行的历史及系统差异
回车与换行的概念源于机械打字机的操作机制。
在机械打字机上,回车键和换行键各自承担不同的功能。
换行操作仅将滚筒向上卷动一格,保持水平位置不变,即光标移至下一行但不对齐行首。
回车操作则将水平位置复位至行首,不卷动滚筒,若继续输入会覆盖原有内容。
Enter键的功能等同于回车加换行,即\r\n。
理解这两个字符的关键在于区分其英文含义及在不同操作系统中的表现。
\n代表换行(New line),用于移动光标至下一行。
\r代表回车(Carriage return),用于将光标移至行首。
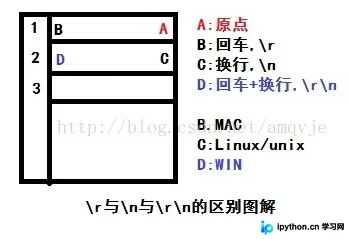
Unix系统使用\n(十六进制0x0A)作为换行符。
MAC系统使用\r(十六进制0x0D)作为回车符。
Windows系统使用\r\n(十六进制0x0D, 0x0A)作为回车换行组合。
Python中Unicode编码文件的处理
补充知识:Python文件输出时的Unicode转码处理。
在使用Python爬虫获取数据时,有时得到的文件内容是Unicode编码格式,输出示例如下。
{"\u5185\u5bb9": "\u5c11\u5e74\u4e0d\u8bc6\u6101\u5473\uff0c\u7231\u4e0a\u5c42\u697c\u3002\u7231\u4e0a\u5c42\u697c\u3002\u4e3a\u8d4b\u65b0\u8bcd\u5f3a\u8bf4\u6101\u3002 \u800c\u4eca\u8bc6\u5c3d\u6101\u5473\uff0c\u6b32\u8bf4\u8fd8\u4f11\u3002\u6b32\u8bf4\u8fd8\u4f11\u3002\u5374\u9053\u5929\u51c9\u597d\u4e2a\u79cb\u3002scrapy\u4e2d\u6587\u7f51\uff08http://www.scrapyd.cn\uff09\u6574\u7406", "\u4f5c\u8005": "\u8f9b\u5f03\u75be"},
类似上述格式的数据。
针对不同编码的文件,在读取输出时需添加相应的解码方式,例如。
with open("mingyan.json",'r',encoding='unicode_escape')as file:
  message = file.read()
  print(message)
  print(type(message))
encoding = ‘编码方式'
编码方式多种多样,通常文件头部会标注编码信息。
# test for with.py
# -*- coding: utf-8 -*-
# __author__ = 'Carina'
这有助于后续对该文件进行正确的处理操作。
以上关于Python中\r、\n、\r\n的解析及Unicode编码处理内容的分享,希望能提供参考,欢迎支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















