


Python多进程multiprocessing与进程池Pool实战详解

本文深入解析Python中multiprocessing模块的使用,涵盖进程创建、继承Process类及常用API。重点讲解进程池Pool的串行与并行执行、回调函数机制,以及close和join的正确调用顺序,通过代码实例帮助开发者高效实现并发编程。
本文通过具体实例,详细讲解Python中多进程模块multiprocessing及进程池(Pool)的使用方法,供读者参考学习。
multiprocessing模块基础与进程创建
multiprocessing模块基础
- 进程的创建与运行流程
- 进程相关常用函数说明
进程池Pool的应用与机制
进程池(Pool)应用
- 引入进程池的必要性
- 进程池的创建与串行/并行执行
- 回调函数的应用
多进程实现方式与常用API
在Python中实现多进程需依赖multiprocessing模块。
- 多进程的创建与运行步骤
1. 进程创建:通过实例化multiprocessing.Process对象实现,语法为`进程对象 = multiprocessing.Process(target=函数名, args=(参数,))`。注意:由于`args`接收的是元组,若仅传递单个参数,务必在参数后添加逗号以避免语法错误。
2. 进程启动:调用`进程对象.start()`方法启动子进程。
进程的`join()`方法与线程类似,其作用是阻塞当前主进程,直到调用`join()`的子进程执行完毕,主进程才继续后续代码。
注意:在Windows操作系统下,代码中必须包含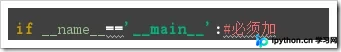 判断语句;而在Linux系统中则无需此限制。
import multiprocessing,time,os

def thread_run():
  print(threading.current_thread())

def run(name):
  time.sleep(1)
  print("hello",name,"run in ",os.getpid(),"ppid:",os.getppid())

if __name__=='__main__':#必须加
  obj=[]
  for i in range(10):
    p=multiprocessing.Process(target=run,args=('bob',))
    obj.append(p)
    p.start()
  start_time=time.time()
  for i in obj:
    i.join()
  print("run in main")
print("spend time :",time.time()-start_time)- 与多线程类似,也可以通过继承multiprocessing模块中的Process类来创建自定义进程。
继承multiprocessing.Process类时,主要需完成两项工作:
1. 若需初始化自定义变量,必须先调用父类的`__init__()`方法(若不调用则需手动处理相关参数,较为繁琐),随后执行自定义初始化逻辑;若无需自定义变量,可直接使用父类的`__init__`,无需重写。
2. 必须重写`run`方法,定义进程的具体执行逻辑。
import multiprocessing

class myProcess(multiprocessing.Process):
  def run(self):
    print("run in myProcess")

if __name__=="__main__":
  p=myProcess()
  p.start()
p.join()- os.getpid():用于获取当前进程的ID号。
- os.getppid():用于获取当前进程的父进程ID号。
- 进程对象.is_alive():用于判断进程是否处于存活状态。
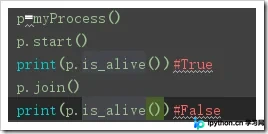
- 进程对象.terminate():用于强制结束进程。此为不建议使用的方法,实际开发中较少采用。
- 为什么需要进程池
- 当需要启动大量子进程时,建议使用进程池批量创建。进程池可以限制同时运行的进程数量,如同游泳池容量有限,限制了同时游泳的人数。
- Pool类可提供指定数量的进程供用户调用。当有新请求提交至Pool时,若池未满,则创建新进程执行请求;若池已满,请求将被挂起等待,直到有进程结束并释放资源后,再创建新进程执行剩余请求。
- 进程池的创建与使用
- 使用进程池前需导入相关模块:`from multiprocessing import Pool`。
- 创建进程池:通过实例化Pool对象并指定容量,语法为`进程池对象 = Pool(容量)`。
- 给进程池添加进程
- 串行执行:使用`进程池对象.apply(func=函数名, args=(参数,))`。该方法会阻塞直到当前任务完成,再提交下一个任务。
进程池串行执行示例
from multiprocessing import Pool
import time,os

def func1(i):
  time.sleep(1)
  print("run in process:",os.getpid())

if __name__=="__main__":
  pool=Pool(5)

  start_time = time.time()
  for i in range(10):
    pool.apply(func=func1,args=(i,))#串行,这里是加一个运行完再加一个
   pool.close()#先close再等待
   pool.join()
print("main run done,spend_time:",time.time()-start_time)- 并行执行:使用`进程池对象.apply_async(func=函数名, args=(参数,), callback=回调函数)`。该方法提交任务后立即返回,不阻塞主进程。
进程池并行执行示例
from multiprocessing import Pool
import time,os

def func1(i):
  time.sleep(1)
  print("run in process:",os.getpid())


if __name__=="__main__":
  pool=Pool(5)

  start_time = time.time()
  for i in range(10):
    pool.apply_async(func=func1,args=(i,))#并行

  pool.close()#先close再等待
  pool.join()
print("main run done,spend_time:",time.time()-start_time)#2.6,证明是并行- 回调函数的使用:在并行模式下,支持通过`callback`参数指定回调函数。当某个子进程执行完毕后,会自动调用该回调函数,并将子进程函数的返回值作为参数传递给回调函数。
- 注意:回调函数是在父进程(主进程)中执行的,即子进程完成后,父进程会调用该回调函数。
回调函数机制与示例
from multiprocessing import Pool
import time,os

def func1(i):
  time.sleep(1)
  print("run in process:",os.getpid())
  return "filename"


def log(arg):##参数为进程创建中func的函数的返回值
  print("log done :",arg)

if __name__=="__main__":
  pool=Pool(5)

  start_time = time.time()
  for i in range(10):
    pool.apply_async(func=func1,args=(i,),callback=log,)#log的参数是func1的返回值

  pool.close()#先close再等待
  pool.join()
  print("main run done,spend_time:",time.time()-start_time)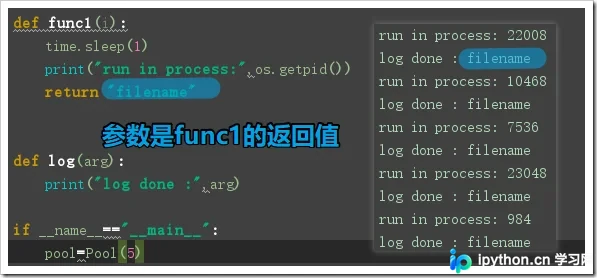
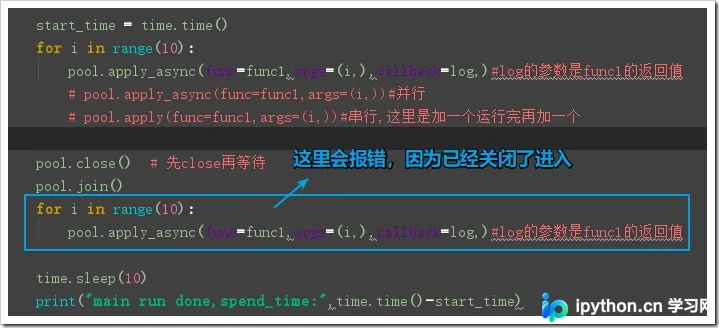
- 注:对
Pool对象调用join()方法会等待所有子进程执行完毕,调用join()之前必须先调用close(),调用close()之后就不能继续添加新的Process了。【意思就是比如游泳池只卖1个小时的票,约定5点关门,那么4点多之后就不能再卖票了,就一直等着游泳池里面的人出来再关门,进程池的close是一个关门的意思,并不是结束的意思,它只是关上了进来的门,而里面的进程还可以运行】【进程池的join是等池子里的所有进程执行完毕,如果后面再进来进程的话就没完没了了,所以需要先关闭进入,再等待进程结束】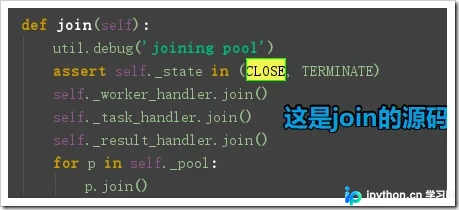
- 小测试:
- 小测试:
更多关于Python相关内容感兴趣的读者可查看本站专题:《Python进程与线程操作技巧总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》、《Python+MySQL数据库程序设计入门教程》及《Python常见数据库操作技巧汇总》
希望本文所述对大家Python程序设计有所帮助。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















