


Python线性回归模型评估指标详解:SSE、R²与调整R²

本文详细解析Python线性回归模型的三大核心评估指标:SSE(误差平方和)、R²(决定系数)及调整R²。通过diabetes数据集示例,阐述各指标的计算逻辑、取值范围及优缺点,帮助开发者准确评估模型拟合效果。
Python线性回归模型评估指标详解
本文直接通过代码示例展开讲解。
"""
# 利用 diabetes数据集来学习线性回归
# diabetes 是一个关于糖尿病的数据集, 该数据集包括442个病人的生理数据及一年以后的病情发展情况。
# 数据集中的特征值总共10项, 如下:
 # 年龄
 # 性别
 #体质指数
 #血压
 #s1,s2,s3,s4,s4,s6 (六种血清的化验数据)
 #但请注意,以上的数据是经过特殊处理, 10个数据中的每个都做了均值中心化处理,然后又用标准差乘以个体数量调整了数值范围。
 #验证就会发现任何一列的所有数值平方和为1.
"""

import matplotlib.pyplot as plt
import numpy as np
from sklearn import datasets, linear_model
from sklearn.metrics import mean_squared_error, r2_score

# Load the diabetes dataset
diabetes = datasets.load_diabetes()

# Use only one feature
# 增加一个维度,得到一个体质指数数组[[1],[2],...[442]]
diabetes_X = diabetes.data[:, np.newaxis,2]
print(diabetes_X)

# Split the data into training/testing sets
diabetes_X_train = diabetes_X[:-20]
diabetes_X_test = diabetes_X[-20:]

# Split the targets into training/testing sets
diabetes_y_train = diabetes.target[:-20]
diabetes_y_test = diabetes.target[-20:]

# Create linear regression object
regr = linear_model.LinearRegression()

# Train the model using the training sets
regr.fit(diabetes_X_train, diabetes_y_train)

# Make predictions using the testing set
diabetes_y_pred = regr.predict(diabetes_X_test)

# The coefficients
# 查看相关系数
print('Coefficients: \n', regr.coef_)


# The mean squared error
# 均方差
# 查看残差平方的均值(mean square error,MSE)
print("Mean squared error: %.2f"
  % mean_squared_error(diabetes_y_test, diabetes_y_pred))


# Explained variance score: 1 is perfect prediction
# R2 决定系数(拟合优度)
# 模型越好:r2→1
# 模型越差:r2→0
print('Variance score: %.2f' % r2_score(diabetes_y_test, diabetes_y_pred))


# Plot outputs
plt.scatter(diabetes_X_test, diabetes_y_test, color='black')
plt.plot(diabetes_X_test, diabetes_y_pred, color='blue', linewidth=3)

plt.xticks(())
plt.yticks(())

plt.show()
回归模型的效果评估指标经历了从SSE到R-square,再到Adjusted R-square的演进过程,这一过程旨在不断完善评估标准。
SSE(误差平方和):即The sum of squares due to error。
R-square(决定系数):即Coefficient of determination。
Adjusted R-square:即Degree-of-freedom adjusted coefficient of determination(自由度调整后的决定系数)。
接下来对上述几个关键术语进行详细解释,旨在为读者提供实质性的帮助。
SSE(误差平方和)
一、SSE(误差平方和)
其计算公式如下:
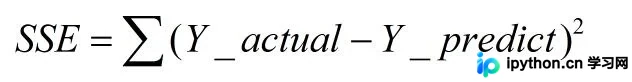
在数据集相同的情况下,SSE数值越小,意味着误差越小,模型的效果也就越好。
然而,SSE存在明显的局限性:
SSE的绝对数值本身缺乏独立意义,因为它会随着样本数量的增加而必然增大。因此,在不同数据集之间直接比较SSE是没有意义的。
R-square(决定系数)
二、R-square(决定系数)
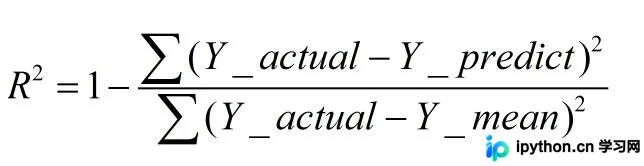
从数学角度理解,分母代表原始数据的离散程度,分子代表预测数据与原始数据之间的误差。两者相除可以消除原始数据离散程度对评估结果的影响。
实质上,“决定系数”是通过数据的变化来表征模型拟合的好坏程度。
理论上,R²的取值范围是(-∞,1],但在正常操作中,其取值范围通常为[0, 1]。实际操作中,人们通常会选择拟合较好的曲线来计算R²,因此出现负无穷的情况极少。
R²越接近1,表明方程中的变量对y的解释能力越强,该模型对数据的拟合效果也越好。
反之,R²越接近0,表明模型的拟合效果越差。
经验法则指出,当R² > 0.4时,通常认为拟合效果良好。
尽管R-square比SSE有所改进,但它仍存在缺点:
随着数据集样本量的增加,R²往往会变大。因此,在不同数据集之间比较模型结果时,可能会产生一定的误差。
Adjusted R-Square(校正决定系数)
三、Adjusted R-Square(校正决定系数)
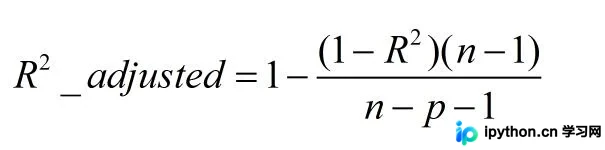
其中,n代表样本数量,p代表特征数量。
调整R²有效地消除了样本数量和特征数量对评估结果的影响。
以上关于Python线性回归分析及其评价指标的详解内容到此结束,希望能对读者有所帮助,也欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















