


pandas中read_csv、rolling、expanding用法详解

本文详细解析pandas中read_csv、rolling和expanding三个核心函数的用法。涵盖read_csv的header、index_col及usecols参数配置;深入讲解rolling滑动窗口的min_periods参数控制机制;以及expanding扩展窗口处理历史数据的方法。通过具体代码示例,帮助开发者掌握时间序列与数据窗口分析技巧。
pandas read_csv 参数详解
具体实现方式如下所示:
import pandas as pd
from pandas import DataFrame

series = pd.read_csv('daily-min-temperatures.csv',header=0, index_col=0,
      parse_dates=True,squeeze=True)
temps = DataFrame(series.values)
width = 3
shifted = temps.shift(width-1)
print(shifted)
window = shifted.rolling(window=width)
dataframe = DataFrame()
dataframe = pd.concat([window.min(),window.mean(),window.max(),temps],axis=1)
dataframe.columns=['min','mean','max','t+1']
print(dataframe.head(5))
在read_csv函数中,各参数的具体用法如下:
若设置 header=None,则系统默认CSV文件不包含列索引,此时将自动生成相应的列索引范围。例如 range(1,1200) 表示生成从1开始至1199结束的列索引;当数据列数超出该范围时,多余索引将沿数据列右侧对齐。
obj=pd.read_csv('testdata.csv',header=0,names=range(1,4))
当设置 header=0 时,系统认定CSV文件的第一行为列索引,并使用指定的新列索引替换原有的列索引。
obj=pd.read_csv('testdata.csv',index_col=0,usecols=[1,2,3])
若设置 index_col=0,则表示将CSV数据中的第一列指定为行索引;同时 usecols 用于筛选特定的数据列,例如 [1,2,3] 表示选取第2列至第4列的数据。
obj=pd.read_csv('testdata.csv',index_col=0,usecols=5)
利用 usecols 参数可以选择前 n 行数据进行后续处理,其中 n 需为正整数。
rolling 滑动窗口函数应用
关于 rolling 函数的使用方法:
源代码
 def rolling(self, *args, **kwargs):
  """
  Return a rolling grouper, providing rolling functionality per group.
  """
  from pandas.core.window import RollingGroupby

  return RollingGroupby(self, *args, **kwargs)

 @Substitution(name="groupby")
 @Appender(_common_see_also)
用法代码演示
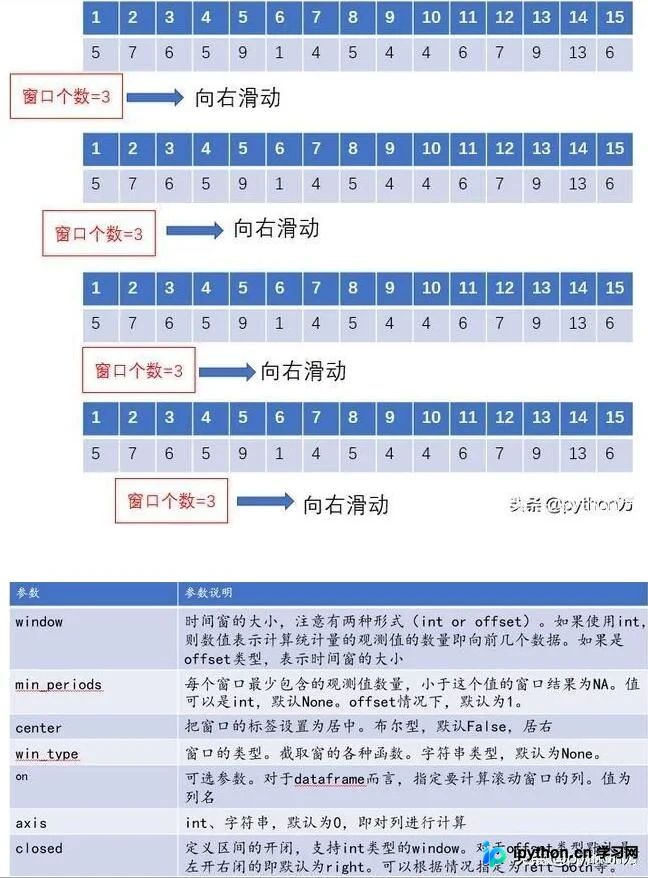
前文已介绍滑动窗口的概念及实现函数的参数,接下来通过代码演示依次展示各参数的具体作用。
import matplotlib.pylab as plt
import numpy as np
import pandas as pd
index=pd.date_range('20190116','20190130')
data=[4,8,6,5,9,1,4,5,2,4,6,7,9,13,6]
ser_data=pd.Series(data,index=index)
print(ser_data)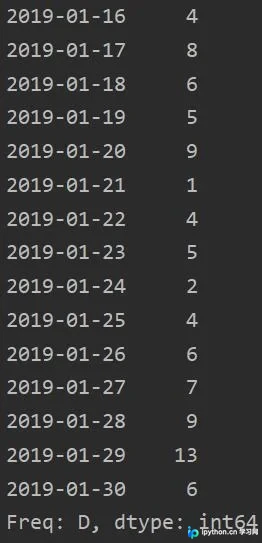
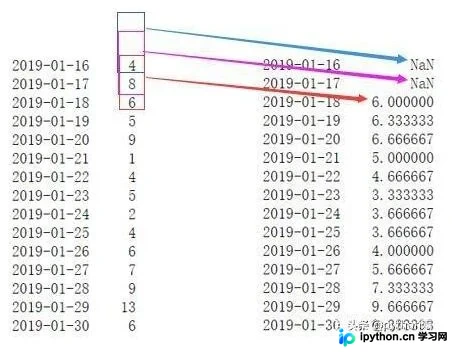
引入 rolling 并应用时间窗后的处理及具体原理
ser_data.rolling(3).mean()
min_periods 参数用法
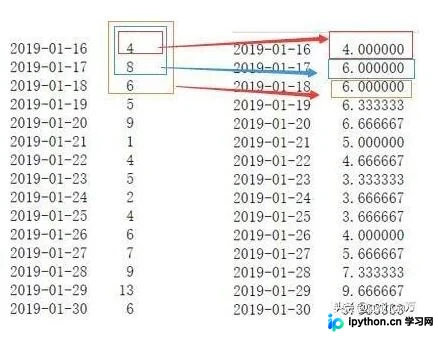
如上图所示,当窗口开始滑动时,前两个时间点的数据为空。这是因为窗口长度设定为3,而这两个时间点之前的数据不足3个,因此直到 2019-01-18,其数据才显示为 2019-01-16 至 2019-01-18 这三天的均值。有人可能会疑问,在计算 2019-01-16 序列的窗口数据时,虽然未达到窗口长度3,但至少有当天的数据,能否直接用当天数据代表窗口数据?答案是肯定的,这里可以通过 min_periods 参数进行控制。该参数表示窗口最少包含的观测值数量:若小于此值,窗口长度显示为空;若等于或大于此值,则显示计算结果,具体如下所示:
表示窗口最少包含的观测值为1
ser_data.rolling(3,min_periods=1).mean()
expanding 扩展窗口函数应用
expanding 函数的使用方法
征用前面全部的数据
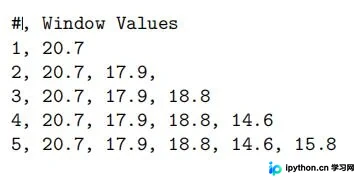
代码详解
import pandas as pd
from pandas import DataFrame

series = pd.read_csv('daily-min-temperatures.csv',header=0, index_col=0,
      parse_dates=True,squeeze=True)
temps = DataFrame(series.values)
window = temps.expanding()
dataframe = DataFrame()
dataframe = pd.concat([window.min(),window.mean(),window.max(),temps.shift(-1)],axis=1)
dataframe.columns=['min','mean','max','t+1']
print(dataframe.head(5))
输出结果
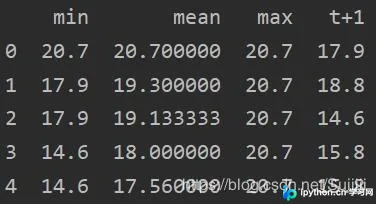
expanding 可去除 NaN 值
以上这篇pandas中read_csv、rolling、expanding用法详解就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















