


Python 使用 HackRequests 实现敏感目录扫描

发布时间:2026-10-13 |
4人浏览过
本文介绍如何利用 Python 的 HackRequests 模块配合字典文件 PHPdict.txt,编写一个简单的敏感目录扫描脚本。文中详细说明了环境依赖、URL 输入规范及 Headers 设置等注意事项,并提供了完整的实现代码与效果演示,帮助安全测试人员快速掌握基础扫描工具的开发方法。
实现背景与目标
01 实现背景
准备一个名为 PHPdict.txt 的文本文件,其中包含常见的敏感目录后缀列表。
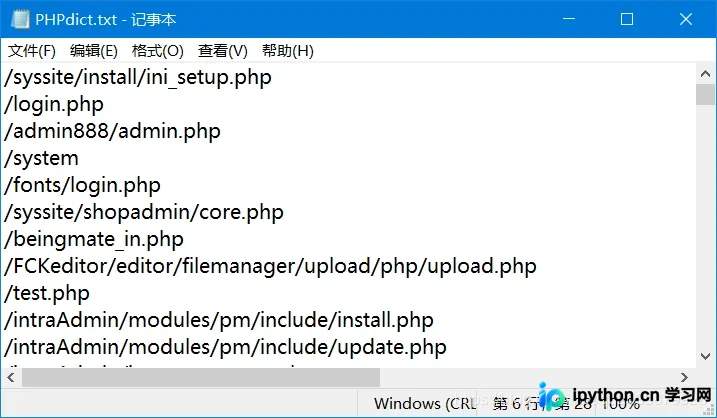
使用 HackRequests 模块,这是一个专为安全测试人员设计的类 Requests 网络请求库。
02 实现目标
结合 HackRequests 模块与敏感目录字典 PHPdict.txt,编写并实现一个用于扫描敏感目录的 Python 脚本。
关键注意事项
03 注意事项
输入目标 URL 时必须包含完整路径,例如 https://www.baidu.com/ 或 https://www.csdn.net/。
为了应对网站可能存在的简单反爬机制,脚本中添加了简单的 Headers 信息,以尝试绕过反爬限制。
代码实现与效果
04 实现代码
import HackRequests
def HR(url):
 h = HackRequests.hackRequests()
 header = {
 "Connection": "keep-alive",
 "User-Agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:73.0) Gecko/20100101 Firefox/73.0"
 }
 try:
 u = h.http(url=url,headers=header)
 if u.status_code == 200:
  print("%s is success!" %url)
 else:
  print("%s is failed! %d" %(url,u.status_code))
 except:
 pass
with open("C:\\Users\\Dell\\Desktop\\Python\\PHPdict.txt","r") as file:
 lines = file.readlines()
 urls = []
 url_begin = input('请输入你要扫描的网站:')
 for line in lines:
 url = f'{url_begin}{line}'
 urls.append(url)

for url in urls:
 print(url)
 HR(url)
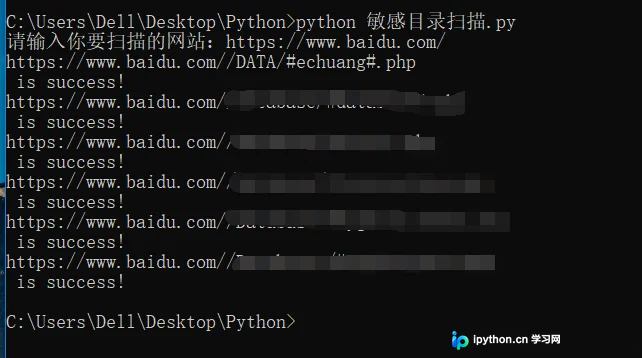
05 实现效果
总结
到此这篇关于 Python 实现敏感目录扫描的示例代码的文章就介绍到这了,更多相关python 敏感目录扫描内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















