


Python利用WordCloud结合文本与图片生成词云

发布时间:2026-10-13 |
3人浏览过
本文介绍如何使用Python的wordcloud库,结合jieba分词和imageio图像处理,通过读取文本文件和背景图片生成自定义形状的词云。文章提供了完整的代码示例,涵盖文本预处理、词语分割、图片读取及词云生成保存的全过程,帮助开发者快速实现可视化效果。
Python生成词云的基本流程
利用现有的TXT文本素材与图片资源,借助wordcloud库即可生成词云图。主要操作流程包括以下几个步骤:
第一步,读取TXT文本文件并进行基础的数据清洗与处理;
第二步,读取指定的图片文件,将其作为词云的生成背景或遮罩;
第三步,实例化并生成词云对象,最后将结果保存为图像文件。
实现该功能需要引入三个核心库:jieba用于将文本分割为独立的词语序列,imageio用于读取图像数据,而wordcloud则是生成词云的核心功能库。
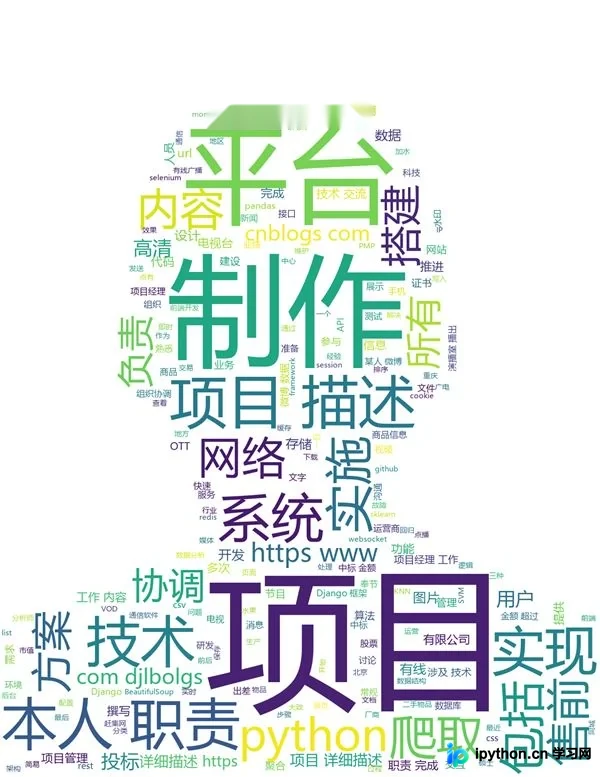
以下示例展示了使用个人简历文本与照片生成词云图的效果:
代码实现与配置详解
具体实现代码如下:
import jieba
import imageio
import wordcloud


# 读取txt文本
with open('resume.txt','r',encoding='utf-8') as f:
  text = f.read()

# 简单处理文本,删除空格等多余字符
text = text.replace(' ','').replace('\t','').replace('\n','')
# 使用jieba分隔词语
wordlist = jieba.lcut(text)  # ['aa','bb','cc'...]
# print(wordlist)
# 用空格连接各个词语,又形成一个大字符串
string = ' '.join(wordlist)  # 'aa bb cc'

# 读取图片
image = imageio.imread('ding.jpg')


# 生成词云图片
# 先实例化一个词云对象
wc = wordcloud.WordCloud(width=image.shape[0], # 词云图宽度同原图片宽度
            height=image.shape[1],
            background_color='white', # 背景颜色白色
            font_path='msyh.ttc', # 指定字体路径,微软雅黑,可从win自带的字体库中找
            mask=image,  # mask 指定词云形状图片,默认为矩形
            scale=3)  # 默认为1,越大越清晰
# 再给词云输入文字
wc.generate(string)
# 保存成文件
wc.to_file('wordcloud21.png')
以上内容为本文的全部介绍,希望能为读者的学习提供有益参考,同时也感谢大家对本平台的支持。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















