


Python实现过滤列表中重复元素间的内容以优化路径规划

本文介绍了一种Python算法,用于滤除列表中重复元素之间的所有中间内容。该方法主要应用于遗传算法路径规划中的种群初始化阶段,通过删除路径中重复节点间的冗余部分(即“回头路”),有效提升了初始种群的优越性并加速算法收敛。文章提供了详细的代码实现及面向对象封装示例,展示了如何处理包含多次回头路径的节点序列。
引言与背景
引言
在研究遗传算法进行路径规划时,种群初始化是一个关键步骤。初始化的核心在于生成从起点到终点的有效路径。为了优化初始种群的质量并加快算法的收敛速度,需要剔除路径中重复节点之间的冗余路段,从而避免算法陷入“走回头路”的低效循环。在查阅现有资料时,发现大多数代码仅处理滤除列表中完全相同的元素,而缺乏针对滤除重复元素之间中间段内容的解决方案。因此,本文提出并实现了相应的处理逻辑。
代码实现与结果分析
代码实现部分
在Python程序中,每一条路径被表示为一个列表,例如: a = [0,1,3,4,5,6,3,4,7,3,5,8,9,8,10,13,11,12,10] 上述列表a代表一条从节点0到节点10的路径。观察可知,路径中存在多处重复节点(如3、4、8、10等),导致路径中出现往返行走的冗余部分。为此,设计了以下算法来滤除这些冗余内容,代码包含详细注释:
a = [0,1,3,4,5,6,3,4,7,3,5,8,9,8,10,13,11,12,10]#初始列表

def fiter(a):    #定义一个函数
  for i in a:   #遍历列表中的内容
    a = a[a.index(i)+1:]  #把当前内容索引的后面的内容剪切下来 因为前面的已经比对过了
    if i in a:   #如果当前内容与后面有重复
      return i,1  #返回当前重复的内容 以及标志位1
    else:      #没有重复就不用管 继续for循环
      pass
  return 0,0 #全部遍历完 没有重复的就返回0 这里返回两个0 是因为返回的数量要保持一致
b = 1  #标志位
while(b == 1): #标志位一直是 1 则说明有重复的内容
  (i,b) = fiter(a)    #此时接受函数接收 返回值 i是重复的内容 b是标志位
  c = [j for j,x in enumerate(a) if x==i] #将重复内容的索引全部添加进c列表中
  a = a[0:c[0]]+a[c[-1]:]   #a列表切片在重组
print(a)
运行结果
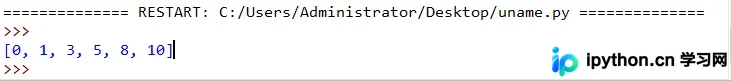
上述代码仍有优化空间,例如可将整体逻辑封装为独立函数以便复用,后续可进一步打磨。
面向对象封装与总结
后续改进
在实际集成到遗传算法总工程时,发现将逻辑封装为类对象更为合适。以下是完整的封装代码:
a = [0,1,3,4,5,6,3,4,7,3,5,8,9,8,10,13,11,12,10]
class Fiter:
  def __init__(self):
    self.b = 1  #标志位
  def function(self,a):    #定义一个函数
    for i in a:   #遍历列表中的内容
      a = a[a.index(i)+1:]  #把当前内容索引的后面的内容剪切下来 因为前面的已经比对过了
      if i in a:   #如果当前内容与后面有重复
        return i,1  #返回当前重复的内容 以及标志位1
      else:      #没有重复就不用管 继续for循环
        pass
    return 0,0 #全部遍历完 没有重复的就返回0 这里返回两个0 是因为返回的数量要保持一致

  def fiter(self,a):
    while(self.b == 1): #标志位一直是 1 则说明有重复的内容
      (i,self.b) = self.function(a)    #此时接受函数接收 返回值 i是重复的内容 b是标志位
      c = [j for j,x in enumerate(a) if x==i] #将重复内容的索引全部添加进c列表中
      a = a[0:c[0]]+a[c[-1]:]   #a列表切片在重组
    return (a)
fiter = Fiter() #实例化
a = fiter.fiter(a) #调用方法 返回已经滤除的列表
print(a)
此处直接将逻辑封装为类对象,使用时需先实例化该类,再调用相应方法。其处理结果与前述代码一致。
总结
至此,关于使用Python代码实现滤除列表中重复元素之间内容的介绍已完成。如需了解更多关于Python列表重复元素处理的相关内容,可搜索本站历史文章或继续浏览后续文章。感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















