


使用pandas向CSV文件追加新行与列的方法

发布时间:2026-10-13 |
2人浏览过
本文介绍如何利用pandas库向现有CSV文件追加新的列和行数据。首先通过Excel准备包含中文编码的CSV文件,接着演示使用df['列名']赋值方式添加整列数据,以及通过df.loc索引定位添加特定行数据。文中包含完整的代码示例及文件路径、编码格式等关键参数说明,适用于Python初学者进行基础数据操作。
创建并准备CSV文件
首先,需要创建一个CSV文件。具体操作是新建一个文本文档,并将其后缀名修改为test.csv。
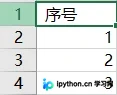
随后,使用Excel软件打开该文件,并在其中填入初始内容。
文件中的初始内容结构如下所示:
使用pandas添加新列
接下来演示如何向CSV文件中添加新的列。
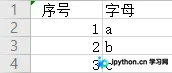
首先定义一个列表data,包含元素['a','b','c']。然后,通过df['字母'] = data将data赋值给名为'字母'的新列。
import pandas as pd
filename = './test.csv'
df = pd.read_csv(filename,encoding='gbk')
data = ['a','b','c']
df['字母'] = data
df.to_csv(filename,index=None)
由于CSV文件中的列标签包含中文字符,因此在读取文件时需指定encoding='gbk'以正确解析编码。
假设文件位于当前Python工程目录下,因此文件路径filename设置为'./test.csv';若文件在其他位置,可替换为对应的绝对路径。
使用pandas添加新行
接下来演示如何向CSV文件中添加新的行。
使用df.loc[4]=[4,'d']语句,在索引为4的位置添加一行数据,包含值4和'd'。
import pandas as pd
filename = './test.csv'
df = pd.read_csv(filename,encoding='gbk')
# data = ['a','b','c']
# df['字母'] = data
df.loc[4]=[4,'d']
df.to_csv(filename,index=None)
以上即为利用pandas向CSV添加新行和列的完整操作过程,希望能对读者的学习有所帮助,也欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















