


Python使用xlrd与xlwt对比Excel并提取差异数据

发布时间:2026-10-13 |
5人浏览过
本文介绍如何利用Python的xlrd和xlwt库,对比两个Excel文件中指定列的数据。通过读取1.xlsx与2.xlsx的A、B列,筛选出在1.xlsx中存在但2.xlsx中缺失的行,并将这些差异数据写入result.xlsx文件,实现简单的数据去重与差异分析。
Excel数据对比需求与目标
本次任务涉及两个Excel文件:1.xlsx和2.xlsx。核心需求是对比这两个文件中A列与B列的数据,具体目标是找出在1.xlsx中存在但在2.xlsx中不存在的行数据,并将这些差异结果输出保存至result.xlsx文件中。
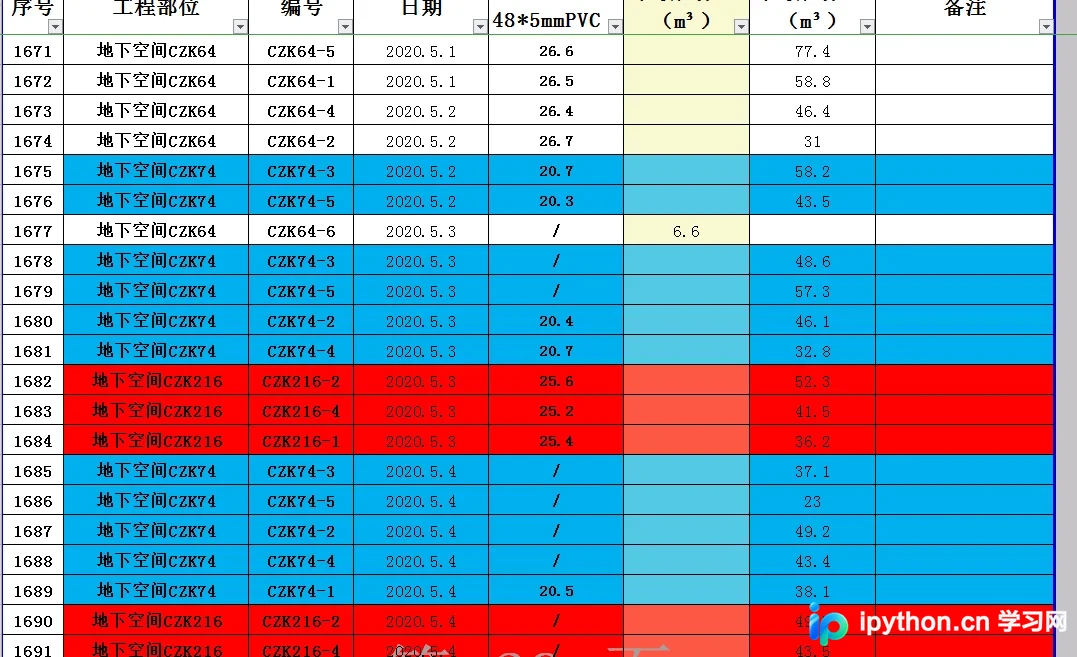
文件1.xlsx的具体内容如下所示:
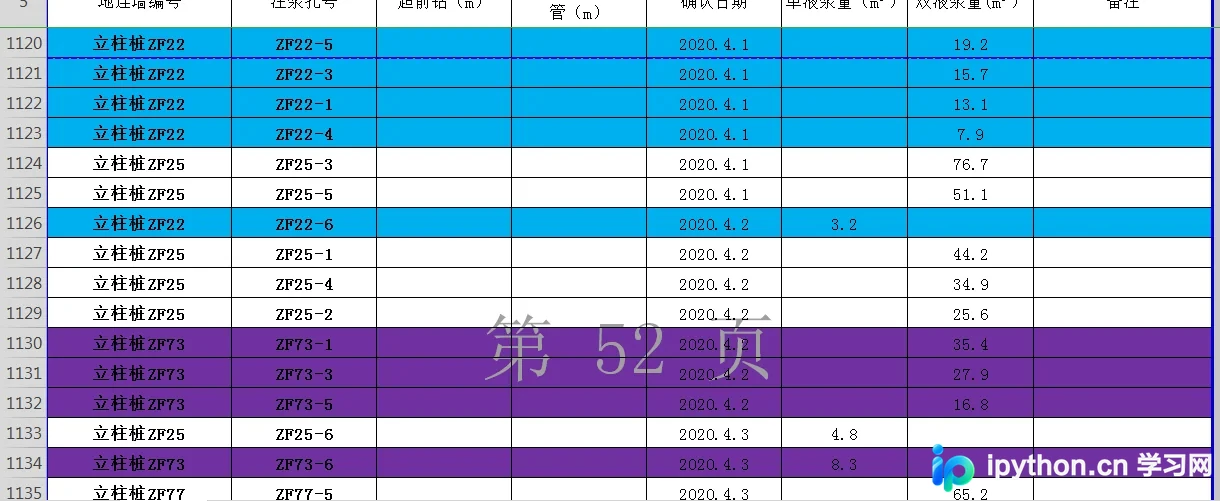
文件2.xlsx的具体内容如下所示:
Python实现代码解析
以下是实现该功能的具体代码:
# coding=utf-8

import xlrd
import xlwt

# 打开文件
#data = xlrd.open_workbook('./附件7:溶洞钻孔、埋管、注浆.xlsx')

# 查看工作表
#data.sheet_names()
#print("sheets:" + str(data.sheet_names()))

# 通过文件名获得工作表,获取工作表1
#table = data.sheet_by_name('20200404')

# 打印data.sheet_names()可发现,返回的值为一个列表,通过对列表索引操作获得工作表1
# table = data.sheet_by_index(0)

# 获取行数和列数
# 行数:table.nrows
# 列数:table.ncols
#print("总行数:" + str(table.nrows))
#print("总列数:" + str(table.ncols))

# 获取整行的值 和整列的值,返回的结果为数组
# 整行值:table.row_values(start,end)
# 整列值:table.col_values(start,end)
# 参数 start 为从第几个开始打印,
# end为打印到那个位置结束,默认为none
#print("整行值:" + str(table.row_values(0)))
#print("整列值:" + str(table.col_values(1)))

# 获取某个单元格的值,例如获取B3单元格值
#cel_B3 = table.cell(3,2).value
#print("第三行第二列的值:" + cel_B3)

def read_xlrd(excelFile,tablename):
  data = xlrd.open_workbook(excelFile)
  #table = data.sheet_by_index(0)
  table = data.sheet_by_name(tablename)
  print("总行数:" + str(table.nrows))
  print("总列数:" + str(table.ncols))
  dataFile = []

  for rowNum in range(table.nrows):
    # if 去掉表头
    if rowNum > 0:
      dataFile.append(table.row_values(rowNum))

  return dataFile


workbook = xlwt.Workbook(encoding = 'ascii')
worksheet = workbook.add_sheet('sheet1')

def writeLine(row ,line):
  col=0
  while col <len(line):
    worksheet.write(row,col, line[col])
    col+=1

filename1='./附件7:溶洞钻孔、埋管、注浆.xlsx'
data1=read_xlrd(filename1,'20200404')
filename2='./设计之都溶洞注浆台账.xlsx'
data2=read_xlrd(filename2,'Sheet1')
data=[]
for row in data1[4:]:
  #print(row[0],row[1])
  data.append([row[0],row[1]])
#print(data)
result=[]
i=0
for row in data2[1:]:

  buf=[row[1],row[2]]
  if buf not in data:
    print(row,'不存在')
    writeLine(i, row)
    i+=1
workbook.save('result.xlsx')
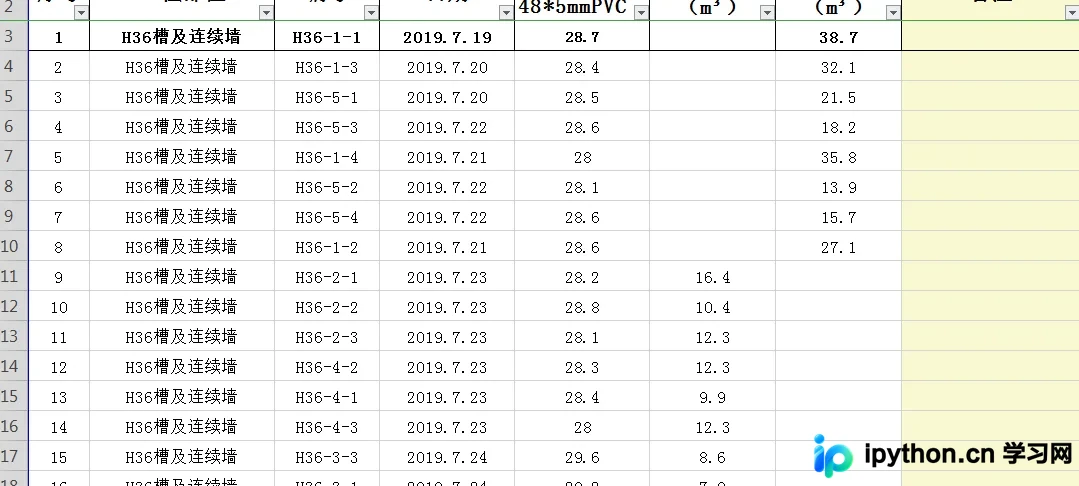
运行上述代码后,系统会生成结果文件result.xlsx,其中包含筛选出的差异数据。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















