


Python爬取YY评级分数并保存数据实现过程解析

本文介绍使用Python编写爬虫批量获取YY评级分数的方法。通过解析Ajax GET请求URL规律,提取企业名称变量构建请求。重点讲解如何携带登录Cookie维持会话状态,并利用正则表达式从JSON响应中提取评级数据。最终实现将安徽省100多条发债企业数据保存至本地,适用于大规模企业评级信息查询场景。
前言与背景
前言
当面临大规模数据查询需求时,例如查询某省份所有发债企业的YY评级分数,人工逐一查询效率极低。因此,编写自动化爬虫程序成为更优解决方案。
鉴于该爬虫逻辑较为简单,此处仅做简要概述。
请求端构建与URL分析
一、请求端构建
首先通过浏览器开发者工具(F12或右键检查)进入Network面板,筛选XHR请求并查看Headers,以分析YY评级网页的信息交互方式。
观察发现请求类型为GET(此类网页通常采用Ajax GET方式,需总结实际URL的生成规律)。
绿色框显示的是实际请求URL,分析可知其由两部分组成:前半部分固定为“https://web.ratingdog.cn/v1/search?”,后半部分由黄色框内内容通过“&”符号连接而成。其中,只有企业名称是变量且已知,据此即可确定完整的请求URL。
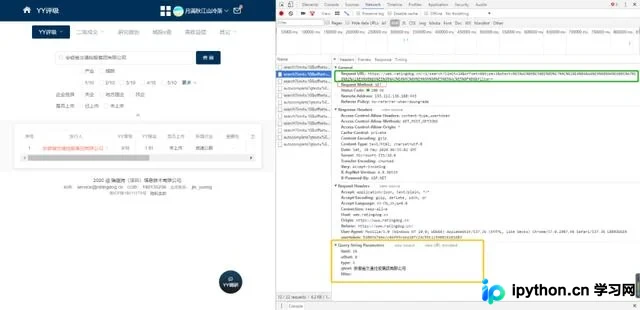
需要注意的是,YY评级平台要求登录才能查询数据。因此在构建请求头部信息时,必须提前完成登录操作,并将登录后的Cookie及状态信息放入Header中,以确保访问权限。
响应端数据解析
二、响应端解析
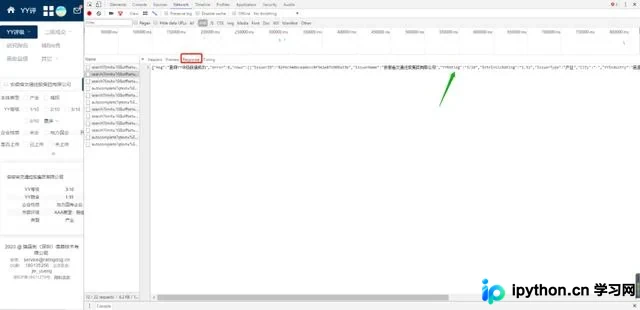
通过观察网页响应信息(F12或右键检查,点击Network—>XHR—>Response),可以看到响应内容非常简单。我们所需的YY评级分数直接包含在返回数据中,只需使用一个正则表达式即可提取该数据。正则表达式如下:
"msg".*?"IssuerName":"(.*?)","YYRating":"(.*?)/10","IntrinsicRating".*?"
代码实现与结果展示
三、代码实现
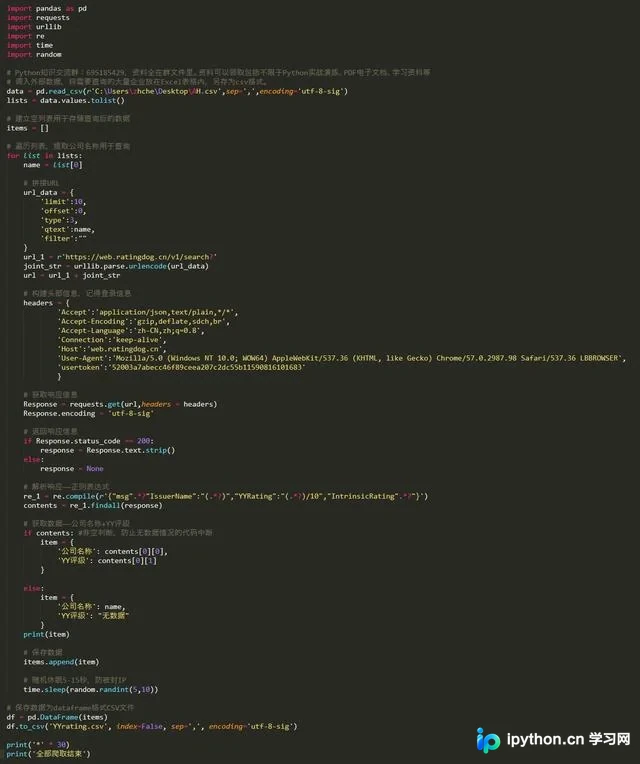
由于所需数据量不大,代码结构相对简单,无需封装复杂函数,直接线性执行即可。具体代码如下:
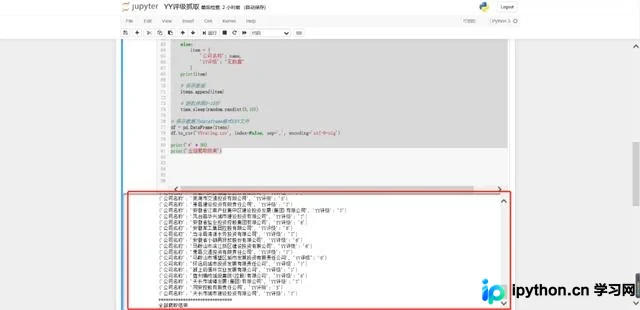
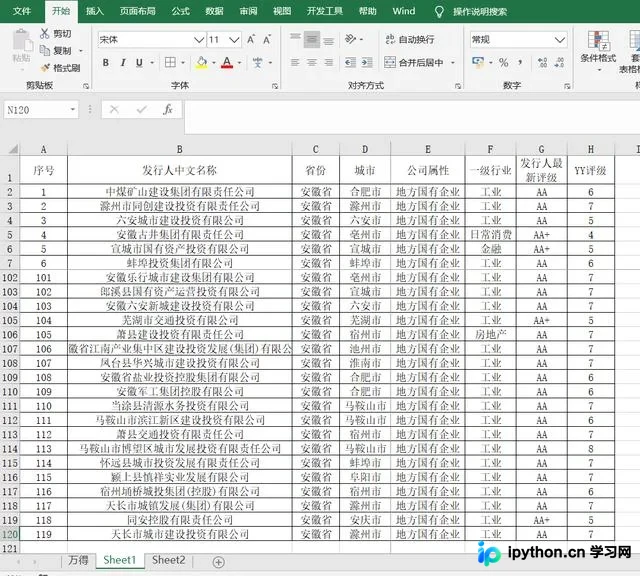
运行上述代码后,得到如下结果。安徽省的100多条数据已成功保存至本地。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















