


k-means 聚类算法原理与 Python 代码实现详解

本文详细解析 k-means 聚类算法的核心思想,涵盖从随机初始化聚类中心到迭代更新均值的完整流程。通过 Python 代码展示如何利用 numpy 和 matplotlib 实现聚类过程及结果可视化,帮助开发者理解算法逻辑并快速上手应用。
k-means 聚类算法概述
k-means 聚类算法的基本思路是首先随机选取 k 个初始聚类中心,将数据集中的每个元素分配给距离最近的聚类中心,从而形成初步的聚类结果。随后,计算每个聚类中所有元素的均值,并将该均值作为新的聚类中心,重复这一分配与更新过程,经过 n 次迭代后得到最终的聚类结果。以下将分步解析这一过程。
算法步骤详解
一、初始化聚类中心
初始化阶段,首先从数据集中随机选取一个元素作为第一个聚类中心并加入容器。接着,选择距离第一个聚类中心最远的元素作为第二个聚类中心。对于第三、第四直至第 N 个聚类中心,采用类似的策略进行选取。为了优化初始化效果,可以使用距离的平方根作为评判标准,以确保初始中心分布更具代表性。
二、迭代聚类
在迭代过程中,依次遍历数据集中的每个元素,将其分配给距离最近的聚类中心,并存入对应的新的容器。完成一次所有元素的分配后,计算每个新容器中元素的均值,并以此均值更新对应的聚类中心。重复执行聚类操作,经过 n 次迭代后,即可得到理想的聚类结果。
三、可视化展示
为了直观地查看聚类效果,可以利用 Python 第三方库 matplotlib.pyplot 提供的可视化工具,将聚类后的元素以散点图的形式展示出来。通过不同颜色区分不同的聚类簇,可以清晰地观察聚类中心与各元素的空间分布关系。
Python 代码实现与可视化
python代码实现
import numpy as np
import matplotlib.pyplot as plt

# 两点距离
def distance(e1, e2):
  return np.sqrt((e1[0]-e2[0])**2+(e1[1]-e2[1])**2)

# 集合中心
def means(arr):
  return np.array([np.mean([e[0] for e in arr]), np.mean([e[1] for e in arr])])

# arr中距离a最远的元素,用于初始化聚类中心
def farthest(k_arr, arr):
  f = [0, 0]
  max_d = 0
  for e in arr:
    d = 0
    for i in range(k_arr.__len__()):
      d = d + np.sqrt(distance(k_arr[i], e))
    if d > max_d:
      max_d = d
      f = e
  return f

# arr中距离a最近的元素,用于聚类
def closest(a, arr):
  c = arr[1]
  min_d = distance(a, arr[1])
  arr = arr[1:]
  for e in arr:
    d = distance(a, e)
    if d < min_d:
      min_d = d
      c = e
  return c


if __name__=="__main__":
  ## 生成二维随机坐标(如果有数据集就更好)
  arr = np.random.randint(100, size=(100, 1, 2))[:, 0, :]

  ## 初始化聚类中心和聚类容器
  m = 5
  r = np.random.randint(arr.__len__() - 1)
  k_arr = np.array([arr[r]])
  cla_arr = [[]]
  for i in range(m-1):
    k = farthest(k_arr, arr)
    k_arr = np.concatenate([k_arr, np.array([k])])
    cla_arr.append([])

  ## 迭代聚类
  n = 20
  cla_temp = cla_arr
  for i in range(n):  # 迭代n次
    for e in arr:  # 把集合里每一个元素聚到最近的类
      ki = 0    # 假定距离第一个中心最近
      min_d = distance(e, k_arr[ki])
      for j in range(1, k_arr.__len__()):
        if distance(e, k_arr[j]) < min_d:  # 找到更近的聚类中心
          min_d = distance(e, k_arr[j])
          ki = j
      cla_temp[ki].append(e)
    # 迭代更新聚类中心
    for k in range(k_arr.__len__()):
      if n - 1 == i:
        break
      k_arr[k] = means(cla_temp[k])
      cla_temp[k] = []

  ## 可视化展示
  col = ['HotPink', 'Aqua', 'Chartreuse', 'yellow', 'LightSalmon']
  for i in range(m):
    plt.scatter(k_arr[i][0], k_arr[i][1], linewidth=10, color=col[i])
    plt.scatter([e[0] for e in cla_temp[i]], [e[1] for e in cla_temp[i]], color=col[i])
  plt.show()
结果展示
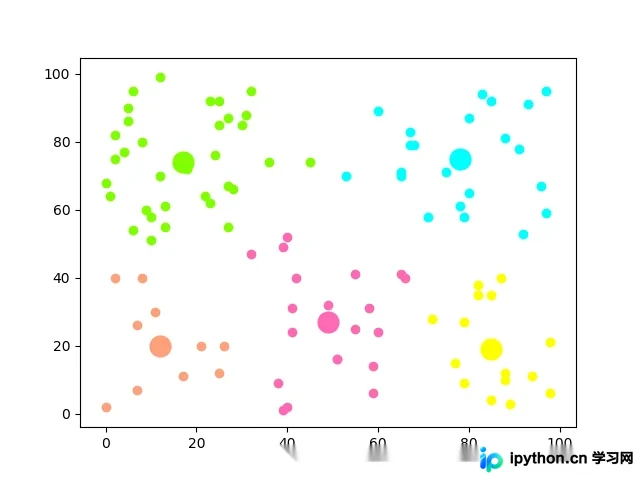
总结
至此,关于 k-means 聚类算法及其 Python 实现代码的介绍已完成。如需了解更多相关 k-means 聚类算法与 Python 的内容,建议搜索本站历史文章或继续浏览下方相关链接。感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















