


Python顺序表详解:原理、实现与动态扩容机制

本文深入解析顺序表的逻辑结构与物理存储,对比一体式与分离式两种实现方式。重点阐述Python中list采用的分离式动态顺序表技术,包括其基于容量阈值的倍增或加倍扩容策略,并通过C语言与Python代码示例展示增删改查操作及时间复杂度特性。
顺序表的基本概念与存储原理
1、顺序表介绍
顺序表属于最基础的线性结构,其核心特征在于逻辑上相邻的数据元素在计算机内存中也是连续存储的。这种存储方式使得我们可以快速定位并访问任意位置的元素,但同时也意味着元素之间不允许存在空隙。因此,在执行插入或删除操作时,往往需要移动大量后续元素以维持连续性。在内存分配上,顺序表通常预先分配一段大小为Maxsize的连续空间,通过指针elem指向存储区的基地址,并使用变量length记录当前实际包含的元素数量,以此定义顺序表的长度。
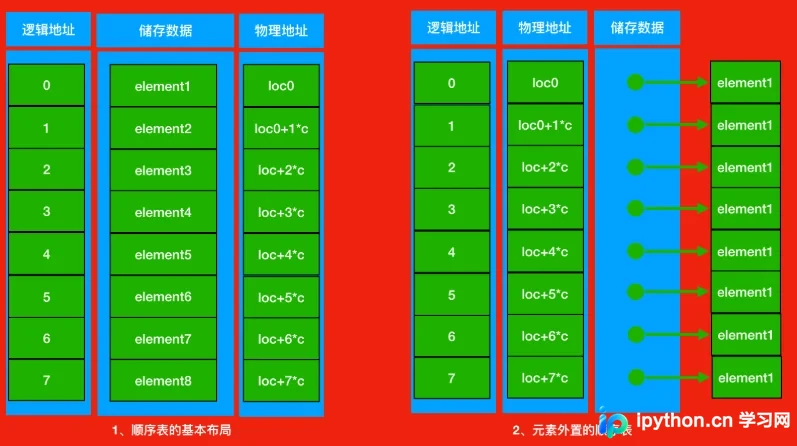
图1展示了顺序表的基本形态:数据元素本身在内存中连续存放,且每个元素占用的存储单元大小固定且相同。此时,元素的下标直接对应其逻辑地址。元素在物理内存中的实际地址(物理地址)可通过起始地址Loc(e0)加上逻辑地址(即第i个元素的下标i)与单个存储单元大小c的乘积计算得出,公式为:Loc(element i) = Loc(e0) + c*i。
由于具备上述数学关系,访问指定元素时无需从头开始遍历整个列表,只需通过公式计算即可直接获得目标地址,因此其时间复杂度为O(1)。
若数据元素大小不统一,则需采用图2所示的元素外置存储形式。此时,顺序表的各单元仅保存指向实际数据元素的地址信息(即链接),而实际数据存储在外部。由于每个链接所占用的存储量是固定且相同的,我们仍可通过上述公式计算出链接本身的存储位置,随后顺着链接找到实际的数据元素。值得注意的是,图2中的c代表的是存储一个地址所需的内存大小,该值通常非常小。
图2所示的这种结构本质上是对实际数据建立了一种索引,属于最简单的索引结构。
顺序表的结构与实现方式
2、顺序表的结构
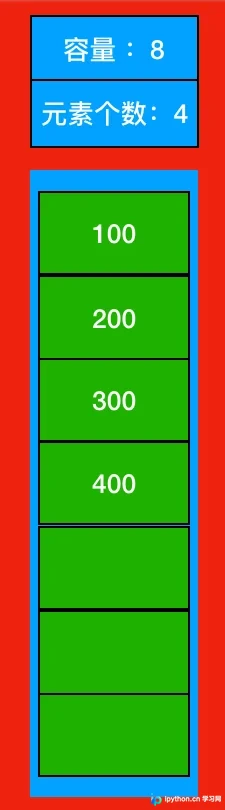
一个完整的顺序表信息包含两个部分:一是表中实际存储的元素集合,二是为实现正确操作而必须记录的元数据信息。这部分元数据主要记录了存储区的总容量以及当前表中已存在的元素个数。
3、顺序表的两种基本实现方式
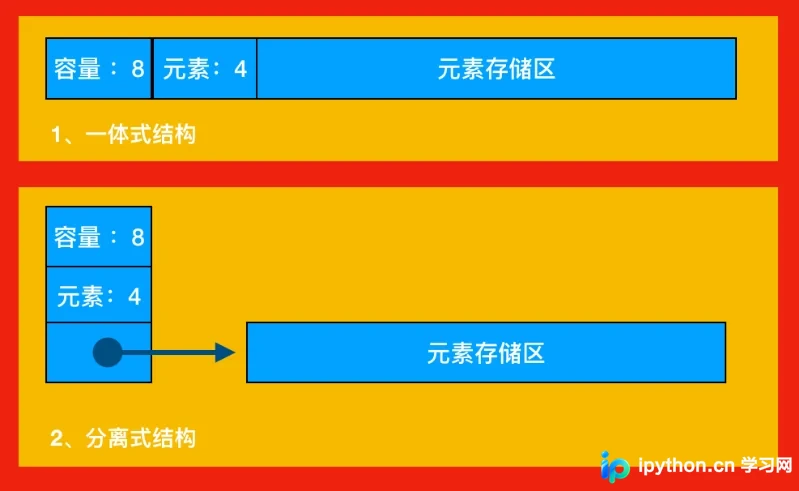
第一种为一体式结构。在此结构中,存储表元数据信息的单元与存储实际数据的元素区以连续的方式安排在同一块存储区域内,两部分数据共同构成一个完整的顺序表对象。一体式结构整体性强,便于管理。然而,由于数据元素存储区是表对象不可分割的一部分,顺序表一旦创建,其元素存储区的大小即被固定,无法动态调整。
第二种为分离式结构。在此结构中,表对象仅保存与整个表相关的元数据(如容量和元素个数),而实际的数据元素存放在另一个独立的存储区域中。表对象通过链接(指针)与独立的数据存储区关联。
元素存储区的替换与动态扩充策略
4、元素存储区替换
对于一体式结构,由于表信息区与数据区连续存储,若要更换数据区,必须对整个顺序表对象(包括存储结构信息的区域)进行整体搬迁,导致整个对象发生变化。而对于分离式结构,若要更换数据区,只需更新表信息区中指向数据区的链接地址即可,顺序表对象本身保持不变。
5、元素存储区扩充
采用分离式结构的顺序表,若需将数据区更换为存储空间更大的区域,可以在不改变表对象的前提下对数据存储区进行扩充。只要运行环境(计算机系统)仍有空闲存储,这种表结构就不会因空间不足而导致操作失败。人们将采用这种技术实现的顺序表称为动态顺序表,因为其容量可以在程序运行过程中动态变化。
扩充的两种策略
策略一:每次扩充增加固定数目的存储位置,例如每次扩充增加10个元素位置。这种策略被称为线性增长。
特点:虽然节省空间,但会导致频繁的扩充操作,执行次数较多。
策略二:每次扩充容量加倍,例如每次扩充增加一倍存储空间。
特点:减少了扩充操作的执行次数,但可能会造成一定的空间浪费。这是一种以空间换时间的策略,通常被推荐采用。
顺序表操作的代码实现
6、顺序表的增删改查操作的Python代码实现
# 创建顺序表class Sequence_Table():
 # 初始化
 def __init__(self):
 self.date = [None]*100
 self.length = 0
 # 判断是否已经满了
 def isFull(self):
 if self.length>100:
 print("该顺序表已满,无法添加元素")
 return 1
 else:
 return 0
 # 按下表索引查找
 def selectByIndex(self,index):
 if index>=0 and index<=self.length-1:
 return self.date[index]
 else:
 print("你输入的下标不对,请重新输入\n")
 return 0
 # 按元素查下标
 def selectByNum(self,num):
 isContain = 0
 for i in range(0,self.length):
 if self.date[i] == num:
 isContain = 1
 print("你要查找的元素下标是%d\n"%i)
 if isContain == 0:
 print("没有找你你要的数据")
 # 追加数据
 def addNum(self,num):
 if self.isFull() == 0:
 self.date[self.length] = num
 self.length += 1
 # 打印顺序表
 def printAllNum(self):
 for i in range(self.length):
 print("a[%s]=%s"%(i,self.date[i]),end=" ")
 print("\n")
 # 按下标插入数据
 def insertNumByIndex(self,num,index):
 if index<0 or index>self.length:
 return 0
 self.length += 1
 for i in range(self.length-1,index,-1):
 temp = self.date[i]
 self.date[i] = self.date[i-1]
 self.date[i-1] = temp
 self.date[index] = num
 return 1 # 按下标删除数据
 def delectNumByIndex(self,index):
 if self.length <= 0:
 print("该顺序表内没有数据,不用删除")
 for i in range(index,self.length-1):
 temp = self.date[i]
 self.date[i] = self.date[i + 1]
 self.date[i + 1] = temp
 self.date[self.length-1] = 0
 self.length -= 1def main(): # 创建顺序表对象
 seq_t = Sequence_Table()
 # 插入三个元素
 seq_t.addNum(1)
 seq_t.addNum(2)
 seq_t.addNum(3)
 # 打印验证
 seq_t.printAllNum()
 # 按照索引查找
 num = seq_t.selectByIndex(2)
 print("你要查找的数据是%d\n" % num)
 # 按照索引插入数据
 seq_t.insertNumByIndex(4, 1)
 seq_t.printAllNum()
 # 按照数字查下标
 seq_t.selectByNum(4)
 #删除数据
 seq_t.delectNumByIndex(1)
 seq_t.printAllNum()
if __name__ == "__main__":
 main()
运行结果为:
a[0]=1 a[1]=2 a[2]=3 你要查找的数据是3 a[0]=1 a[1]=4 a[2]=2 a[3]=3 你要查找的元素下标是1 a[0]=1 a[1]=2 a[2]=3
7、顺序表的增删改查操作的C语言代码实现
#include<stdio.h>
// 1、定义顺序表的储存结构
typedef struct
{
 //用数组存储线性表中的元素
 int data[100];
 // 顺序表中的元素个数
 int length;
}Sequence_table,*p_Sequence_table;
// 2、顺序表的初始化,
void initSequenceTable(p_Sequence_table T)
{
 // 判断传过来的表是否为空,为空直接退出
 if (T == NULL)
 {
 return;
 }
 // 设置默认长度为0
 T->length = 0;
}
// 3、求顺序表的长度
int lengthOfSequenceTable(p_Sequence_table T)
{
 if (T==NULL)
 {
 return 0;
 }
 return T->length;
}
// 4、判断顺序表是否已满
int isFull(p_Sequence_table T)
{
 if (T->length>=100)
 {
 printf("该顺序表已经装满,无法再添加元素");
 return 1;
 }
 return 0;
}
// 5、按序号查找
int selectSequenceTableByIndex(p_Sequence_table T,int index)
{
 if (index>=0&&index<=T->length-1)
 {
 return T->data[index];
 }
 printf("你输入的序号不对,请重新输入\n");
 return 0;
}
// 6、按内容查找是否存在
void selectSequenceTableByNum(p_Sequence_table T,int num)
{
 int isContain = 0;
 for (int i=0; i<T->length; i++)
 {
 if (T->data[i] == num)
 {
 isContain = 1;
 printf("你要找的元素的下标是:%d\n",i);
 }
 }
 if (isContain == 0)
 {
 printf("没有找到你要的数据\n");
 }
}
// 7、添加元素(在队尾添加)
void addNumber(p_Sequence_table T,int num)
{
 // 顺序表还没有满的时候
 if (isFull(T) == 0)
 {
 T->data[T->length] = num;
 T->length++;
 }
}
// 8、顺序表的遍历
void printAllNumOfSequenceTable(p_Sequence_table T)
{
 for (int i = 0; i<T->length; i++)
 {
 printf("T[%d]=%d ",i,T->data[i]);
 }
 printf("\n");
}
//9、插入操作
int insertNumByIndex(p_Sequence_table T, int num,int index)
{
 if (index<0||index>T->length)
 {
 return 0;
 }
 T->length++;
 for (int i = T->length-1; i>index; i--)
 {
 int temp = T->data[i];
 T->data[i] = T->data[i-1];
 T->data[i-1] = temp;
 }
 T->data[index] = num;
 return 1;
}
// 10、删除元素
void delectNum(p_Sequence_table T,int index)
{
 if (T->length <= 0)
 {
 printf("该顺序表中没有数据,不用删除");
 }
 for (int i = index;i<T->length-1; i++)
 {
 int temp = T->data[i];
 T->data[i] = T->data[i+1];
 T->data[i+1] = temp;
 }
 T->data[T->length-1] = 0;
 T->length--;
}
int main(int argc, const char * argv[]) {

 // 创建顺序表的结构体
 Sequence_table seq_t;
 // 初始化
 initSequenceTable(&seq_t);
 // 添加数据
 addNumber(&seq_t, 1);
 addNumber(&seq_t, 2);
 addNumber(&seq_t, 3);
 // 打印验证
 printAllNumOfSequenceTable(&seq_t);
 // 根据索引下标查内容
 int num = selectSequenceTableByIndex(&seq_t, 2);
 printf("你查的数据是:%d\n",num);
 // 插入
 insertNumByIndex(&seq_t, 4, 1);
 printAllNumOfSequenceTable(&seq_t);
 // 根据内容查下标
 selectSequenceTableByNum(&seq_t, 4);
 // 根据下标删除数据
 delectNum(&seq_t, 1);
 printAllNumOfSequenceTable(&seq_t);
 return 0;
}
运行结果为:
T[0]=1 T[1]=2 T[2]=3 你查的数据是:3 T[0]=1 T[1]=4 T[2]=2 T[3]=3 你要找的元素的下标是:1 T[0]=1 T[1]=2 T[2]=3
Python中list的底层实现机制
知识点扩展:
Python中的list和tuple两种类型均采用了顺序表的实现技术,具备前述顺序表的所有性质。
tuple是不可变类型,即不变的顺序表,因此不支持改变其内部状态的任何操作。在其他方面,tuple的性质与list类似。
list的基本实现技术
Python标准类型list是一种元素个数可变的线性表,支持加入和删除元素,并在各种操作中维持已有元素的顺序(即保序)。此外,它还具备以下行为特征:
基于下标(位置)的高效元素访问和更新,其时间复杂度应为O(1);
为满足上述特征,必须采用顺序表技术,将表中元素保存在一块连续的存储区中。
允许任意加入元素,且在不断加入元素的过程中,表对象的标识(通过函数id得到的值)保持不变。
为满足上述特征,必须能够更换元素存储区。为保证在更换存储区时list对象的标识id不变,只能采用分离式实现技术。
在Python的官方实现中,list是一种采用分离式技术实现的动态顺序表。这也是为什么使用list.append(x)(或list.insert(len(list), x),即尾部插入)比在指定位置插入元素效率更高的原因。
在Python的官方实现中,list采用了如下扩容策略:在建立空表(或者很小的表)时,系统分配一块能容纳8个元素的存储区;在执行插入操作(insert或append)时,如果元素存储区已满,则换一块4倍大的存储区。但如果此时的表已经很大(目前的阈值为50000),则改变策略,采用加一倍的方法。引入这种改变策略的方式,是为了避免出现过多空闲的存储位置。
以上就是什么是Python中的顺序表的详细内容,更多关于Python中顺序表详解的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















