


Python Numpy多维数组核心指南:创建、索引与运算实战

本文深入解析Python中Numpy库的核心功能,涵盖ndarray对象的创建、数据类型管理及内存优化。详细演示了从列表生成、arange到文件读写的全流程,重点讲解切片、掩码及高级索引技巧,并介绍矩阵运算、统计分析及形状变换等实用操作,助力高效处理科学计算数据。
Numpy模块导入与核心优势
在Python生态中,numpy包几乎是进行数值计算的标配工具。该库为Python提供了高性能的向量、矩阵和张量数据类型。由于底层由C和Fortran编写,当执行向量化操作(即利用矩阵和矢量表示计算过程)时,其运行效率极高。
1.模块导入
%matplotlib inline
import matplotlib.pyplot as plt
from numpy import *
Numpy数组的创建方法
2.数组创建基础
初始化numpy数组有多种途径,例如直接利用Python的list或tuple进行转换;使用专门用于生成Numpy数组的函数,如arange、linspace等;或者从外部文件读取数据(包括Python pickle格式等)。
2.1基于列表创建numpy.array
v = array([1,2,3,4])
v
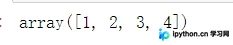
M = array([[1, 2], [3, 4]])
M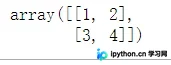
变量v和M均为由numpy模块创建的ndarray类型对象。
type(v), type(M)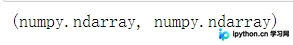
v数组与M数组的主要区别在于它们的维度(shape)。我们可以通过访问ndarray.shape属性来获取具体的尺寸信息。
v.shape
M.shape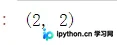
矩阵中元素的总数量可以通过ndarray.size属性直接获取。
M.size
此外,也可以调用numpy内置方法numpy.shape和numpy.size来实现相同功能。
shape(M)
size(M)
虽然numpy.ndarray在外观上类似于普通的Python列表,但使用ndarray而非原生list具有多重优势。
Python列表非常通用,可包含任意类型的对象,且属于动态类型。然而,它们不支持矩阵乘法等数学运算。由于动态类型的开销,在Python中通过list实现此类数值运算效率较低。 相比之下,Numpy数组是静态类型且同质的。元素的数据类型在创建数组时即已确定(尽管后续可更改数组的数据类型属性)。 Numpy数组在内存占用上更为紧凑。 得益于静态类型化,诸如乘积和求和等数学函数可以在编译型语言(如C和Fortran)中实现,从而显著提升执行速度。 通过访问ndarray数组的dtype(数据类型)属性,我们可以查看数组中存储的具体数据类型。
M.dtype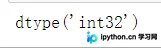
若尝试分配与数组现有类型不符的值,系统将抛出错误。
M[0,0] = "hello"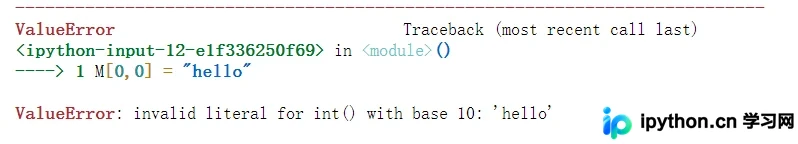
在创建数组时,可以明确指定数据类型。
M = array([[1, 2], [3, 4]], dtype=complex)
M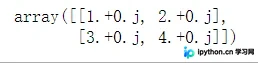
常用的dtype值包括:int、float、complex、bool、object等。
我们也可以进一步指定比特大小,例如int64、int16、float128、complex128等。
利用函数生成数组
3.利用函数生成数组
使用Python列表来定义大型数组既不切实际也不高效。此时,可以借助各种Numpy提供的专用方法。
3.1 arange函数
x = arange(0, 10, 1) # arguments: start, stop, step
x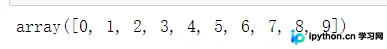
x = arange(-1, 1, 0.1)
x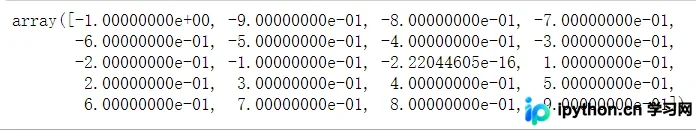
3.2 linspace与logspace函数
使用linspace时,区间的两端均被包含在内。其参数格式为:(起始值,终止值,点的数量)。
linspace(0, 10, 25)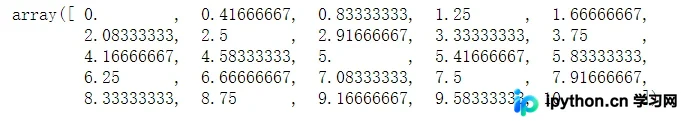
logspace(0, 10, 10, base=e)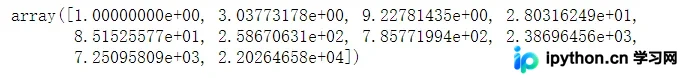
3.3 mgrid函数
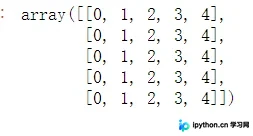
x, y = mgrid[0:5, 0:5]
x
y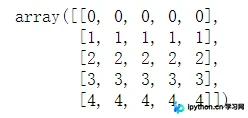
3.4 随机数生成
#导入所需模块
from numpy import random
#区间[0,1]内的均匀分布数。
random.rand(5,5)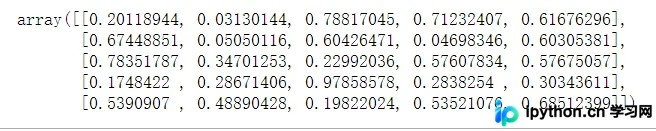
#来自于正态分布的随机数
random.randn(5,5)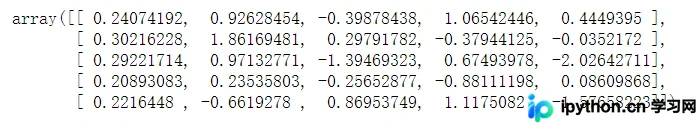
3.6 diag函数
#对角矩阵
diag([1,2,3])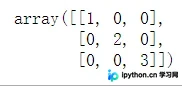
#偏移对角矩阵
diag([1,2,3], k=1)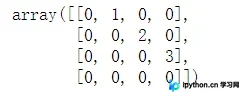
3.5 零矩阵和单位矩阵生成
zeros((3,3))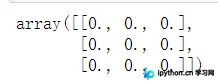
ones((3,3))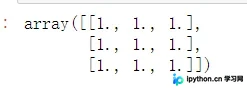
文件的导入与导出
4.文件的导入与导出
4.1 逗号分隔值(CSV)格式处理
一种极为常见的数据存储格式是CSV,以及类似的TSV(制表分隔值)。要从这些文件中读取数据,可以使用numpy.genfromtxt方法。
data = genfromtxt('stockholm_td_adj.dat')
data.shape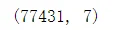
fig, ax = plt.subplots(figsize=(14,4))
ax.plot(data[:,0]+data[:,1]/12.0+data[:,2]/365, data[:,5])
ax.axis('tight')
ax.set_title('Температура в Стокгольме')
ax.set_xlabel('год')
ax.set_ylabel('температура (C)');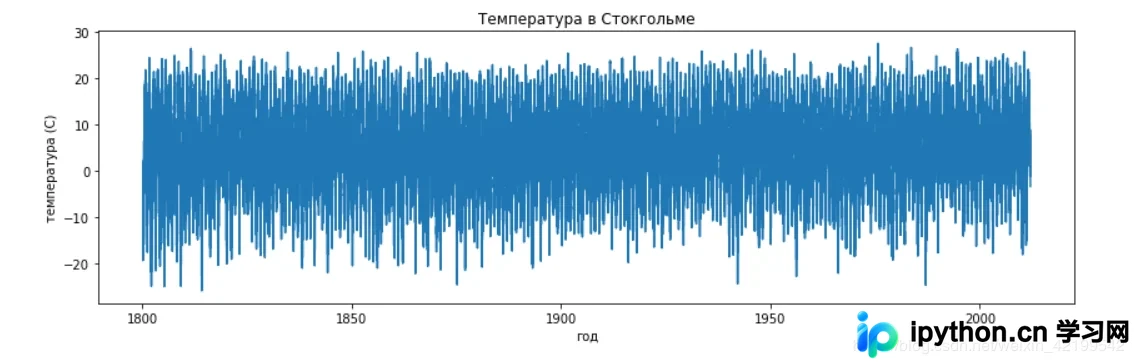
利用numpy.savetxt函数,我们可以将数组数据保存为CSV格式文件。
M = random.rand(3,3)
M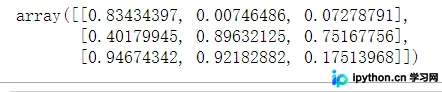
savetxt("random-matrix.csv", M)
savetxt("random-matrix.csv", M, fmt='%.5f') # fmt 指定格式
4.2 Numpy数组的主要文件格式
保存和读取Numpy数组的标准方法分别对应numpy.save和numpy.load。
save("random-matrix.npy", M)
load("random-matrix.npy")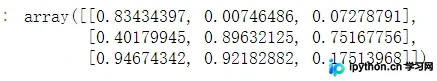
4.3 Numpy数组的其他重要属性
M.itemsize表示每个元素占用的字节数; M.nbytes表示数组占用的总字节数; M.ndim表示数组的维度数量。
数组的索引与切片操作
5.数组的使用技巧
5.1 编制索引
你可以使用方括号配合索引值来选择数组中的特定元素。
# v是一个只有一个维度的向量,所以一个索引就足以获得元素。
v[0]
# M是一个矩阵(二维数组),所以需要两个索引(行,列)。
M[1,1]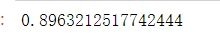
如果在多维数组中省略部分索引,通常会返回一个低一维的数组(一般情况下为N-1维)。
M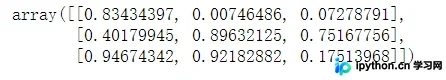
M[1]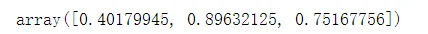
M[1,:]#第一行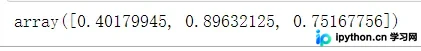
M[:,1]#第一列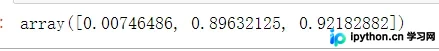
利用索引语法,你可以直接为数组中的单个元素赋值。
M[0,0] = 1
M
这种赋值操作同样适用于整行或整列的数据。
#也适用于行和列
M[1,:] = 0
M[:,2] = -1
M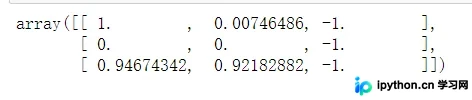
5.2 选取数组的部分内容
你可以使用M[lower:upper:step]的切片语法来获取数组的一个子集。
A = array([1,2,3,4,5])
A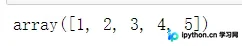
A[1:3]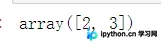
数组切片是可变视图:如果给切片分配新值,原数组中对应的部分也会随之改变。
A[1:3] = [-2,-3]
A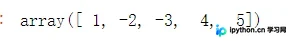
在M[lower:upper:step]语法中,我们可以省略部分参数以使用默认值。
A[::]#下限、上限、默认步数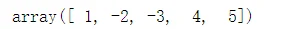
负数索引表示从数组末尾开始计算位置。
A = array([1,2,3,4,5])
A[-1]#最后一个元素
A[-3:]#最后三个元素
索引切片技术同样适用于多维数组的操作。
A = array([[n+m*10 for n in range(5)] for m in range(5)])
A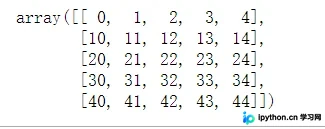
#方阵
A[1:4, 1:4]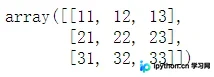
#渐进,带有指定间隔数
A[::2, ::2]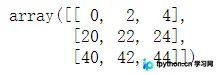
5.3 高级索引方法
数组的值本身可以作为选择元素的索引依据。
row_indices = [1, 2, 3]
A[row_indices]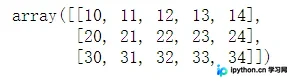
col_indices = [1, 2, -1]
A[row_indices, col_indices]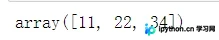
你还可以使用掩码机制:如果掩码类型为布尔型(bool),则根据掩码元素的值(True或False)来决定是否选择对应的数组元素。
B = array([n for n in range(5)])
B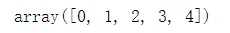
row_mask = array([True, False, True, False, False])
B[row_mask]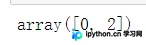
row_mask = array([1,0,1,0,0], dtype=bool)
B[row_mask]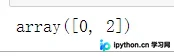
此函数对于根据特定条件从数组中筛选元素非常有用。
x = arange(0, 10, 0.5)
x
mask = (5 < x) * (x < 7.5)
mask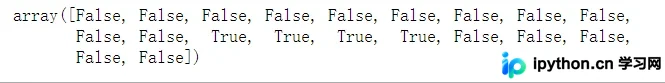
x[mask]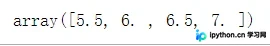
5.4 从数组中提取数据及创建新数组的函数
5.4.1 where函数
索引掩码可以通过where方法转换为位置索引。
indices = where(mask)
indices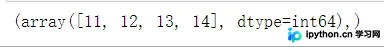
x[indices]#这个索引相当于x[mask]的索引。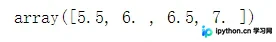
5.4.2 diag函数
使用diag函数还可以提取主对角线及次对角线的元素。
diag(A)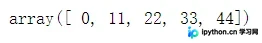
diag(A,-1)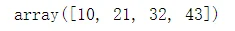
5.4.3 take函数
其功能与上述索引方法类似。
v2 = arange(-3,3)
v2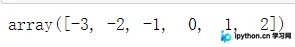
row_indices = [1, 3, 5]
v2[row_indices]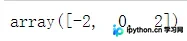
v2.take(row_indices)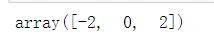
但take函数的适用范围更广,它也可以在列表和其他对象上工作。
take([-3, -2, -1, 0, 1, 2], row_indices)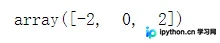
5.4.4 choose函数
该函数用于从多个数组中提取数值。
which = [1, 0, 1, 0]
choices = [[-2,-2,-2,-2], [5,5,5,5]]

choose(which, choices) # 0th elem of 0 array, 1st elem of 1 array, ...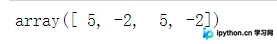
线性代数与矩阵运算
6.线性代数运算
6.1 点积运算
v1 = arange(0, 5)
v1 * 2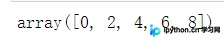
v1 + 2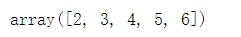
A * 2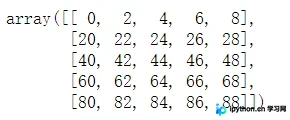
A + 2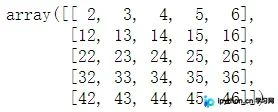
6.2 基础算术运算
A * A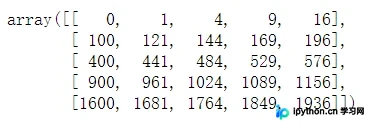
v1 * v1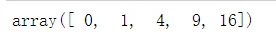
A.shape, v1.shape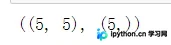
A * v1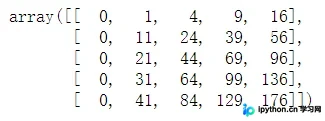
7.矩阵操作
7.1 矩阵类型转换
dot(A, A)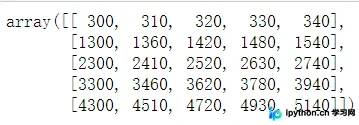
dot(A, v1)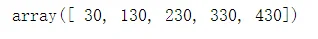
dot(v1, v1)
数组也可以转换为矩阵类型。转换后,即可依据矩阵代数的规则进行加法、减法和乘法运算。
M = matrix(A)
v = matrix(v1).T#换位
v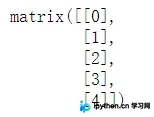
M * M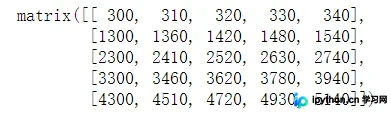
M * v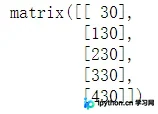
v.T * v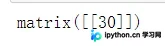
v + M*v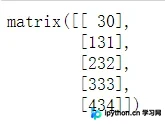
数据处理与统计分析
8.数据处理与分析
shape(data)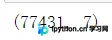
8.1 计算平均值
#温度柱
mean(data[:,3])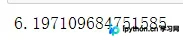
过去200年间,斯德哥尔摩的平均气温约为6.2摄氏度。
8.2 标准差和方差计算
std(data[:,3]), var(data[:,3])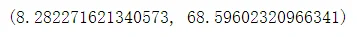
8.3 sum, prod, 和 trace 函数
d = arange(0, 10)
d
#求和
sum(d)
#所有元素的乘积
prod(d+1)
#累计总和
cumsum(d)
#累积乘积
cumprod(d+1)
#和diag(A).sum()一样
trace(A)
8.4 多变量数据分析
m = random.rand(3,3)
m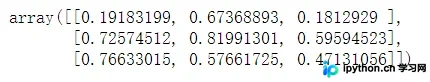
m.max()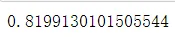
#每列最大值
m.max(axis=0)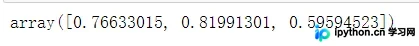
#每行最大值
m.max(axis=1)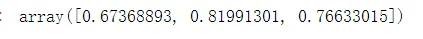
数组形状变换与遍历
9.改变阵列的形状和大小
A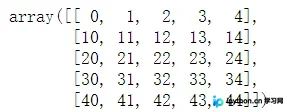
n, m = A.shape
B = A.reshape((1,n*m))
B
B[0,0:5] = 5
B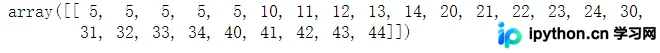
A 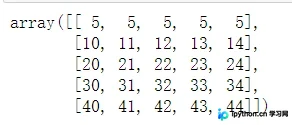
B = A.flatten()
B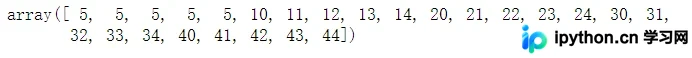
B[0:5] = 10
B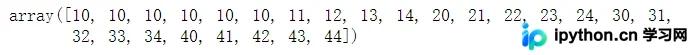
#A没有改变,因为B是A的副本,不是同一个对象的引用。
A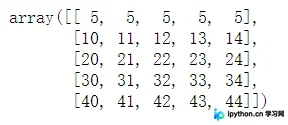
10.增加新的维度:newaxis
v = array([1,2,3])
shape(v)
#向量 -> 单列矩阵
v[:, newaxis]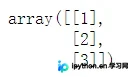
#尺寸
v[:,newaxis].shape
v[newaxis,:].shape
11.数组联合
b = array([[5, 6]])
a = array([[5, 6]])
concatenate((a, b), axis=0)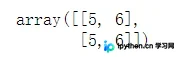
concatenate((a, b), axis=1)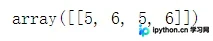
12. hstack和vstack函数
vstack((a,b))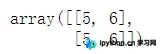
hstack((a,b))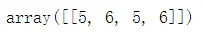
13. Copy与深拷贝("deep copy")
A = array([[1, 2], [3, 4]])
A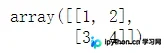
#B等同于A
B = A
#改变B,将影响A
B[0,0] = 10

B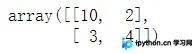
A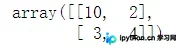
B = copy(A)
#现在改变B将不再影响A
B[0,0] = -5
B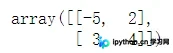
A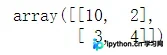
14.矩阵的循环遍历
v = array([1,2,3,4])

for element in v:
  print(element)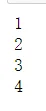
M = array([[1,2], [3,4]])

for row in M:
  print("row", row)

  for element in row:
    print(element)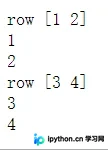
通过enumerate函数,可以同时获取元素的值和索引。
for row_idx, row in enumerate(M):
  print("row_idx", row_idx, "row", row)

  for col_idx, element in enumerate(row):
    print("col_idx", col_idx, "element", element)

    # update the matrix M: square each element
    M[row_idx, col_idx] = element ** 2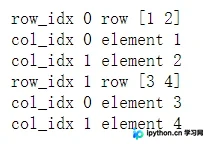
#每个元素现在都是列表
M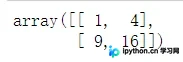
至此,关于Numpy多维数据数组的实现介绍完毕。如需了解更多Numpy多维数据数组相关内容,请搜索本站历史文章或继续浏览后续文章。感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















