


Scrapy模拟登录赶集网的完整实现指南

本文详细讲解如何使用Scrapy框架模拟登录赶集网。通过分析登录接口的POST请求参数,包括setcookie、__hash__及验证码机制,提供完整的Python代码实现。内容涵盖项目创建、Spider编写、表单数据构造及登录后的处理流程,帮助开发者掌握动态参数提取与自动登录技巧。
登录请求参数分析
首先访问赶集网的登录页面,通过浏览器开发者工具进行抓包分析,获取POST请求所需的Request参数。
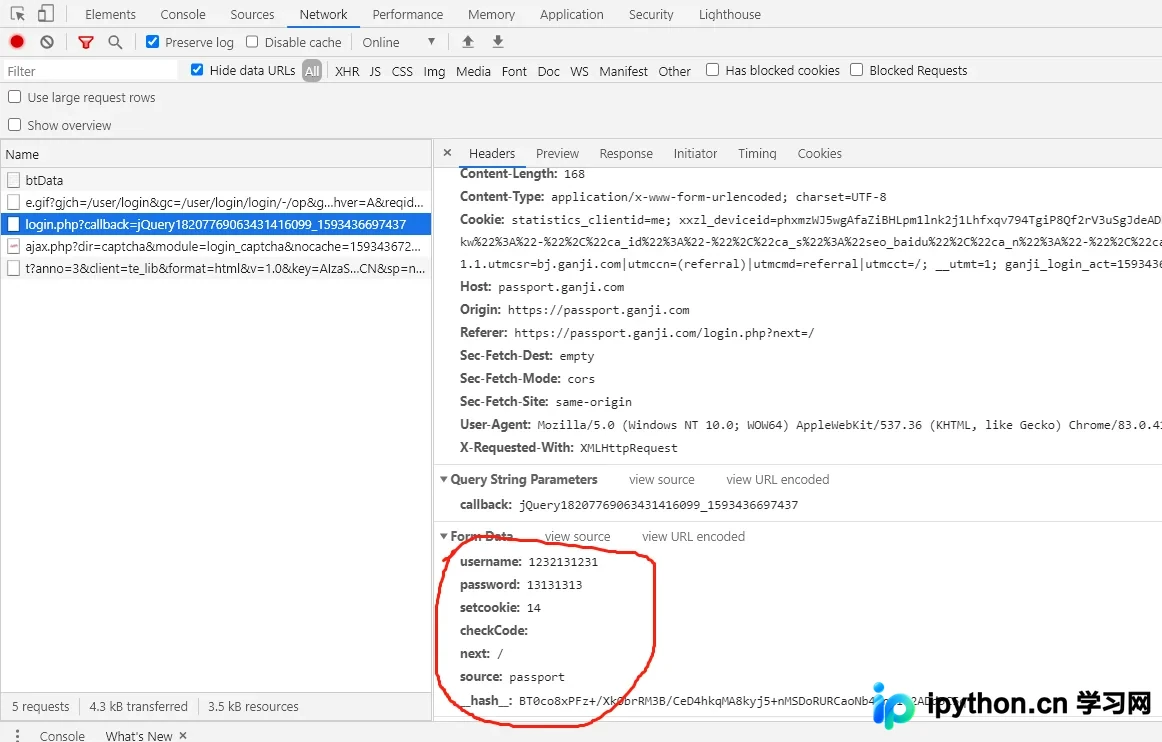
在明确请求结构后,只需构造出对应的参数并传入formdata即可完成登录模拟。
具体参数分析如下:
setcookie字段用于控制是否启用自动登录功能,若未勾选该选项,其默认值为0。
关于__hash__值的获取方法:直接查看服务器返回的网页源代码,利用正则表达式即可提取该值。
Scrapy项目创建与配置
接下来展示具体的代码实现步骤。
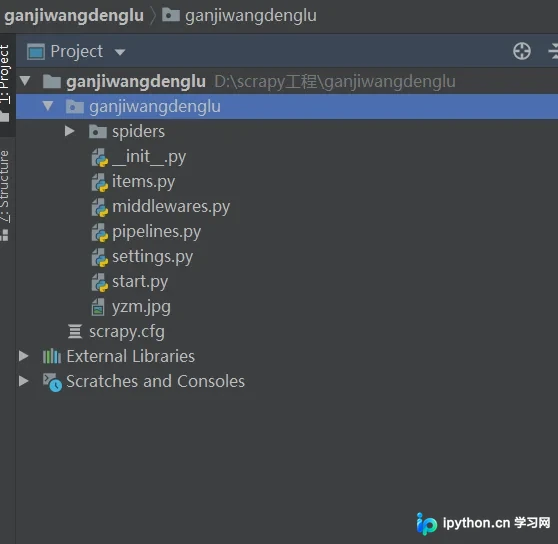
首先激活Python虚拟环境,在命令行中切换至项目所在目录,执行命令scrapy startproject ganjiwangdenglu创建项目,随后使用PyCharm打开该目录进行开发。
在PyCharm的Terminal终端中,运行命令scrapy genspider ganji ganji.com以创建对应的Spider文件,项目目录结构如下所示。
核心代码实现
以下是详细的代码实现部分。
import scrapy
import re

class GanjiSpider(scrapy.Spider):
  name = 'ganji'
  allowed_domains = ['ganji.com']
  start_urls = ['https://passport.ganji.com/login.php']

  def parse(self, response):
    hash_code = re.search(r'"__hash__":"(.+)"}', response.text).group(1) # 正则获取哈希
    img_url = 'https://passport.ganji.com/ajax.php?dir=captcha&module=login_captcha' # 验证码url
    yield scrapy.Request(img_url, callback=self.do_formdata, meta={'hash_code': hash_code}) # 发送获取验证码请求并保存验证码到本地

  def do_formdata(self, response):
    with open('yzm.jpg', 'wb') as f:
      f.write(response.body)
      # 验证码三种方案:1,保存下来手动输入,2,云打码,3 tesseract模块,在这里我们手动输入
    code = input('请输入验证码:')
    # 创建表单
    formdata = {
      'username': 'your_username',
      'password': 'your_password',
      'setcookie': '14',
      'checkCode': code,
      'next': '',
      'source': 'passport',
      '__hash__': response.request.meta['hash_code'] # meta是在respose.request中
    }
    login_url = "https://passport.ganji.com/login.php"
    yield scrapy.FormRequest(url=login_url, formdata=formdata, callback=self.after_login) # 发送登录请求

  def after_login(self, response):
    print(response.text)
运行与结果解析
最后,在终端执行命令scrapy crawl ganji即可运行爬虫,完成登录模拟任务。
登录成功后返回的JSON字符串解析逻辑如下:
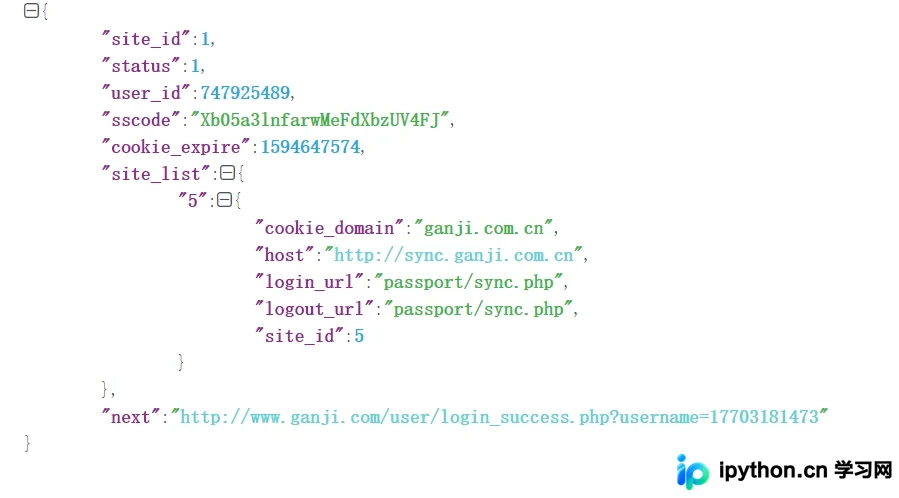
注意:settings.py中的相关配置此处不再赘述,请根据实际需求进行设置。
总结
至此,关于使用Scrapy模拟登录赶集网的教程介绍完毕。如需了解更多Scrapy登录赶集网的相关内容,建议搜索本站历史文章或继续浏览后续文章,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















