


Scrapy中XPath匹配失效:tbody标签导致的常见陷阱与修复

本文分析Scrapy中使用Chrome开发者工具生成的XPath在爬虫中失效的问题。根本原因在于浏览器自动插入tbody标签,而原始HTML结构中可能不存在该标签。通过对比Chrome生成的含tbody XPath与Scrapy实际解析结果,发现需手动移除xpath中的tbody节点。文章提供了使用scrapy shell逐步定位问题的方法,并给出修正后的正确XPath示例,帮助开发者避免此类常见坑点。
引言
在网页数据抓取领域,XPath作为一种简洁高效的定位规则,被广泛用于从复杂的HTML结构中精准提取目标信息。
本文将深入剖析一个典型的XPath匹配失效案例,并展示完整的排查与解决过程。
环境介绍
Python 3.6.1 Scrapy 1.5.0
问题描述
在构建XPath规则时,开发者通常依赖Firefox或Chrome内置的Web开发工具进行可视化选取。
在此过程中,强烈推荐使用Chrome的开发者工具(DevTools)。其功能强大且操作直观,是网页分析中不可或缺的高效工具。
具体操作示意如下:
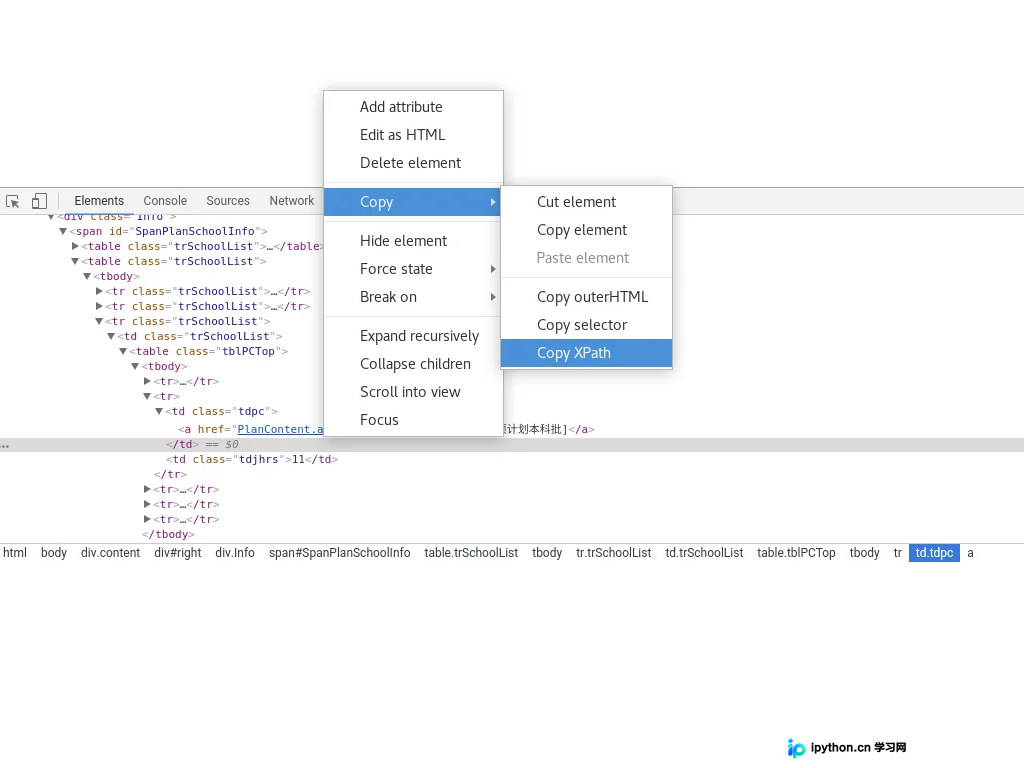
基于XPath提取信息
通过Chrome工具复制得到的XPath路径示例如下:
//*[@id=”SpanPlanSchoolInfo”]/table[2]/tbody/tr[3]/td/table/tbody/tr[2]/td[1]/a在Scrapy的代码逻辑中,该XPath的使用方式如下:
def parse(self, response):
    xpath_url = '//*[@id="SpanPlanSchoolInfo"]/table[2]/tbody/tr[3]/td/table/tbody/tr[2]/td[1]/a'
    urls = response.xpath(xpath_url)
    .....
然而在实际运行Scrapy爬虫时,发现无法匹配到预期的URL列表。尽管页面加载正常且肉眼可见数据存在,但程序返回结果为空,这引发了对问题根源的质疑。
问题分析
从结果反推,若页面存在且数据可见却无输出,问题大概率出在XPath表达式本身。既然该表达式直接源自Chrome DevTools的“Copy XPath”功能,理论上不应出错,这确实令人困惑。
经过反复尝试,利用Scrapy提供的强大交互式调试工具——scrapy shell,可以逐步执行并观察每一步的解析结果,从而快速定位问题所在。
通过逐步简化XPath表达式进行排查,最终锁定问题根源:XPath中包含了tbody标签,而该标签在原始HTML结构中并不需要,甚至可能不存在。
修正后的正确XPath应设置为:
//*[@id=”SpanPlanSchoolInfo”]/table[2]/tr[3]/td/table/tbody/tr[2]/td[1]/a问题总结
虽然问题得以解决,但其背后的原理值得深究。
经分析,主要原因是现代浏览器在渲染HTML时,会自动为table元素插入tbody标签以符合DOM规范。然而,Chrome DevTools生成的XPath默认包含了这个自动生成的tbody节点。当Scrapy解析原始HTML源码时,若源码中未显式包含tbody标签,则包含tbody的XPath将无法匹配。因此,在使用XPath查询时,需手动移除对tbody标签的依赖。
以上为个人实战经验总结,希望能为大家提供有益参考,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















