


解决XGBoost Booster无evals_result_:通过解析命令行输出构建学习曲线

发布时间:2026-10-14 |
5人浏览过
在使用XGBoost的train函数时,Booster对象不包含evals_result_属性,导致无法直接绘制学习曲线。本文介绍一种通过subprocess捕获Python脚本标准输出,并解析命令行打印的迭代指标(如train-auc),将其转换为DataFrame以手动构建学习曲线的方法。
XGBoost训练结果提取问题
在研究XGBoost模型时,通常需要绘制学习曲线以评估模型性能,但发现Booster对象中不存在evals_result_属性。
报错信息为:AttributeError: 'Booster' object has no attribute 'evals_result_'
这是因为未使用分类器或回归器的封装接口,而是直接调用train方法进行训练。查阅源码可知,只有fit方法会生成evals_result_属性。由于直接调用train导致该属性缺失,若需获取学习曲线,必须通过其他途径提取训练过程中的数据。
观察运行结果发现,屏幕输出中包含了迭代过程的具体数据。因此,尝试直接捕获并解析屏幕输出的数据。虽然这种方法较为直接,但实现简单有效。
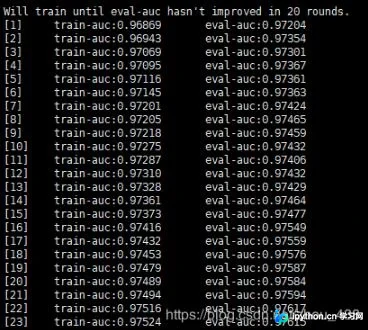
通过命令行输出构建学习曲线
具体实施分为以下两个步骤:
第一步:捕获屏幕输出数据。
捕获标准输出
import subprocess
import pandas as pd
top_info = subprocess.Popen(["python", "main.py"], stdout=subprocess.PIPE)
out, err = top_info.communicate()
out_info = out.decode('unicode-escape')
lines=out_info.split('\n')
注意:此处假设执行的Python脚本文件名为main.py。
第二步:解析捕获的文件数据。
解析迭代指标数据
ln=0
lst=dict()
for line in lines:
 if line.strip().startswith('[{}] train-auc:'.format(ln)):
 if ln not in lst.keys():
  lst.setdefault(ln, {})
 tmp = line.split('\t')
 t1=tmp[1].split(':')
 t2=tmp[2].split(':')
 if str(t1[0]) not in lst[ln].keys():
  lst[ln].setdefault(str(t1[0]), 0)
 if str(t2[0]) not in lst[ln].keys():
  lst[ln].setdefault(str(t2[0]), 0)
 lst[ln][str(t1[0])]=t1[1]
 lst[ln][str(t2[0])]=t2[1]
 ln+=1
json_df=pd.DataFrame(pd.DataFrame(lst).values.T, index=pd.DataFrame(lst).columns, columns=pd.DataFrame(lst).index).reset_index()
json_df.columns=['numIter','eval-auc','train-auc']
print(json_df)
完整代码如下:
完整实现代码
import subprocess
import pandas as pd
top_info = subprocess.Popen(["python", "main.py"], stdout=subprocess.PIPE)
out, err = top_info.communicate()
out_info = out.decode('unicode-escape')
lines=out_info.split('\n')

ln=0
lst=dict()
for line in lines:
    if line.strip().startswith('[{}]    train-auc:'.format(ln)):
        if ln not in lst.keys():
            lst.setdefault(ln, {})
        tmp = line.split('\t')
        t1=tmp[1].split(':')
        t2=tmp[2].split(':')
        if str(t1[0]) not in lst[ln].keys():
            lst[ln].setdefault(str(t1[0]), 0)
        if str(t2[0]) not in lst[ln].keys():
            lst[ln].setdefault(str(t2[0]), 0)
        lst[ln][str(t1[0])]=t1[1]
        lst[ln][str(t2[0])]=t2[1]
        ln+=1
json_df=pd.DataFrame(pd.DataFrame(lst).values.T, index=pd.DataFrame(lst).columns, columns=pd.DataFrame(lst).index).reset_index()
json_df.columns=['numIter','eval-auc','train-auc']
print(json_df)
运行效果如下所示:
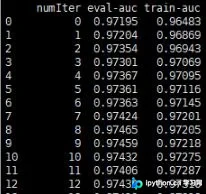
以上关于获取Python运行输出数据并解析存储为DataFrame的实例分享完毕,希望能为遇到类似问题的开发者提供参考,欢迎支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















