


Python 抓取知乎指定回答下视频的方法

本文介绍如何利用 Python 抓取知乎指定回答下的视频。通过浏览器开发者工具分析网络请求,定位视频播放接口,解析包含普清、标清及高清链接的 JSON 数据,并编写完整代码实现自动下载功能。
前言与背景
前言
目前知乎平台已支持上传视频内容,但官方并未提供直接的下载功能,这给希望保存视频的用户带来了不便。为此,我们深入研究其机制并编写了相关代码,以便能够方便地下载并保存视频文件。
接下来,我们将以回答“猫为什么一点也不怕蛇?”为例,详细分享整个视频下载的操作过程。
视频链接调试与解析
调试过程
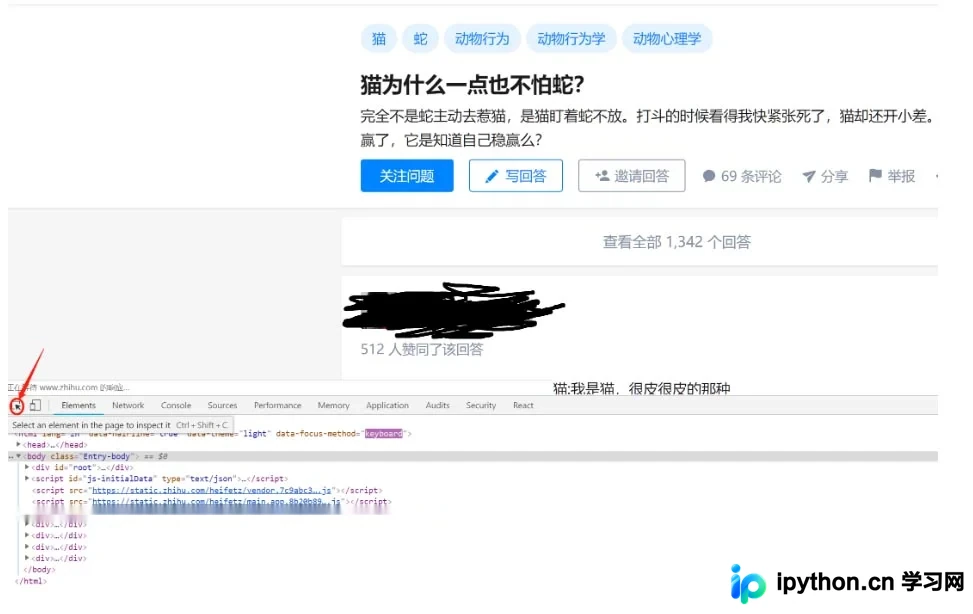
首先打开浏览器开发者工具(F12),找到网络请求面板,并将光标定位到视频播放区域,具体操作如下图所示:
随后将鼠标光标悬停在视频画面上,观察网络请求的变化,如下图所示:
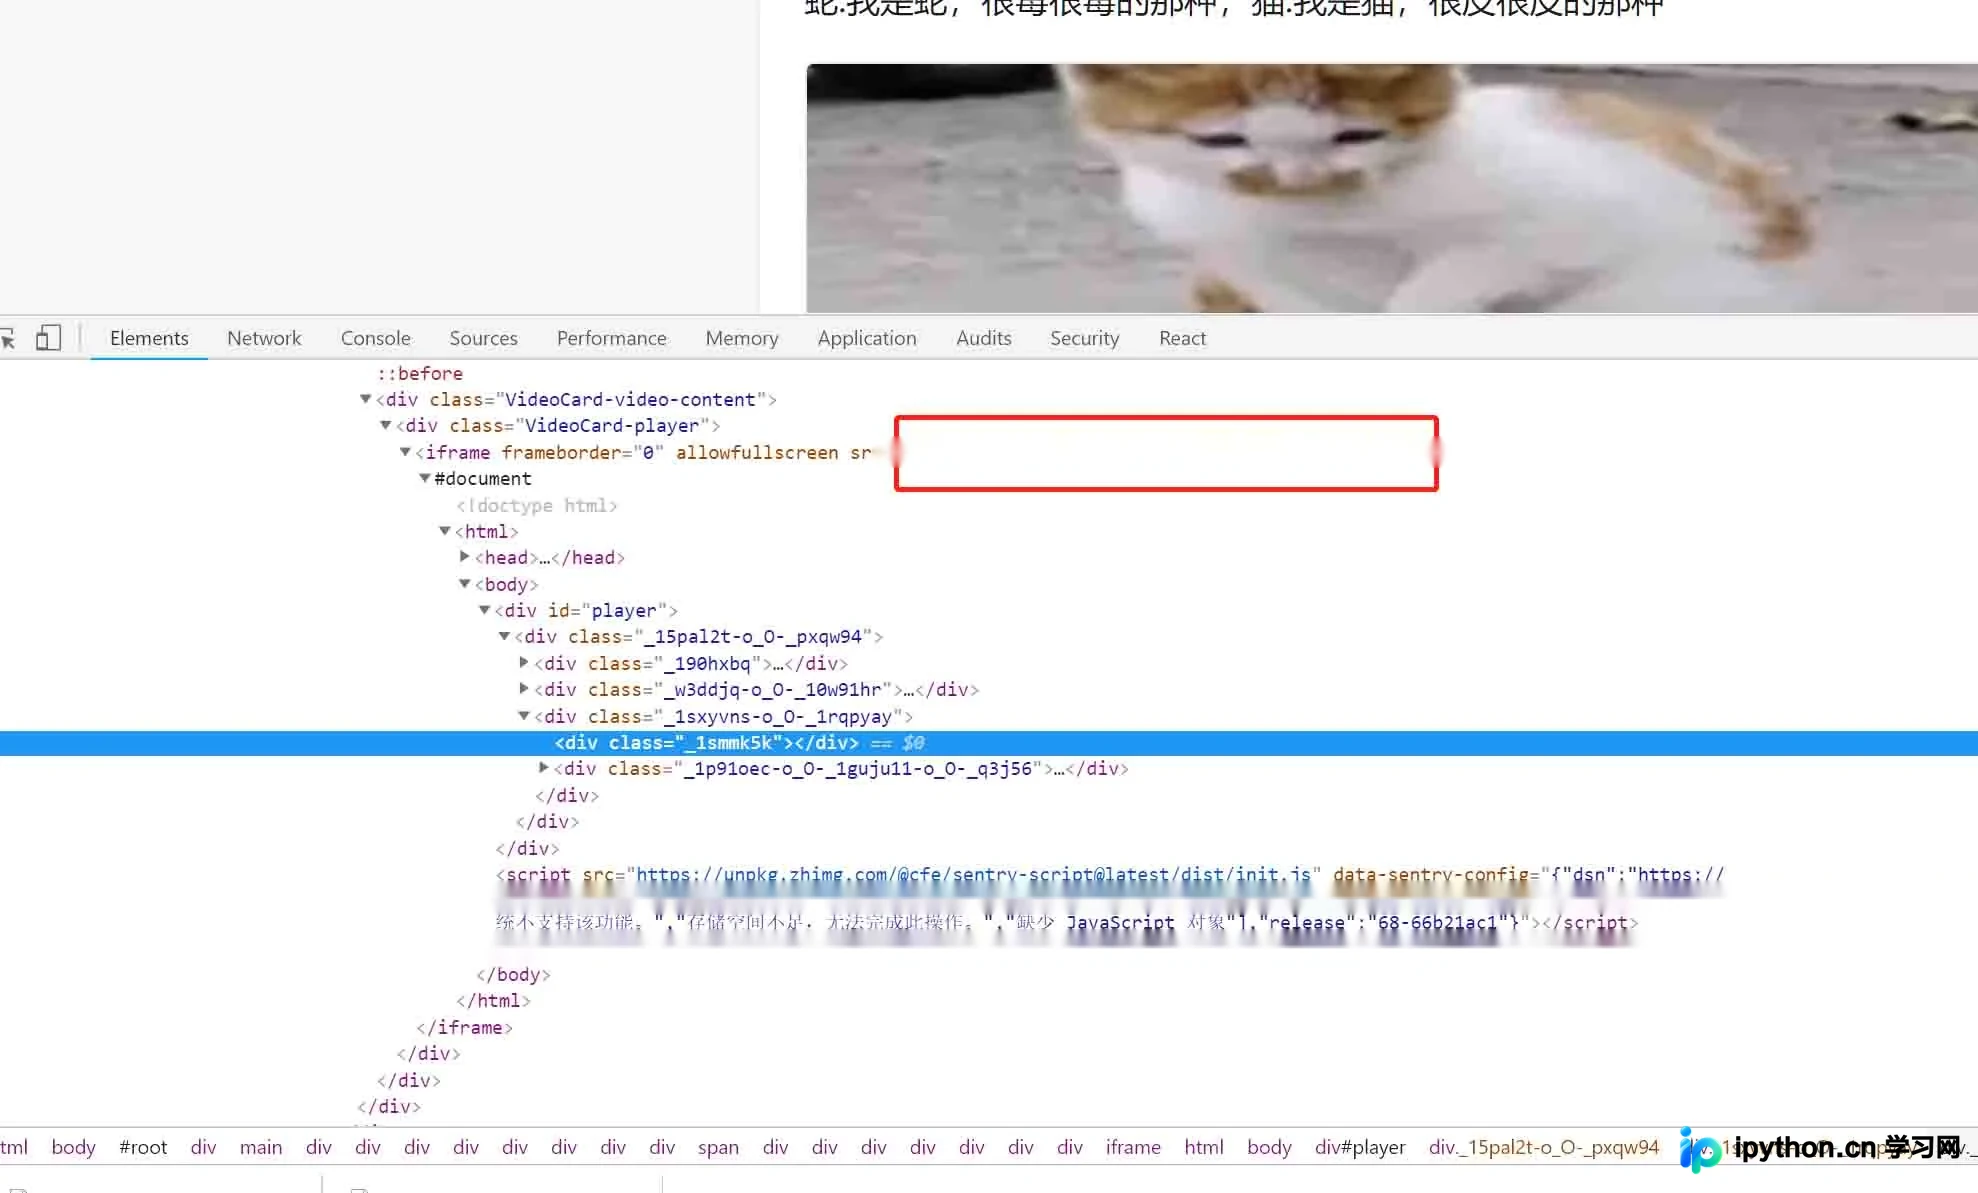
此时,在开发者工具中会出现一条包含视频 ID 的链接,格式类似 https://www.zhihu.com/video/xxxxx。我们将此链接复制到浏览器地址栏中打开,查看效果:
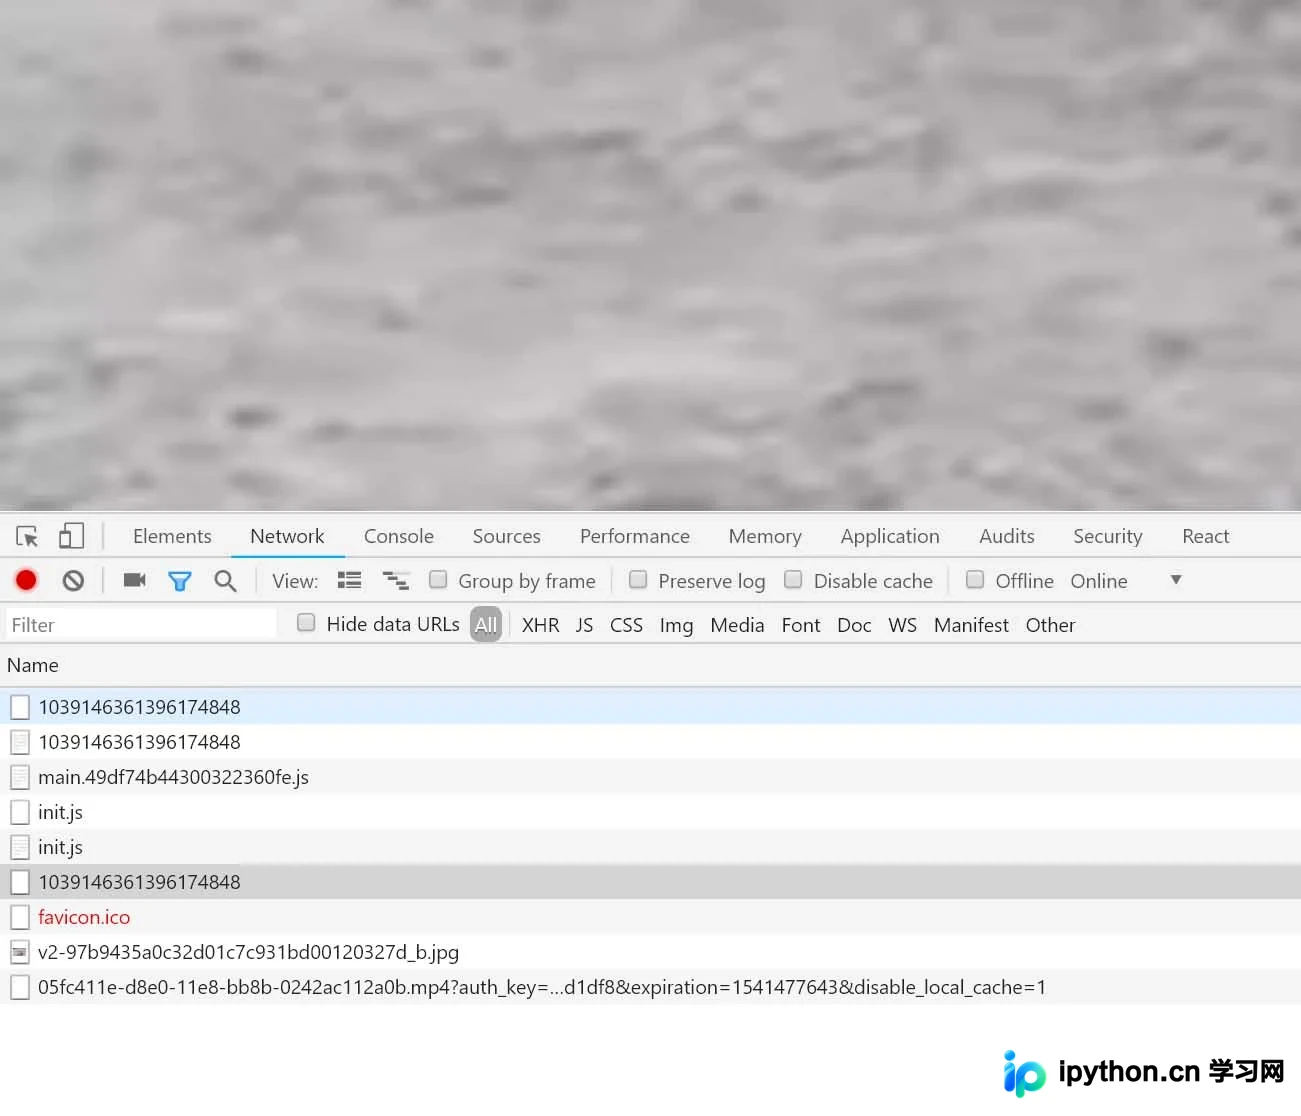
页面加载出的内容确实是我们需要下载的视频。为了获取视频源地址,我们需要进一步查看网页发出的具体请求,这里有一个关键的请求需要注意(重点):
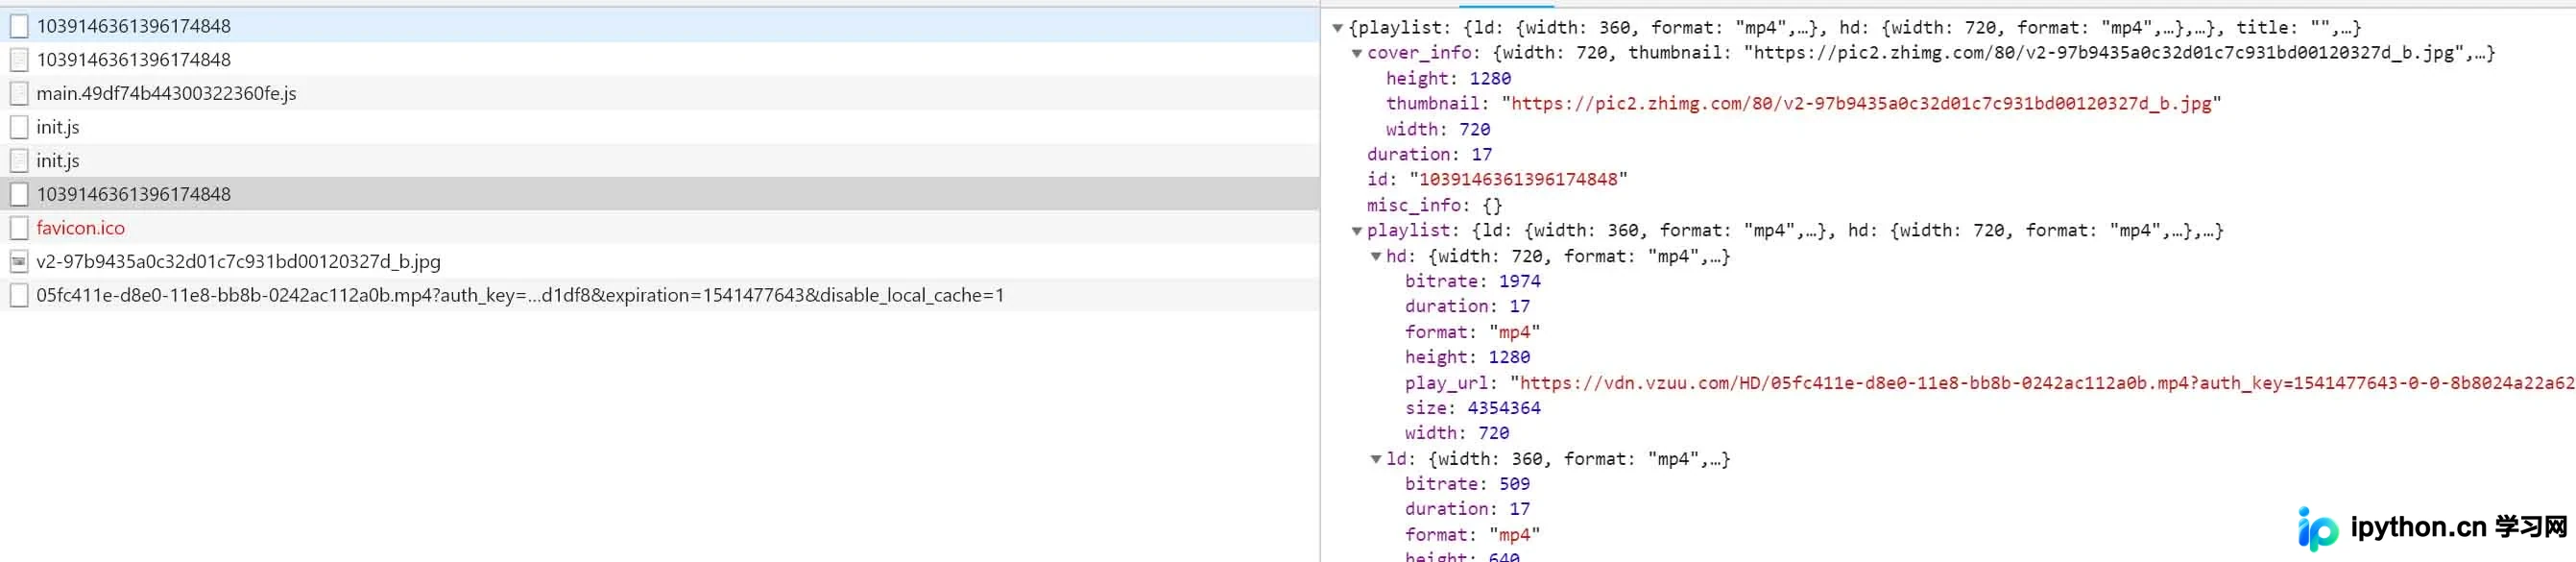
让我们直接查看该请求返回的数据结构:
{
	"playlist": {
		"ld": {
			"width": 360,
			"format": "mp4",
			"play_url": "https://vdn.vzuu.com/LD/05fc411e-d8e0-11e8-bb8b-0242ac112a0b.mp4?auth_key=1541477643-0-0-987c2c504d14ab1165ce2ed47759d927&expiration=1541477643&disable_local_cache=1",
			"duration": 17,
			"size": 1123111,
			"bitrate": 509,
			"height": 640
		},
		"hd": {
			"width": 720,
			"format": "mp4",
			"play_url": "https://vdn.vzuu.com/HD/05fc411e-d8e0-11e8-bb8b-0242ac112a0b.mp4?auth_key=1541477643-0-0-8b8024a22a62f097ca31b8b06b7233a1&expiration=1541477643&disable_local_cache=1",
			"duration": 17,
			"size": 4354364,
			"bitrate": 1974,
			"height": 1280
		},
		"sd": {
			"width": 480,
			"format": "mp4",
			"play_url": "https://vdn.vzuu.com/SD/05fc411e-d8e0-11e8-bb8b-0242ac112a0b.mp4?auth_key=1541477643-0-0-5948c2562d817218c9a9fc41abad1df8&expiration=1541477643&disable_local_cache=1",
			"duration": 17,
			"size": 1920976,
			"bitrate": 871,
			"height": 848
		}
	},
	"title": "",
	"duration": 17,
	"cover_info": {
		"width": 720,
		"thumbnail": "https://pic2.zhimg.com/80/v2-97b9435a0c32d01c7c931bd00120327d_b.jpg",
		"height": 1280
	},
	"type": "video",
	"id": "1039146361396174848",
	"misc_info": {}
}
确认无误,我们要下载的视频源地址就包含在返回的数据中。其中,ld 代表普清(低清),sd 代表标清,hd 代表高清。获取到对应的链接后,再次在浏览器中打开该链接,右键点击“视频另存为”即可下载视频文件。
Python 代码实现
代码实现
了解了整个数据流程后,编写 Python 代码就变得相对简单。此处不再赘述详细解释,直接展示完整代码:
# -*- encoding: utf-8 -*-

import re
import requests
import uuid
import datetime


class DownloadVideo:

  __slots__ = [
    'url', 'video_name', 'url_format', 'download_url', 'video_number',
    'video_api', 'clarity_list', 'clarity'
  ]

  def __init__(self, url, clarity='ld', video_name=None):
    self.url = url
    self.video_name = video_name
    self.url_format = "https://www.zhihu.com/question/\d+/answer/\d+"
    self.clarity = clarity
    self.clarity_list = ['ld', 'sd', 'hd']
    self.video_api = 'https://lens.zhihu.com/api/videos'

  def check_url_format(self):
    pattern = re.compile(self.url_format)
    matches = re.match(pattern, self.url)
    if matches is None:
      raise ValueError(
        "链接格式应符合:https://www.zhihu.com/question/{number}/answer/{number}"
      )
    return True

  def get_video_number(self):
    try:
      headers = {
        'User-Agent':
        'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_12_6) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/66.0.3359.181 Safari/537.36'
      }
      response = requests.get(self.url, headers=headers)
      response.encoding = 'utf-8'
      html = response.text
      video_ids = re.findall(r'data-lens-id="(\d+)"', html)
      if video_ids:
        video_id_list = list(set([video_id for video_id in video_ids]))
        self.video_number = video_id_list[0]
        return self
      raise ValueError("获取视频编号异常:{}".format(self.url))
    except Exception as e:
      raise Exception(e)

  def get_video_url_by_number(self):
    url = "{}/{}".format(self.video_api, self.video_number)

    headers = {}
    headers['Referer'] = 'https://v.vzuu.com/video/{}'.format(
      self.video_number)
    headers['Origin'] = 'https://v.vzuu.com'
    headers[
      'User-Agent'] = 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/70.0.3538.67 Safari/537.36'
    headers['Content-Type'] = 'application/json'

    try:
      response = requests.get(url, headers=headers)
      response_dict = response.json()
      if self.clarity in response_dict['playlist']:
        self.download_url = response_dict['playlist'][
          self.clarity]['play_url']
      else:
        for clarity in self.clarity_list:
          if clarity in response_dict['playlist']:
            self.download_url = response_dict['playlist'][
              self.clarity]['play_url']
            break
      return self
    except Exception as e:
      raise Exception(e)

  def get_video_by_video_url(self):
    response = requests.get(self.download_url)
    datetime_str = datetime.datetime.now().strftime("%Y-%m-%d %H-%M-%S")
    if self.video_name is not None:
      video_name = "{}-{}.mp4".format(self.video_name, datetime_str)
    else:
      video_name = "{}-{}.mp4".format(str(uuid.uuid1()), datetime_str)
    path = "{}".format(video_name)
    with open(path, 'wb') as f:
      f.write(response.content)

  def download_video(self):

    if self.clarity not in self.clarity_list:
      raise ValueError("清晰度参数异常,仅支持:ld(普清),sd(标清),hd(高清)")

    if self.check_url_format():
      return self.get_video_number().get_video_url_by_number().get_video_by_video_url()


if __name__ == '__main__':
  a = DownloadVideo('https://www.zhihu.com/question/53031925/answer/524158069')
  print(a.download_video())
总结与展望
结语
该代码仍有优化空间,目前仅实现了下载回答中的第一个视频。理论上,一个回答下可能包含多个视频,后续可进一步扩展以支持批量下载。如果有任何疑问或建议,欢迎交流讨论。
以上就是 Python 抓取知乎指定回答下视频的方法的详细内容,更多关于 Python 抓取视频的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















