


Python使用xlrd读取Excel合并单元格的正确姿势与避坑指南

本文详解Python中利用xlrd库读取Excel合并单元格的两种方法:直接获取merged_cells属性与循环赋值法。重点解决merged_cells二次调用返回空列表及多值返回问题,指出需在open_workbook时设置formatting_info=True。
Excel合并单元格读取概述
在Excel数据处理中,合并单元格是常见格式,但在Python中读取时容易遇到获取困难或数据丢失的问题。
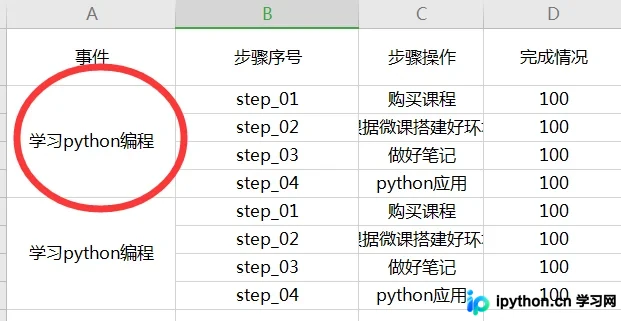
两种核心读取方法
针对合并单元格的读取,主要涉及两种操作思路:利用库自带属性或手动遍历判断。
第一种方法是直接调用xlrd库提供的merged_cells属性,该属性会返回一个包含所有合并单元格位置信息的列表。
代码示例展示了如何获取合并单元格的范围,格式为(起始行, 结束行, 起始列, 结束列),例如返回结果[(1,5,0,1),(5,9,0,1)]表示两个合并区域。
第二种方法是通过循环遍历merged_cells列表,判断当前行列是否落在合并区域内。若在,则提取该合并区域首单元格的值赋给当前单元格;若不在,则按普通单元格处理。
def get_cell_type(row_index, col_index):
  """既能得到合并单元格也能得到普通单元格"""
  cell_value = None
  for (rlow, rhigh, clow, chigh) in merged: # 遍历表格中所有合并单元格位置信息
    # print(rlow,rhigh,clow,chigh)
    if (row_index >= rlow and row_index < rhigh): # 行坐标判断
      if (col_index >= clow and col_index < chigh): # 列坐标判断
        # 如果满足条件,就把合并单元格第一个位置的值赋给其它合并单元格
        cell_value = sheet.cell_value(rlow, clow)
        print('合并单元格')
        break # 不符合条件跳出循环,防止覆盖
      else:
        print('普通单元格')
        cell_value = sheet.cell_value(row_index, col_index)

    # else: 添加改行后只那一个单元格的内容5,0 会返回2个值普通单元格/合并单元格
    #   print('普通单元格')
    #   cell_value = sheet.cell_value(row_index, col_index)

  return cell_value
# 直接输入单元格的坐标。来获取单元格内容
# print(get_cell_type(5, 0))

# 利用循环输出某列的单元格内容
for i in range(1, 9):
  print(get_cell_type(i, 2))
上述方法实现了最基础的Excel合并单元格读取逻辑,适用于大多数常规场景。
常见问题与解决方案
在实际应用中,开发者常遇到两个典型问题:一是坐标输出时因逻辑分支导致返回多个值;二是merged_cells属性在后续调用中返回空列表。
问题一表现为:当使用坐标打印内容时,若外层包含else分支,可能会同时打印“普通单元格”和“合并单元格”两个结果,需确认无else分支时的具体行为。
问题二表现为:初次调用sheet.merged_cells能正常返回列表,但再次调用时却返回空列表,导致后续逻辑失效。
解决上述问题的关键是在打开Excel文件时,务必在open_workbook函数中传入参数formatting_info=True,这样xlrd才能正确加载并保留合并单元格信息。
掌握这些细节有助于更稳定地使用Python处理Excel文件,希望本文内容能帮助大家避开常见陷阱。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















