


Python调用百度OCR实现图片文字识别的示例代码

发布时间:2026-10-14 |
2人浏览过
本文介绍如何利用Python调用百度AI开放平台提供的OCR接口,实现图片文字识别功能。百度AI提供每日50000次免费额度。文章详细演示了从创建应用获取密钥、安装baidu-aip库,到编写Python代码调用通用文字识别接口的完整流程,并对比了与pytesseract的效果。
百度OCR免费额度与准备工作
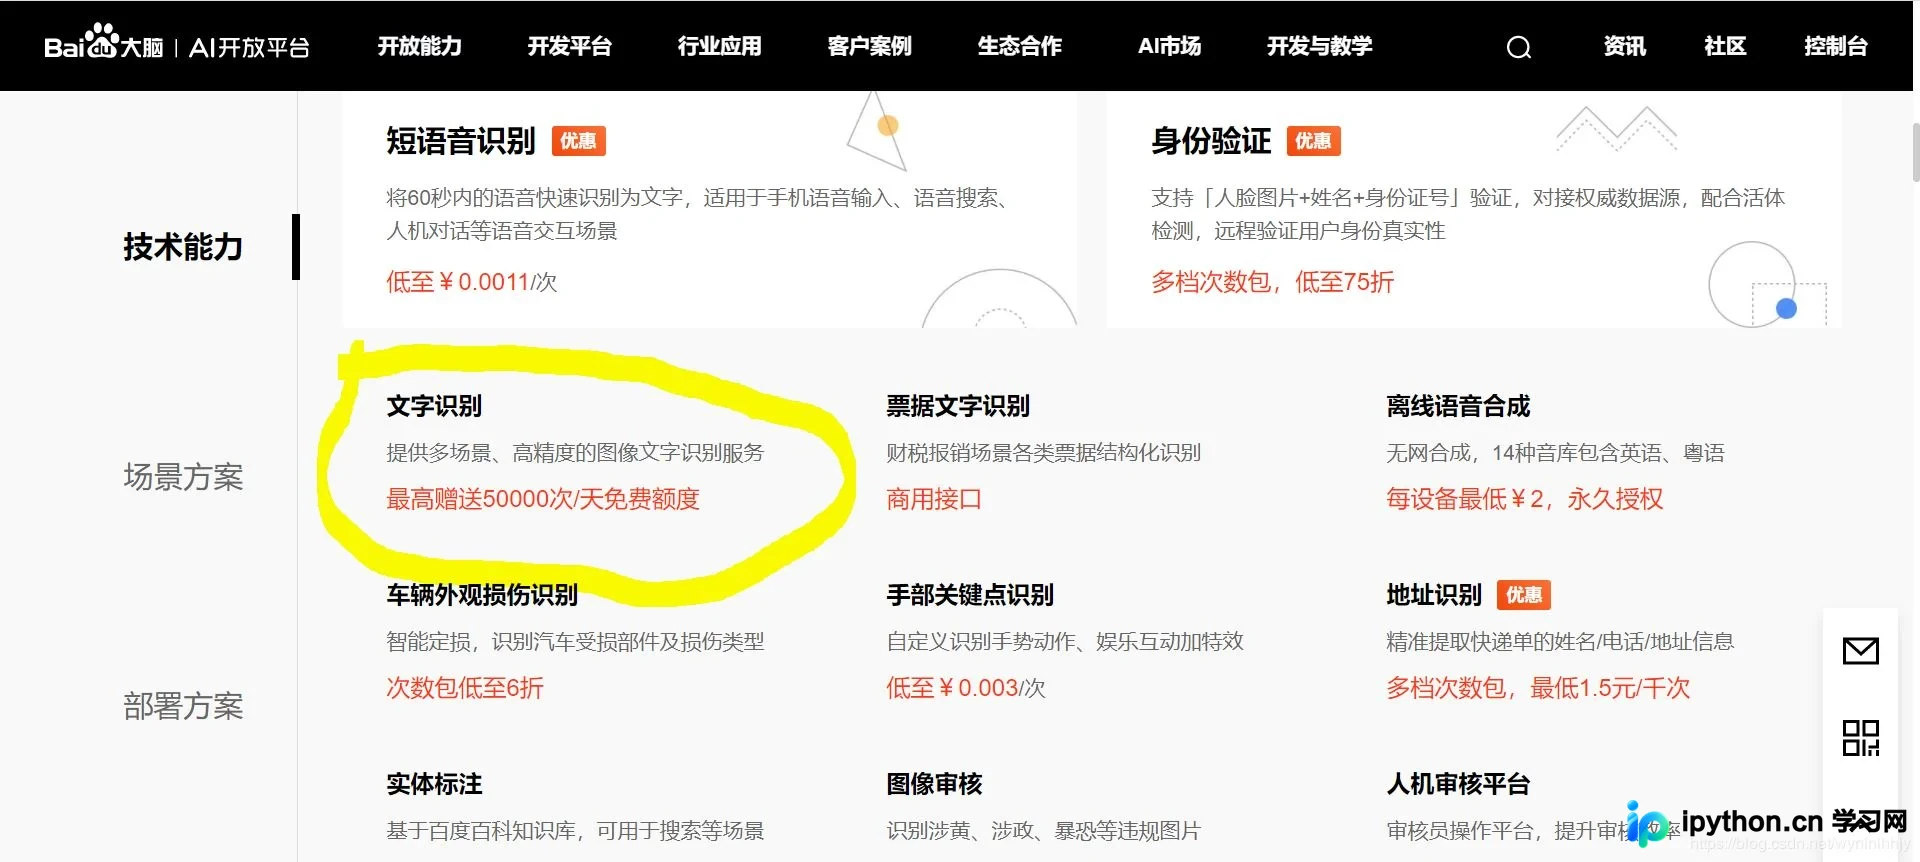
百度AI开放平台为开发者提供了每日50000次的免费文字识别调用额度,这足以满足大多数个人开发者和小型项目的测试与使用需求。接下来将直接介绍具体的实现步骤。
首先需要在百度AI开放平台注册并创建一个应用程序。按照平台指引完成应用创建流程后,系统将生成用于接口调用的必要凭证信息。
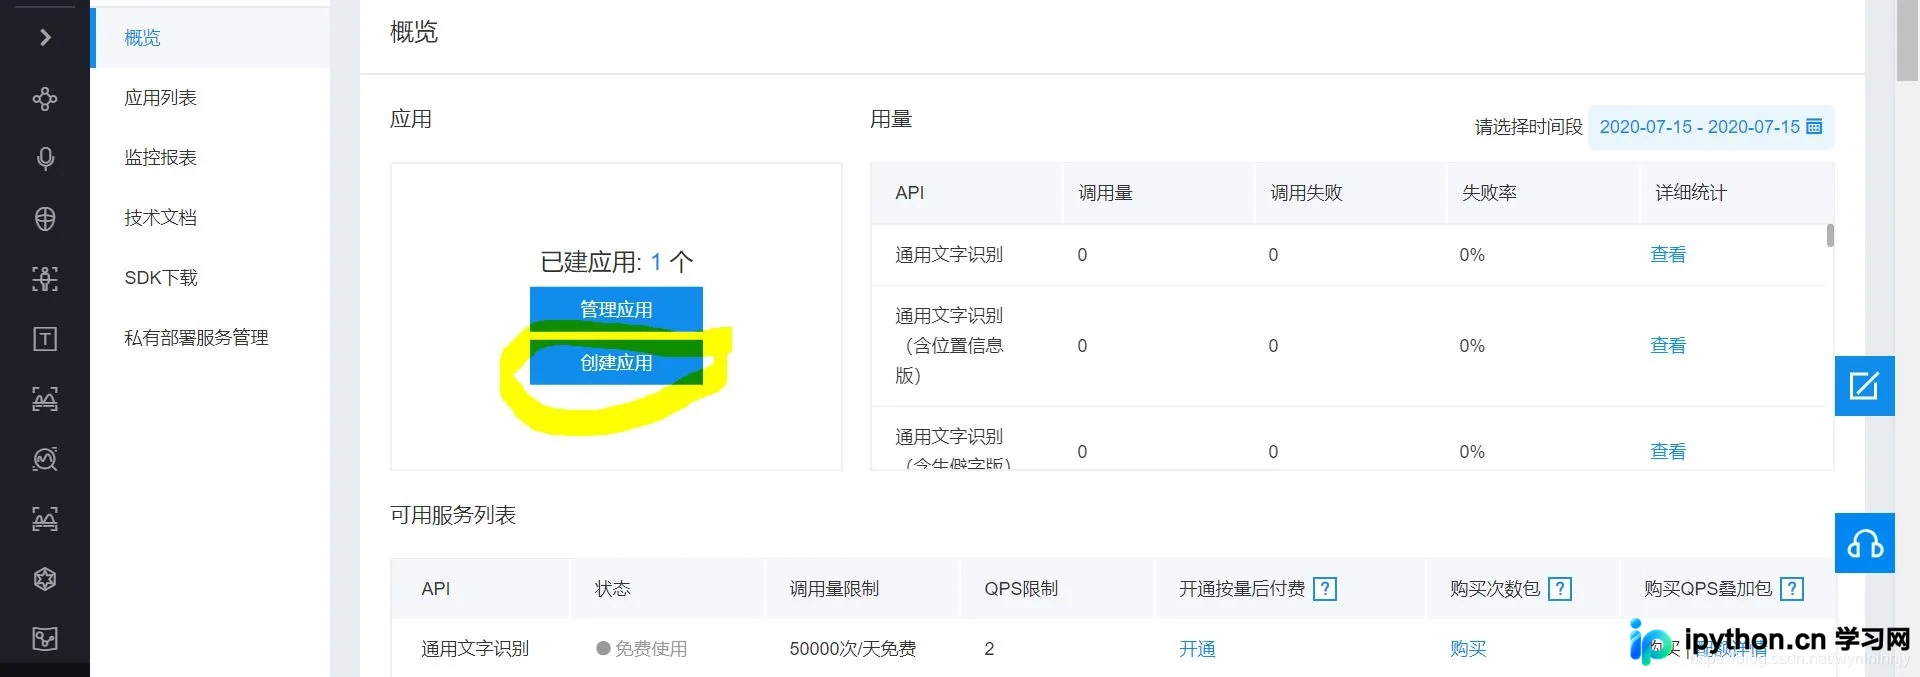
应用创建成功后,控制台会展示以下关键配置信息:
APP_ID = '******'
API_KEY = '************'
SECRET_KEY = '**************'
安装百度AI Python SDK
随后需要安装百度AI的Python SDK包。请在终端或命令行环境中执行以下pip安装命令,请注意库名称为 baidu-aip:
pip install --user baidu-aip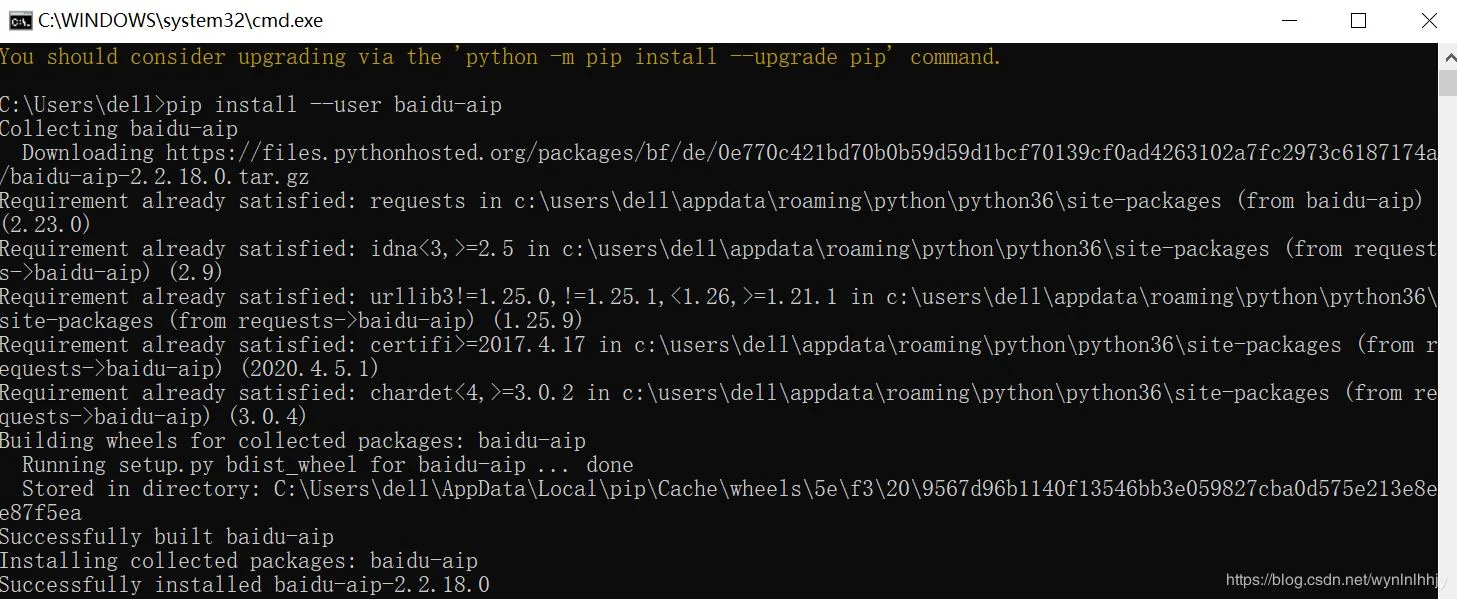
Python代码实现与结果分析
以下是具体的Python实现代码。用户只需将代码中的图片路径替换为实际待识别的图片文件路径,即可直接运行程序:
from aip import AipOcr

# 定义常量
APP_ID = '21372704'
API_KEY = 'YKpXQwN5zj79g99fZK8i4Kn1'
SECRET_KEY = 'RTIAaFrvvgHbej7eALMKmjR0uF93rHCQ'

# 初始化AipFace对象
aipOcr = AipOcr(APP_ID, API_KEY, SECRET_KEY)

# 读取图片
filePath = "test.JPG"

def get_file_content(filePath):
  with open(filePath, 'rb') as fp:
    return fp.read()

# 定义参数变量
options = {
  'detect_direction': 'true',
  'language_type': 'CHN_ENG',
}

# 调用通用文字识别接口
result = aipOcr.basicGeneral(get_file_content(filePath), options)
print(result)
words_result=result['words_result']
for i in range(len(words_result)):
  print(words_result[i]['words'])

#代码参考了:https://blog.csdn.net/u013421629/article/details/79500336
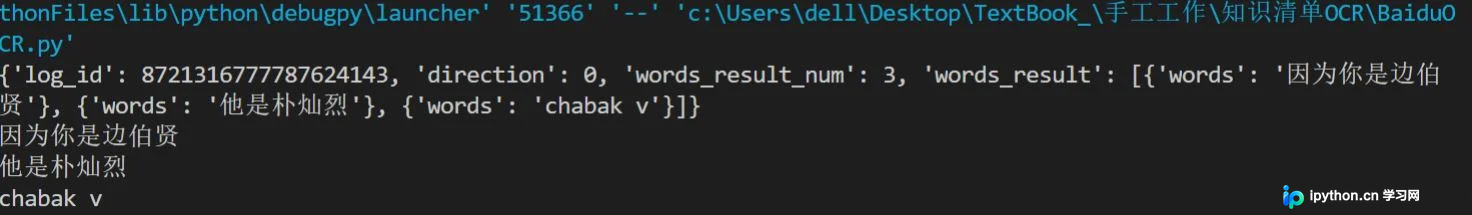
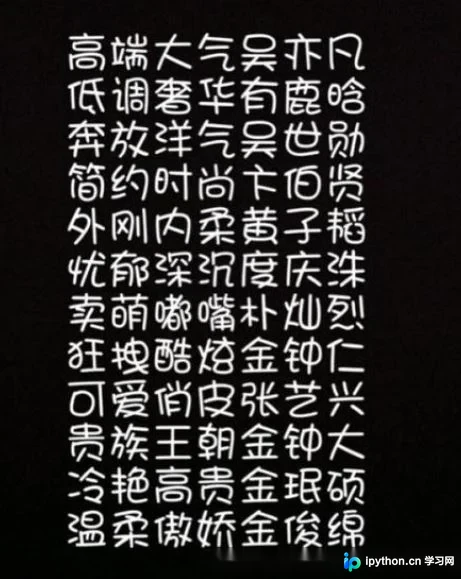
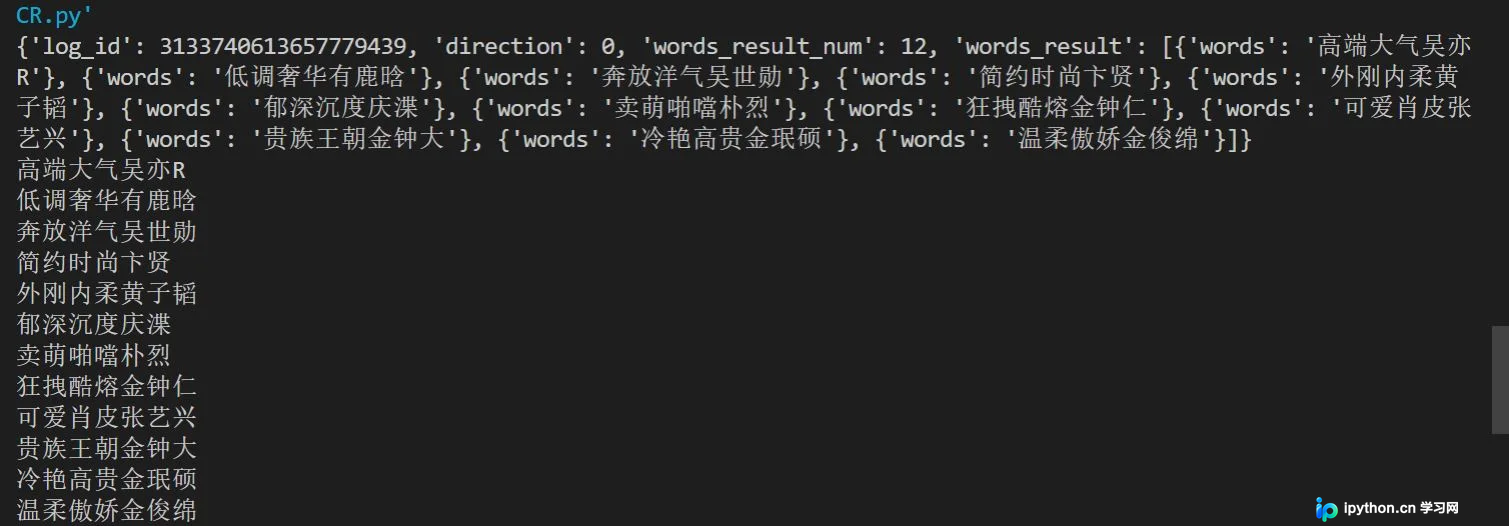
需要注意的是,如果输入图片清晰度不足,识别结果的准确性可能会受到影响。不过,与pytesseract库的OCR识别效果相比,百度OCR的表现已经显著提升。百度OCR接口返回的数据格式为字典结构。以下是一个具体的调用示例:
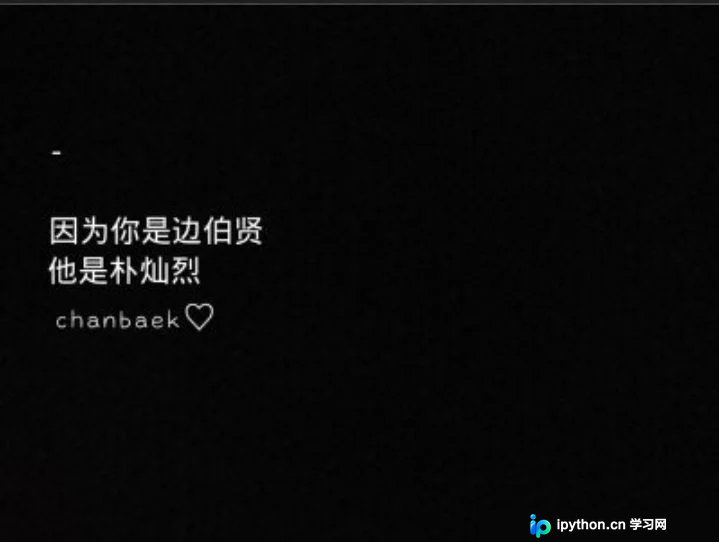
至此,关于使用Python调用百度OCR接口进行图片文字识别的示例代码介绍完毕。如需了解更多关于Python图片文字识别的相关内容,建议搜索本站历史文章或继续阅读后续系列教程,感谢大家的支持!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















