


Python爬虫实现GitHub模拟登录并提取数据

本文详解如何使用Python爬虫实现GitHub网页的模拟登录。通过浏览器开发者工具分析登录请求,提取Form Data中的动态参数authenticity_token、login及password,利用requests.Session保持会话状态,发送POST请求完成登录,并成功提取登录后的页面信息如注册号码。
实例描述
1. 实例描述
在使用爬虫技术抓取网页内容时,部分数据需要用户登录后方可查看。以获取 GitHub 平台上的注册号码为例,必须先完成账号登录才能在登录后页面中看到该信息,具体界面如下图所示。本文将演示如何通过爬虫技术实现 GitHub 网页的模拟登录功能。
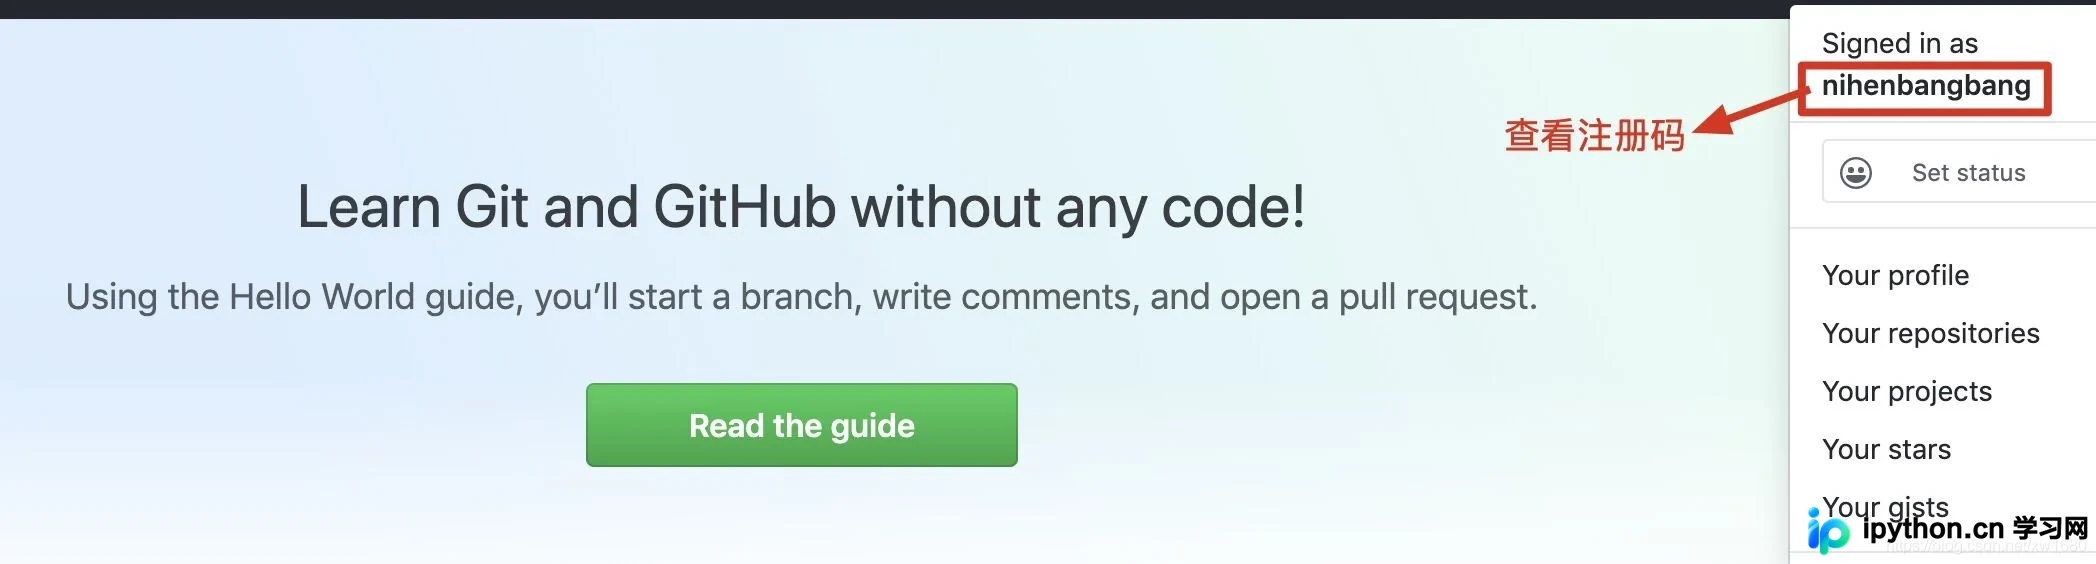
代码实现
2. 代码实现
分析登录请求参数
实现 GitHub 网页模拟登录的核心在于分析登录请求所需的参数。具体流程包括:查看提交登录请求时涉及的参数,获取所有必要的登录参数,发送登录请求,并在登录成功后提取页面中的注册号码信息。具体操作步骤如下:
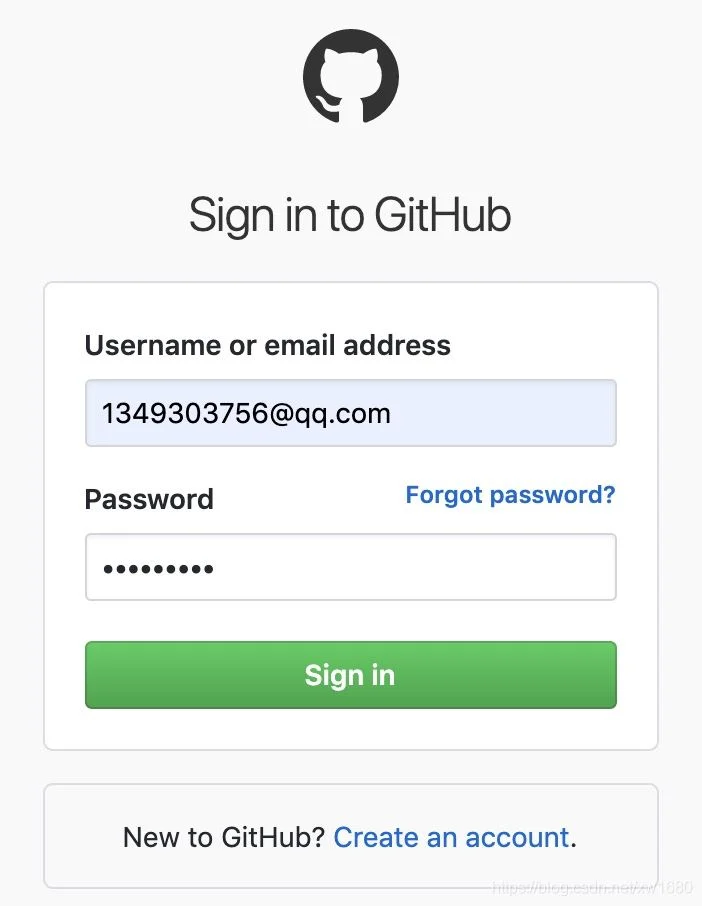
(1) 点击 此处 访问 GitHub 的登录页面,输入账号与密码,界面如下图所示。
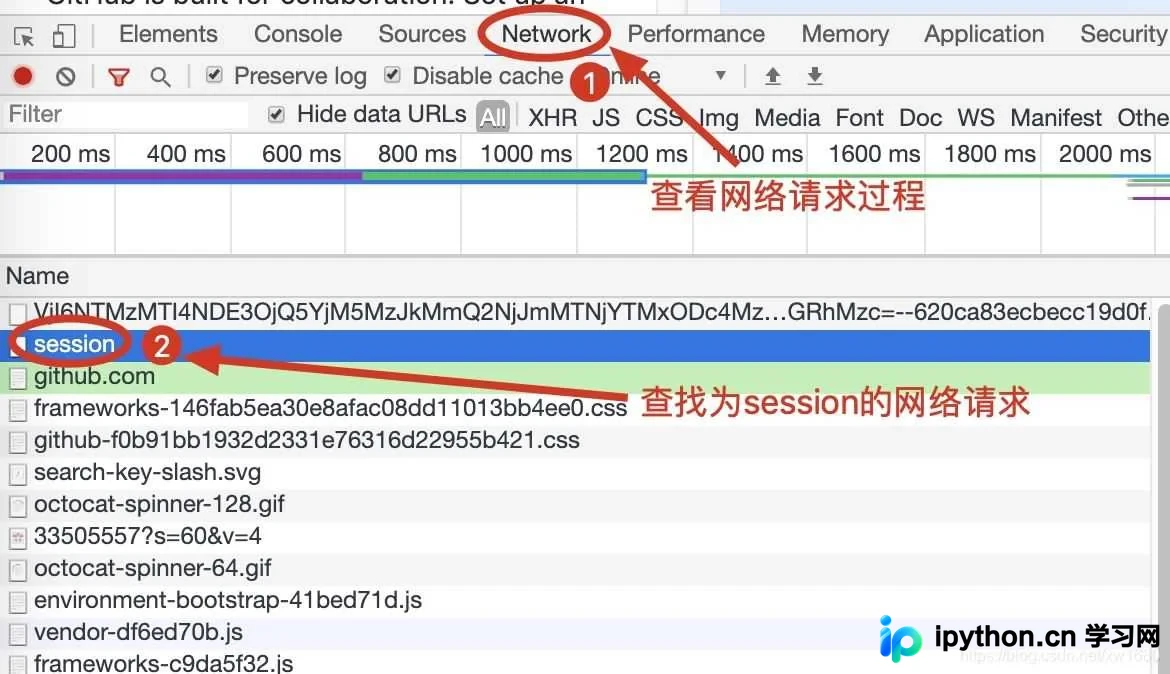
(2) 按下 F12 键或鼠标右键单击网页选择 检查 以打开浏览器开发者工具,切换到网络请求(Network)标签页。随后点击登录页面中的 Sign in 按钮,此时开发者工具中将显示 GitHub 网页的登录请求过程,重点查找名称为 session 的网络请求,如下图所示。
(3) 点击名称为 session 的网络请求,在 Headers 请求信息面板中主要查看 Request Headers与 Form Data 中的各种信息,其中红框内标注的是重要参数与数据,如下图所示。
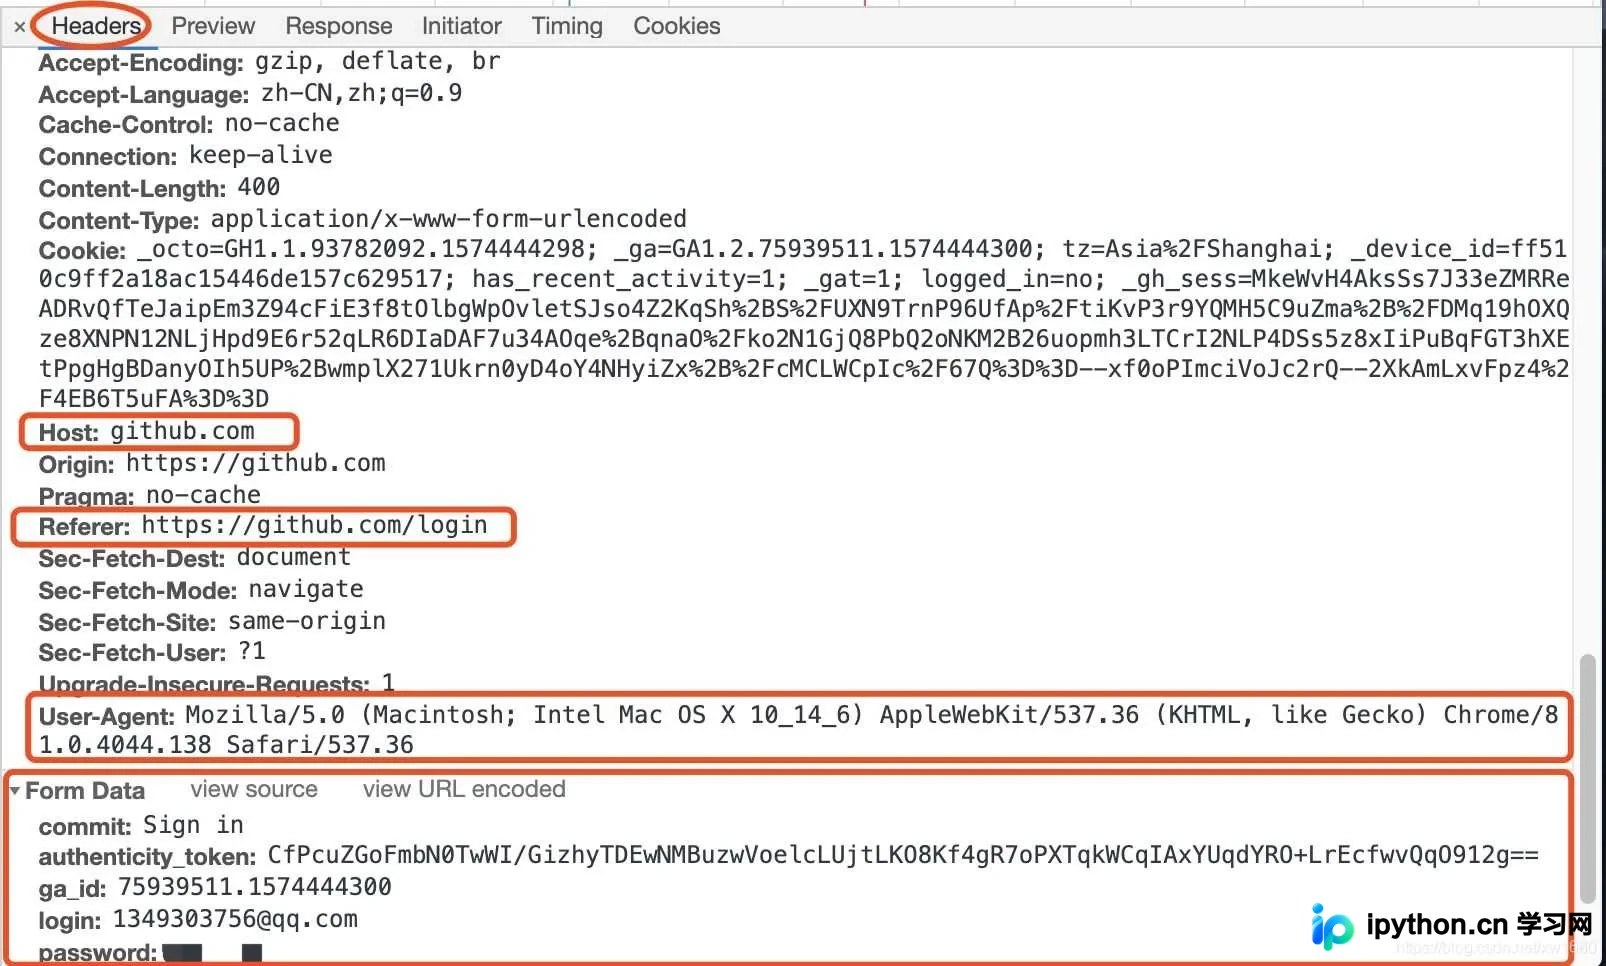
说明:Host 字段表示主页面地址,Referer 字段表示当前请求的来源地址。User-Agent 字段包含浏览器的头部信息。Form Data 中的所有信息均为登录请求所使用的参数,其中动态参数是关键部分。authenticity_token 为加密字符串,login 对应登录的账号,password 对应密码,其余参数为静态参数。由于动态参数仅包含 authenticity_token、login 以及password,且用户名与密码只需将动态字符串填入对应位置即可,因此接下来需要获取 authenticity_token 参数所对应的加密字符串。
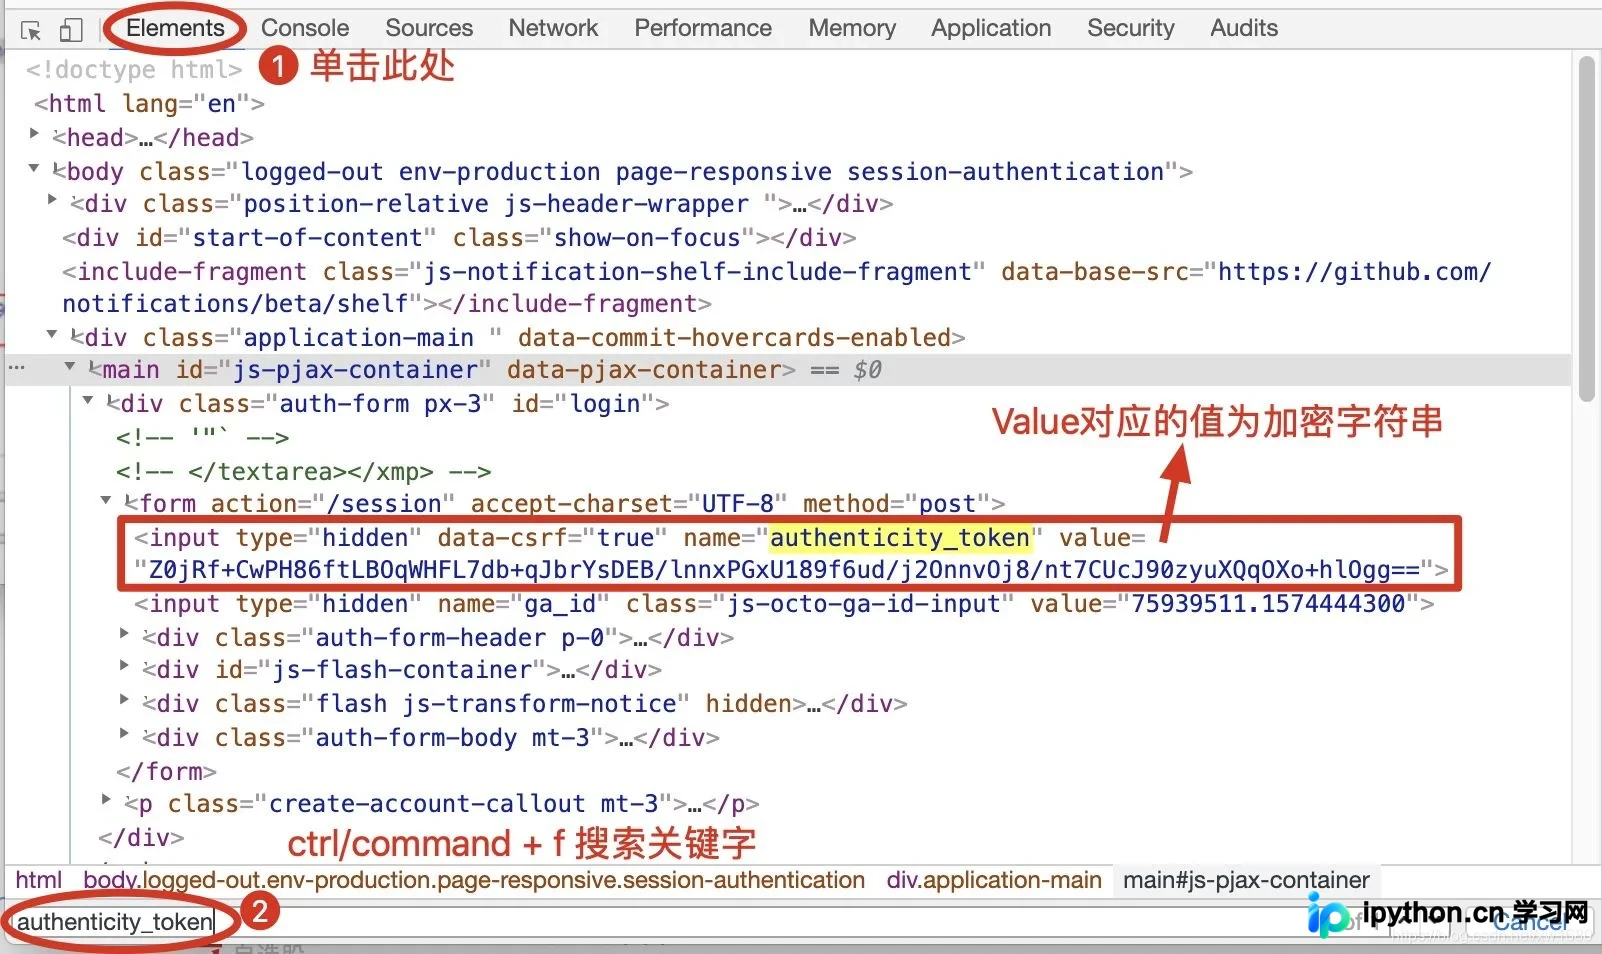
(4) 在浏览器中退出已登录的 GitHub 账号,返回 GitHub 的登录页面。打开浏览器开发者工具,查看网页的 html 代码,在代码中搜索 authenticity_token 关键词。标签内 value 所对应的值即为 authenticity_token 参数的加密字符串,如下图所示。
Python爬虫代码实现
(5) 编写爬虫代码,首先导入所需模块,构建头部信息,再通过 Session 会话对象发送网络请求以获取 authenticity_token 信息,最后利用所有登录请求参数实现 GitHub 网页的登录请求并提取注册号码。具体代码如下:
# -*- coding: utf-8 -*-
# @Time  : 2020/5/10 23:25
# @Author : 我就是任性-Amo
# @FileName: 77.通过爬虫实现GitHub网页的模拟登录.py
# @Software: PyCharm
# @Blog  :https://blog.csdn.net/xw1680

import requests # 导入网络请求模块
from lxml import etree # 导入数据解析模块 都是第三方模块需要安装
# pip install requests/lxml如果太慢 可以加上镜像服务器 或者在Pycharm中使用图形化界面进行安装


class GitHubLogin(object):
  def __init__(self, username, password):
    # 构造头部信息
    self.headers = {
      "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_6) "
             "AppleWebKit/537.36 (KHTML, like Gecko) Chrome/81.0.4044.138 Safari/537.36",
      "Host": "github.com",
      "Referer": "https://github.com/login"
    }
    self.login_url = "https://github.com/login" # 登录页面地址
    self.post_url = "https://github.com/session" # 实现登录的请求地址
    self.session = requests.Session() # 创建Session会话对象
    self.user_name = username # 用户名
    self.password = password # 密码

  # 获取authenticity_token信息
  def get_token(self):
    # 发送登录页面的网络请求
    response = self.session.get(self.login_url, headers=self.headers)
    if response.status_code == 200: # 判断请求是否成功
      html = etree.HTML(response.text) # 解析html
      # 提取authenticity_token信息
      token = html.xpath("//div[@id='login']/form/input[1]/@value")[0]
      # print(token) 测试是否能够获取到token
    return token # 返回信息

  # 实现登录
  def login(self):
    # 请求参数
    post_data = {
      "commit": "Sign in",
      "authenticity_token": self.get_token(),
      "login": self.user_name,
      "password": self.password,
      "webauthn - support": "supported"
    }
    # 发送登录请求
    response = self.session.post(self.post_url, headers=self.headers, data=post_data)
    if response.status_code == 200: # 判断请求是否成功
      html = etree.HTML(response.text) # 解析html
      # 获取注册号码
      register_number = html.xpath("//div[contains(@class,'Header-item')][last()]//strong")[0]
      print(f"注册号码为: {register_number.text}")
    else:
      print("登录失败")


if __name__ == '__main__':
  user_name = input("请输入您的用户名:") # 获取输入的用户名
  password = input("请输入您的密码:") # 获取输入的密码
  login = GitHubLogin(user_name, password) # 创建登录类对象并传递输入的用户名与密码
  login.login()
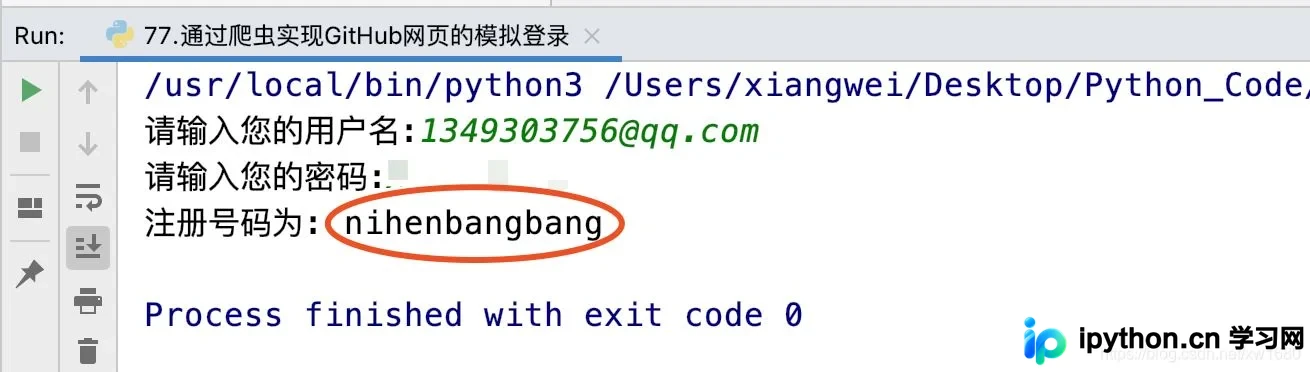
执行上述代码,输入用户名与密码后,即可显示获取的注册号码,运行结果如下图所示:
到此这篇关于Python 通过爬虫实现GitHub网页的模拟登录的示例代码的文章就介绍到这了,更多相关Python GitHub模拟登录内容请搜索本站以前的文章或继续浏览下面的相关文章希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















