


Python 常见排序算法实现与复杂度详解

本文汇总了 Python 中常见的八大排序算法,包括冒泡、选择、插入、希尔、快速、归并及堆排序。详细解析了各算法的核心思想、时间复杂度、空间复杂度及稳定性,并提供了完整的 Python 代码实现,重点涵盖时间复杂度为 O(nlogn) 的快速、归并和堆排序。
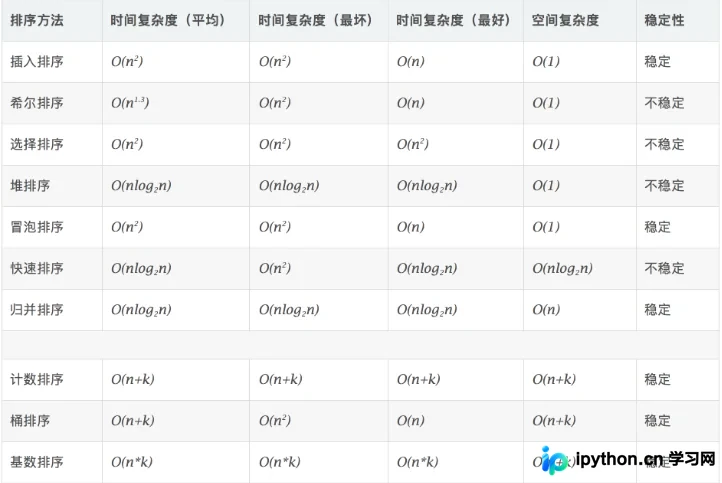
排序算法分类概述
排序算法主要分为比较类和非比较类两大阵营。比较类排序通过元素间的比较来确定相对顺序,其理论时间复杂度下界无法突破 O(nlogn);而非比较类排序则不受此限制,但通常仅适用于整型等特定数据类型,且往往需要额外的辅助空间。
O(nlogn) 核心算法要求
掌握时间复杂度为 O(nlogn) 的排序算法是核心要求,重点包括快速排序、归并排序以及堆排序。
基础排序算法:冒泡、选择与插入
1. 冒泡排序
核心思想:通过相邻元素的比较,将较大的元素逐步“下沉”至末尾,使得列表右侧逐渐有序。
时间复杂度为 O(n^2),属于原地排序算法,且具备稳定性。
def bubble_sort(li:list):
  for i in range(len(li)-1):
    for j in range(i + 1, len(li)):
      if li[i] > li[j]:
        li[i], li[j] = li[j], li[i]
2. 选择排序
核心思想:每次从未排序部分中选出最小元素,将其放置到已排序序列的末尾。具体而言,先找到最小元素置于起始位置,再从剩余元素中继续寻找最小值并放置于已排序序列末尾,重复此过程直至所有元素排序完毕,使得列表左侧逐渐有序。
时间复杂度为 O(n^2),属于原地排序算法,但不具备稳定性。
def select_sort(nums: list):
  for i in range(len(nums) - 1):
    min_index = i
    for j in range(i + 1, len(nums)):
      if nums[j] < nums[i]:
        min_index = j
    nums[i], nums[min_index] = nums[min_index], nums[i]
3. 插入排序
核心思想:构建有序序列,对于未排序数据,在已排序序列中从后向前扫描,找到合适位置并插入,使得列表左侧逐渐有序。
时间复杂度为 O(n^2),属于原地排序算法,且具备稳定性。
def insert_sort(nums: list):
  for i in range(len(nums)):
    current = nums[i]
    pre_index = i - 1
    while pre_index >= 0 and nums[pre_index] > current:
      nums[pre_index + 1] = nums[pre_index]
      pre_index -= 1
    nums[pre_index + 1] = current
希尔排序
4. 希尔排序
核心思想:作为插入排序的改进版,又称缩小增量排序。将待排序列表按一定增量分组,对每组进行直接插入排序,随着增量逐渐减小至 1,最终完成排序。
时间复杂度约为 O(n^{1.5}),属于原地排序算法,但不具备稳定性。
def shell_sort(nums: list):
  gap = len(nums) >> 1
  while gap > 0:
    for i in range(gap, len(nums)):
      current = nums[i]
      pre_index = i - gap
      while pre_index >= 0 and nums[pre_index] > current:
        nums[pre_index + gap] = nums[pre_index]
        pre_index -= gap
      nums[pre_index + gap] = current
    gap >>= 1
快速排序
5. 快速排序
核心思想:采用递归策略,选取列表中第一个元素作为基准(pivot),将小于基准的元素置于左侧,大于基准的元素置于右侧,递归处理直至排序完成。
时间复杂度为 O(nlogn),空间复杂度为 O(logn),但不具备稳定性。
def quick_sort(li:list):
  if li == []:
    return []
  first = li[0]
  # 推导式实现
  left = quick_sort([l for l in li[1:] if l < first])
  right = quick_sort([r for r in li[1:] if r >= first])
  return left + [first] + right
归并排序
6. 归并排序
核心思想:基于分治算法,将序列拆分为子序列并递归排序,最后将排序好的子序列合并为最终序列。合并的关键在于设置两个指针分别指向两个已排序序列的起始位置,比较指针所指元素,将较小者放入合并空间并移动指针,直至某一指针超出序列尾,将另一序列剩余元素直接复制到合并序列尾部。
时间复杂度为 O(nlogn),空间复杂度为 O(n),但不具备稳定性。
此处特指二路归并策略。
def merge_sort(nums: list):
  if len(nums) <= 1:
    return nums
  mid = len(nums) >> 1
  left = merge_sort(nums[:mid]) # 拆分子问题
  right = merge_sort(nums[mid:])

  def merge(left, right): # 如何归并
    res = []
    l, r = 0, 0
    while l < len(left) and r < len(right):
      if left[l] <= right[r]:
        res.append(left[l])
        l += 1
      else:
        res.append(right[r])
        r += 1
    res += left[l:]
    res += right[r:]
    return res

  return merge(left, right)
堆排序
7. 堆排序
核心思想:利用大顶堆(根节点最大,对应升序)或小顶堆(根节点最小,对应降序)进行排序。
- 首先构建大根堆,其结构为完全二叉树,初始状态无序。
- 接着进行最大堆调整以执行排序:将堆顶元素与最后一个元素交换,此时序列后半部分有序。
时间复杂度为 O(nlogn),属于原地排序算法,且具备稳定性。
def heap_sort(nums: list):
  def heapify(parent_index, length, nums):
    temp = nums[parent_index] # 根节点的值
    chile_index = 2 * parent_index + 1 # 左节点,再加一为右节点
    while chile_index < length:
      if chile_index + 1 < length and nums[chile_index + 1] > nums[chile_index]:
        chile_index = chile_index + 1
      if temp > nums[chile_index]:
        break
      nums[parent_index] = nums[chile_index] # 使得根节点最大
      parent_index = chile_index
      chile_index = 2 * parent_index + 1
    nums[parent_index] = temp

  for i in range((len(nums) - 2) >> 1, -1, -1):
    heapify(i, len(nums), nums) # 1.建立大根堆
  for j in range(len(nums) - 1, 0, -1):
    nums[j], nums[0] = nums[0], nums[j]
    heapify(0, j, nums) # 2.堆排序,为升序

if __name__ == '__main__':
  nums = [89, 3, 3, 2, 5, 45, 33, 67] # [2, 3, 3, 5, 33, 45, 67, 89]
  heap_sort(nums)
  print(nums)
以上即为 Python 常见排序算法的实现汇总,更多关于 Python 排序算法的资料请关注本站其它相关文章!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















