


Python使用Pandas筛选Excel特定行与列的实战指南

本文介绍如何利用Python的Pandas库高效筛选Excel数据。通过详解loc函数的标签索引与布尔数组用法,结合isin判断集合成员及str.contains匹配字符串,实现按条件或特定值提取行。同时演示如何选取特定列并保留DataFrame类型,帮助数据分析人员快速处理特征数据。
前言
Pandas loc函数基础与行筛选示例
在进行数据分析时,我们通常不会直接对整个Excel文件进行操作,而是将每一列视为一个特征进行针对性分析。面对此类需求,我们往往需要提取某一列中符合特定条件的所有数据,并将其整理为独立文件以便进一步分析。例如,我们需要找出某列中所有大于100的行,或者提取包含特定字母的行。本文将介绍实现这一目标的具体方法。
在此之前,我们先介绍Pandas库中的一个核心函数:loc()。
官方英文解释为:Purely label-location based indexer for selection by label.(纯基于标签位置的索引器,用于通过标签进行选择。)
.loc[] 主要基于标签进行索引,但也可以接受布尔数组作为参数。
通俗来说,它是一个标签索引器。
了解了该函数的具体用法(见下文两个示例),我们就可以轻松选择所需的行。
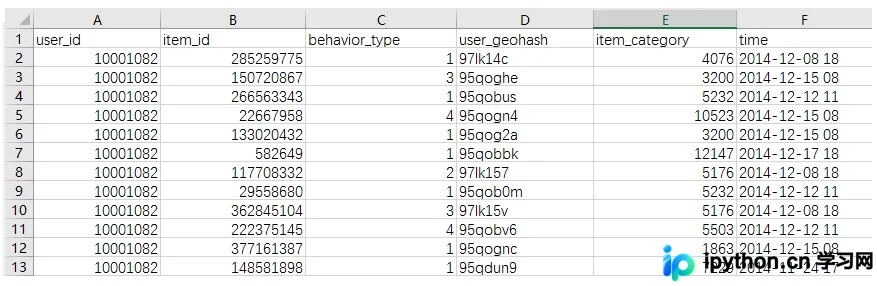
问题一:我们需要提取“behavior_type”列中值为3或4的所有行。
import pandas as pd
import numpy as np

import csv

for df in pd.read_csv(open(r'C:\Users\yang\Desktop\useer.csv','r'),chunksize=10000):
 print(df.loc[df['behavior_type']>1,:])
从这段代码可以看出,.loc() 前面的部分是整个索引目标,括号内则是索引标签(参考loc英文解释的第二句,它支持布尔型索引)。通过这样简洁的代码,即可输出所有值为3或4的行。冒号表示从第一行到最后一行全部选取。
print(df.loc[df['behavior_type'].isin([3,4]),:]) 注意,这里的 isin([ ]) 既包含小括号也包含中括号,表示集合形式。
我们也可以利用 isin 来替代大于号,其原理相同:该标签下所有值为3或4的集合生成布尔数组,随后进行索引。
print(df[df['behavior_type'].isin([3,4])])提到 isin,我们发现还有一个更简单的方法,即直接索引。
问题二:我们需要提取“user_geohash”列中包含字母‘qo’的所有行。
print(df.loc[df['user_geohash'].str.contains('qo')])
想必你已经想到了,利用 loc 即可实现,只需在后面加上字符串 str.contains() 函数。
至此,上述问题均已解决。那么,如果我们想要索取特定的行或特定的列,该怎么做呢?
DataFrame列选取与切片操作
没问题,让我们继续深入探讨 loc 函数的用法。
假设 df 是一个 DataFrame,其列名分别为 A、B、C、D。
具体数据如下:
A B C D 0 ss 小红 8 1 aa 小明 d 4 f f 6 ak 小紫 7
DataFrame 中的属性是不固定的,空值默认显示为 NA。
一、选取标签为 A 和 C 的列,且选取后的类型仍为 DataFrame。
df = df.loc[:, ['A', 'C']]
df = df.iloc[:, [0, 2]]
二、选取标签为 C 且仅取前两行,选取后的类型仍为 DataFrame。
df = df.loc[0:2, ['A', 'C']]
df = df.iloc[0:2, [0, 2]]
聪明的你是否已经掌握了 loc 的用法?
总结
到此为止,关于利用 Python3 筛选 Excel 中特定行(行值满足某个条件或属于某个集合)的介绍就结束了。更多关于 Python3 筛选 Excel 特定行的内容,请搜索本站以前的文章或继续浏览下面的相关文章。希望大家以后多多支持本站!
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















