


Python Pandas中extract与contains方法实战解析

本文详细讲解Python Pandas库中extract和contains两个字符串处理方法的实际应用。通过具体代码案例,演示如何利用extract结合正则表达式从复杂字段中提取明细与规格,以及如何使用contains进行字符串模糊匹配与数据筛选,帮助开发者高效处理DataFrame中的文本数据。
extract方法的使用
一、extract方法的使用
extract函数的核心功能是对数据进行提取操作,在数据处理场景中,它通常用于从DataFrame的某一列中提取特定子串。
当某一列包含冗长且结构复杂的字段,而我们需要从中提取出关键信息时,extract方法便派上了用场。
接下来直接通过代码实例进行演示。
数据源
序号  姓名  服务卡卡号  消费地点  消费时间  理赔金额(元)  交易明细  数量
1  张三  8100001  我爱花钱连锁有限公司  2020/3/1 8:02  605  珍牡肾骨胶囊(珍泉)0.63g*48粒*3盒  1
2  张三  8100001  我爱花钱连锁有限公司  2020/3/1 8:02  1225  桂龙药膏(葛洪)202g*6瓶  1
3  张三  8100001  我爱花钱连锁有限公司  2020/3/2 10:58  27  胆宁片(上药牌)0.36g*60片/瓶  1
4  李四  8100002  我爱花钱连锁有限公司  2020/3/1 9:20  30  阿莫西林胶囊0.5g*24粒/盒  3
5  李四  8100002  我爱花钱连锁有限公司  2020/3/1 9:20  5  氨咖黄敏胶囊(康麦尔)12粒/盒  1
6  李四  8100002  我爱花钱连锁有限公司  2020/3/4 14:26  51  阿归养血口服液(中联)10ml*24支/盒  1
7  李四  8100002  我爱花钱连锁有限公司  2020/3/4 14:26  5  氨咖黄敏胶囊(康麦尔)12粒/盒  1
8  李四  8100002  我爱花钱连锁有限公司  2020/3/9 17:56  28  胆宁片(上药牌)0.36g*60片/瓶  1
9  李四  8100002  我爱花钱连锁有限公司  2020/3/19 11:19  56  柴石退热颗粒(德众)8g*6袋/盒  1
10  李四  8100002  我爱花钱连锁有限公司  2020/3/21 16:04  68  醒脾胶囊0.3g*30粒  1
11  李四  8100002  我爱花钱连锁有限公司  2020/3/31 10:00  60  小败毒膏(东方博爱)10g*8袋  1
12  王五  8100003  我爱花钱连锁有限公司  2020/3/1 10:43  114  枣仁安神液10ml*7支  1
13  王五  8100003  我爱花钱连锁有限公司  2020/3/17 10:40  118  益气维血颗粒(红珊瑚)10g*15袋  1
14  王五  8100003  我爱花钱连锁有限公司  2020/3/21 8:19  615  比卡鲁胺片(双益安)50mg*14s*2板  1
15  王五  8100003  我爱花钱连锁有限公司  2020/3/1 10:56  120  消痛贴膏(奇正)1.2g:2.5ml*10贴/盒  1
16  王五  8100003  我爱花钱连锁有限公司  2020/3/1 12:56  198  复方首乌地黄丸(修正)3g*10袋*3小盒  1
17  王五  8100003  我爱花钱连锁有限公司  2020/3/1 12:56  28  胆宁片(上药牌)0.36g*60片/瓶  1
18  王五  8100003  我爱花钱连锁有限公司  2020/3/1 13:53  256  河车大造丸(同仁堂)9g*10丸/盒  1
19  赵六  8100004  我爱花钱连锁有限公司  2020/3/1 14:52  7  复方氨酚烷胺片(新迪)12片/盒  1
20  赵六  8100004  我爱花钱连锁有限公司  2020/3/1 14:52  149  法莫替丁分散片20mg*36片/盒  1
21  赵六  8100004  我爱花钱连锁有限公司  2020/3/9 19:56  100  朱砂安神丸6g*10袋  1
22  赵六  8100004  我爱花钱连锁有限公司  2020/3/9 19:56  23  清热消炎宁片0.4g*24片/盒  1
23  赵六  8100004  我爱花钱连锁有限公司  2020/3/1 15:16  30  多酶片100s/盒  1
24  赵六  8100004  我爱花钱连锁有限公司  2020/3/1 15:16  1139  补肺丸(养无极)9g*10丸*16板  1
25  赵六  8100004  我爱花钱连锁有限公司  2020/3/5 17:25  170  补肾益寿片(恒修堂)0.4g*100片  1
26  赵六  8100004  我爱花钱连锁有限公司  2020/3/5 17:25  800  益安宁丸72丸*2瓶(每18丸重3.1g)  1
27  赵六  8100004  我爱花钱连锁有限公司  2020/3/9 17:39  800  益安宁丸72丸*2瓶(每18丸重3.1g)  1
28  赵六  8100004  我爱花钱连锁有限公司  2020/3/11 17:30  480  七十味珍珠丸(甘露)1g*6s  1
29  赵六  8100004  我爱花钱连锁有限公司  2020/3/22 16:58  1154  双参龙胶囊45盒装0.3g*24s*45盒  1
30  杨七  8100005  我爱花钱连锁有限公司  2020/3/1 16:54  100  朱砂安神丸6g*10袋  1
31  杨七  8100005  我爱花钱连锁有限公司  2020/3/12 20:53  14  消痔灵片0.3g*24片  1
32  杨七  8100005  我爱花钱连锁有限公司  2020/3/18 10:04  402  回元堂 固本回元口服液 20ml*24瓶20ml*24瓶  1
33  杨七  8100005  我爱花钱连锁有限公司  2020/3/21 11:18  847  伏立康唑分散片(复锐)0.2g*6s  1
34  杨七  8100005  我爱花钱连锁有限公司  2020/3/1 17:36  30  多酶片100s/盒  1
代码实现
此处通过Jupyter Notebook分步展示执行过程。初次接触本文的读者若对Jupyter不熟悉,可将后续所有输出语句替换为print()函数以查看结果。
#%%

import pandas as pd
import re

#需求:
# 1. 把交易明细分成明细跟规格两列并删除交易明细这列
# 2. 明细中把例如珍牡肾骨胶囊(珍泉)的作为明细,0.63g*48粒*3盒作为规格拆分提取

#读取源数据
df = pd.read_excel("./datas/extract案例演示数据.xlsx")

#%%
#提取交易明细这一列
get_column = df["交易明细"]

#通过正则提取数据(?P<名字>)为固定写法给数据加新列名
df01 = get_column.str.extract(R"(?P<明细>[\u4E00-\u9FA5]+\(*[\u4E00-\u9FA5]+\)*)")
df02 = get_column.str.extract(R"(?P<规格>(?:0.|\w*)\w*\*\w*[\u4e00-\u9fa5](?:\S+|))")

#%%
#通过join函数合并2个DataFrame
join_data = df01.join(df02)
join_data
#%%
#删除原有交易明细数据
del df["交易明细"]
df
#%%
#二次合并,删除后交易明细的dataframe合并拆分后数据的dataframe
two_join = df.join(join_data)
#%%
#因为合并后存在排序问题,列名为汉字所以我通过loc方法进行的列名指定排序
#loc方法这里不再讲解,请参照loc,iloc篇章

result = two_join.loc[:,["序号","姓名","消费地点","消费时间",
     "理赔金额(元)","明细","规格","数量"]]
result

#%%
#输出到Excel
result.to_excel("./datas/extract_结果.xlsx",index=False)
print("文件写入完毕!!")
#%%
运行结果
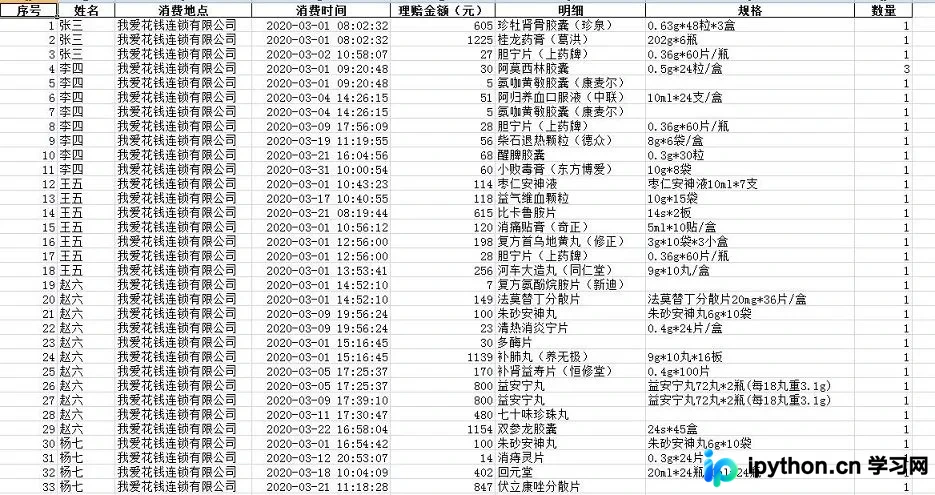
contains方法的使用
二、contains方法的使用
与extract侧重于提取不同,contains更多用于数据筛选,其逻辑类似于Python中的in运算符。
只要DataFrame的指定列或行中包含查询字符串的片段,即可匹配出所有相关数据。支持直接传入字符串,也支持使用正则表达式进行更复杂的筛选。
数据源
学员编号  学生姓名  学生年龄  手机号码  E-mail地址  家庭住址
101  刘鹏  18  13599713364  www.zhangsan@qq.com  江苏省苏州市工业园区津梁街
102  李四  20  15923796671  www.lisi.163.com  北京市朝阳区西北路石井街22幢
103  赵五  17  18655301183  www.zhaofive.yahoo.com  山东省烟台市芝罘区北大街55号
104  tony  30  15877563321  www.tonyliu.ibm.com  江苏省苏州市姑苏区山塘街177号
105  马云  47  15977560013  www.mayun.alibaba.com  浙江省杭州市西湖路110号1888
106  Jack  20  13677569901  www.jack123@qq.com  广东省深圳市南山区西丽1592幢12
107  tom  19  18622349971  www.tom456@qq.com  山东省青岛市人民路1234幢
代码:此处同样通过Jupyter分步展示结果
#%%
import pandas as pd
import re
df = pd.read_excel("./datas/Person_info1.xlsx")
#%%
#传入正则匹配只要包含的数据
df.loc[df["家庭住址"].str.contains(r"\d")]
运行结果
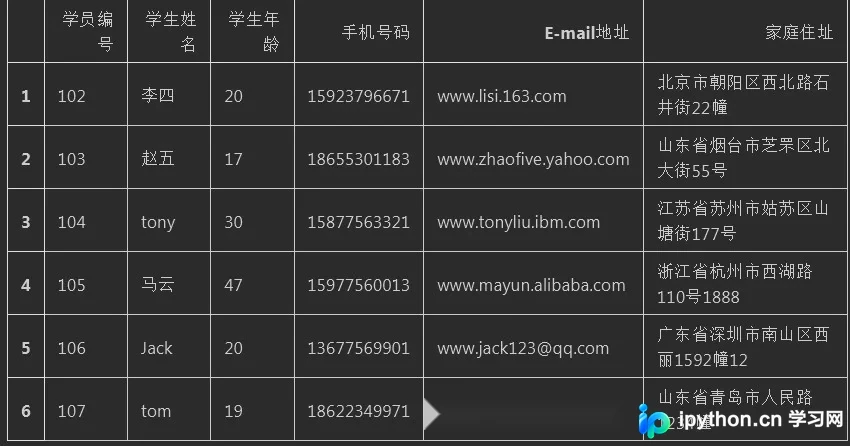
通过字符串进行数据筛选
#%%
#传入字符串,contains属于模糊查找.只要包含就筛选
df.loc[df["家庭住址"].str.contains(r"津梁街")]
#%%
df.loc[df["家庭住址"].str.contains("江苏省")]
运行结果
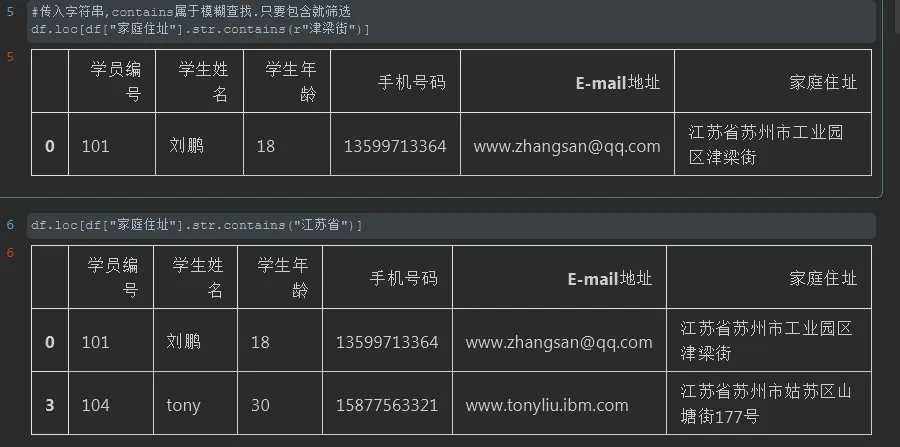
此外,contains方法可以连续多次调用。由于涉及敏感数据,复杂场景未完全展示。读者可先基于上述简单数据,尝试先过滤出家庭地址,再进一步筛选年龄。
当然,也可以结合loc中的掩码机制进行过滤,方法多样,建议灵活运用。
以上就是本文的全部内容,希望能为各位的学习带来帮助,也欢迎大家继续支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















