


Python CategoricalDtype自定义排序实现原理解析

本文解析如何利用Python Pandas中的CategoricalDtype实现中文列的自定义排序。通过定义Category类型并指定categories列表顺序,可解决默认UTF-8编码排序不满足需求的问题。结合pivot_table透视表,灵活展示按特定逻辑(如舱位等级)排序的数据,提升数据清洗与展示效率。
CategoricalDtype自定义排序
CategoricalDtype自定义排序
透视表生成后,通常需要对特定列或行进行排序。Pandas提供了sort_index和sort_values等函数用于常规排序,此处不再赘述。
数值和字母的排序较为直观,但中文排序往往存在困难。默认情况下,系统依据UTF-8编码进行排序,这通常无法完全符合实际业务中对汉字排序的特定需求。因此,利用CategoricalDtype将数据类型转换为Category类型是解决该问题的有效途径。
通过指定参数列表的顺序,可以自定义元素的排列优先级。元素的先后顺序完全取决于其在列表中的位置,这极大地简化了中文排序的操作难度。
代码实现与数据生成
具体实现代码如下:
1. 自动生成DataFrame数据
#%%

import pandas as pd
from datetime import datetime

city =["上海","北京","深圳","杭州","苏州","青岛","大连","齐齐哈尔","大理","丽江",
     "天津","济南","南京","广州","无锡","连云港","张家界"]

#创建自动从list中选取valuse值的get_list函数
#replace=True代表允许选出的元素重复
def get_list(items,size=20):
  return pd.Series(items).sample(n=size,replace=True).to_list()

#通过get_list自动生成数据,最终生成一个DataFrame
df = pd.DataFrame({
   "城市":get_list(city),
   "仓位":get_list(["经济舱","商务舱","头等舱"]),
   "航线":get_list(["单程","往返"]),
   "日期": get_list([datetime(2020,8,1),datetime(2020,8,2),
           datetime(2020,8,3),datetime(2020,8,4)]),
   "时间": get_list(["09:00 - 12:00",
            "13:00 - 15:30",
            "06:30 - 15:00",
            "18:00 - 21:00",
            "20:00 - 23:20",
            "10:00 - 15:00"]),
   "航空公司": get_list(["东方航空","南方航空","深圳航空","山东航空","中国航空"]),
   "出票数量":get_list([10,15,20,25,30,35,40,45,50,55,60]),
  })
#%%
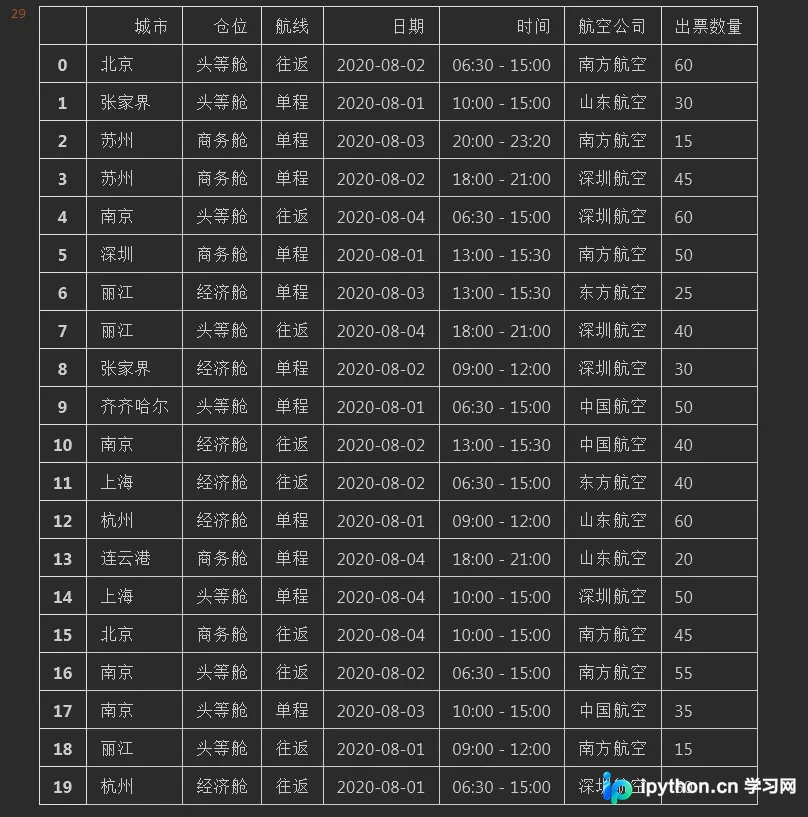
df
运行结果如下:
2. 查看数据类型
#%%
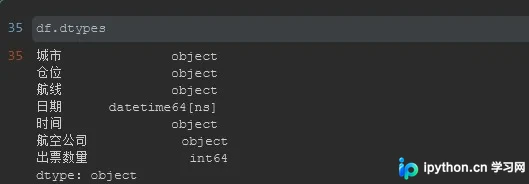
df.dtypes
自定义排序与透视表应用
3. 自定义数据类型(Category)按照指定顺序排序,并通过透视表展示数据
#%%
#自定义type,以及自定义排序的顺序
my_type = pd.CategoricalDtype(
  categories=["头等舱","商务舱","经济舱"],
  ordered=True
)
df["仓位"] = df["仓位"].astype(my_type) #将指定列转成自定义的type
df.dtypes
#%%
#通过透视表统计数据
tb = pd.pivot_table(
  df,
  index=["城市","仓位","航线","日期","时间"],
  values="出票数量",
  aggfunc=sum
)
tb
首先检查数据类型,可见“仓位”列的数据类型已由Object转换为category类型。
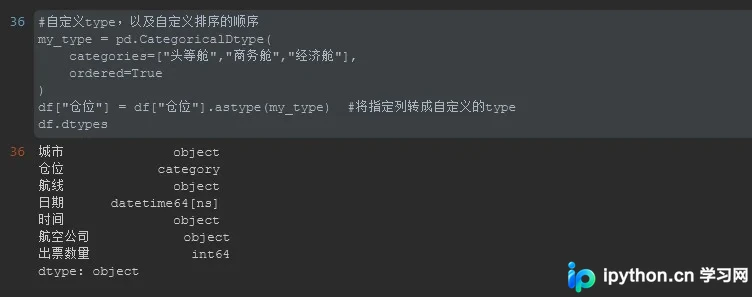
输出结果为:
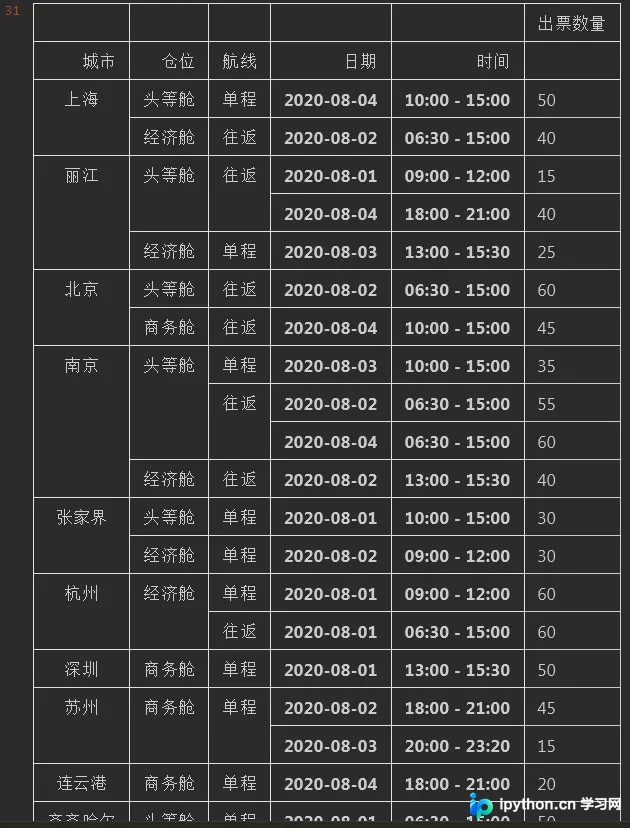
分析上述数据可知,我们将“仓位”列按照["头等舱","商务舱","经济舱"]的顺序进行了定义和排序,最终结果严格遵循该顺序排列,成功实现了中文列的自定义排序需求。
利用Pivot_table函数可以更清晰地展示原始数据,同时支持根据需求筛选部分数据进行展示。这种处理方式使得数据清洗及展示过程更加灵活。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















