


Python处理中文输入的两种核心方法

本文介绍Python中处理中文输入的两种主要应用方案。首先通过添加编码声明解决脚本层面的编码问题;其次针对print输出和函数输入(如raw_input),分别演示使用unicode()函数配合UTF-8或GBK编码进行转码的具体方法,确保中文在打印和控制台交互中正确显示。
Python中文输入处理概述
针对Python中中文输入与显示的问题,主要涉及两种应用场景的解决方案。
在Python脚本文件头部添加语言编码声明,格式为“-*- coding: uft-8 -*-”,以指定文件编码。
Print输出中文的解决方案
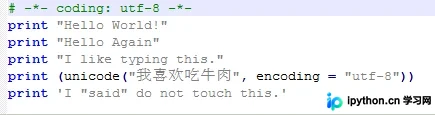
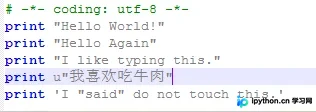
应用场景一:解决print语句输出中文时的编码问题。
方法一:利用unicode()函数进行转换,指定编码为UTF-8,语法为 unicode('字符串', encoding = 'utf-8' ) 或 unicode("字符串", encoding = "utf-8" )。
方法二:在字符串前添加前缀u,即使用 u'字符串' 或 u"字符串" 的形式定义Unicode字符串。
函数输入中文的编码处理
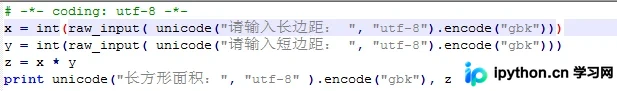
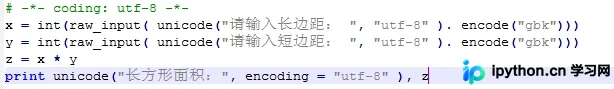
应用场景二:解决函数输入环节中的中文处理,例如使用raw_input()接收用户输入时的编码问题。
处理方式:先通过unicode('字符串', 'utf-8' ) 将输入转为Unicode对象,再调用 .encode( 'gbk' ) 编码为GBK格式;或者使用 unicode("字符串", "utf-8") . encode( "gbk" ) 的方式。
方法一:使用unicode()进行转码,并明确声明源编码为gbk,从而对后续文字打印统一应用该声明。
方法二:同样使用unicode()转码并声明为gbk,但在打印文字时指定输出编码为utf-8即可,无需强制强调输入时的gbk编码属性。
以上内容详细阐述了Python中输入中文的实例方法,更多关于Python中文处理的技术资料,请参阅本站其他相关文章。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















